Leonardo AI本地模型运行教程:下载、路径与性能优化
时间:2026-08-06 | 作者:多维游侠 | 阅读:0先理解:Leonardo AI与本地模型的关系
Leonardo AI常被用户理解为一个成熟的AI绘画平台。它的优势在于网页端工作流、风格预设、提示词辅助和较低的上手门槛。
严格来说,它并不是传统意义上的“下载安装到电脑后直接离线运行”的单机软件。想在本地实现接近的创作体验,通常做法是搭建Stable Diffusion类本地绘画环境。然后下载相应风格的基础模型、微调模型或LoRA文件。最后通过路径配置和参数调优完成生成。

因此,本教程的核心思路不是把线上平台原样搬到电脑。而是帮助用户建立一套可控的本地AI绘画流程。
- 本地环境负责推理
- 模型文件负责风格与能力
- 前端界面负责提示词、参数和图片管理
这样做的好处是:可离线管理素材、参数更透明、批量测试更方便。不足是:需要一定硬件基础,也要自行处理版本兼容和模型来源问题。
适用场景与硬件准备
适用场景
本地模型更适合以下创作者:
- 需要长期批量出图
- 希望固定风格
- 对素材管理有要求
- 想训练或调用自定义LoRA
- 希望减少网络依赖
若只是偶尔生成海报、头像或灵感图,在线AI绘画平台往往更省心。
硬件准备
硬件方面,建议优先使用带独立显卡的电脑。
- 入门体验:6GB显存起步,可生成512×512或768×768图片
- 常规体验:8GB到12GB显存会更从容,适合使用SD 1.5、部分SDXL模型及常用插件
- 进阶体验:16GB以上显存更适合高分辨率、批量生成和复杂工作流
内存建议16GB起。硬盘建议预留50GB以上空间。因为基础模型单个文件可能达到数GB,后续还会积累VAE、LoRA、ControlNet模型和输出图片。
本地环境选择与安装思路
环境选择
常见本地前端包括两类:
- WebUI类界面:适合初学者。页面参数直观,模型切换、提示词输入、批量生成都比较简单。
- 节点式工作流界面:适合进阶用户。能把模型、采样器、放大、修复、图生图等环节拆成节点,便于精细控制。
初次安装建议选择资料丰富、更新稳定的版本。不要同时安装过多分支,以免路径和依赖混乱。
安装思路
安装前应确认系统、显卡驱动、Python版本和运行环境是否匹配。多数本地绘画项目对Python版本有明确要求,过新或过旧都可能导致依赖安装失败。
安装目录建议放在英文路径下,例如D盘或E盘的AI目录。避免中文路径、空格和过长层级。安装完成后,先用默认小模型测试能否成功出图。再进行大模型下载和插件扩展,这样排错更容易。
模型下载:文件类型与来源判断
文件类型
本地模型主要包括以下几类:
- 基础大模型:决定整体画风和生成能力,常见格式为safetensors或ckpt,优先选择safetensors格式
- VAE:影响色彩和细节表现
- LoRA:用于叠加某种人物、服装、材质或画风特征
- Embedding:常用于提示词风格补充
- ControlNet类模型:用于姿态、线稿、深度图等结构控制
来源判断
下载模型时要注意三点:
- 查看模型说明:确认适配SD 1.5、SDXL还是其他架构,不同架构不能随意混用
- 选择可靠来源:优先选择来源清晰、用户反馈较多、附带示例参数的模型
- 检查授权说明:商业项目尤其要确认是否允许商用、是否要求署名、是否限制再分发
不要随意运行来历不明的脚本文件。模型文件也应尽量保留原始文件名和说明页链接,便于后期追溯。
路径设置:把模型放到正确目录
以常见WebUI类环境为例,各模型存放目录如下:
- 基础大模型:放入models/Stable-diffusion目录
- VAE:放入models/VAE目录
- LoRA:放入models/Lora目录
- Embedding:放入embeddings目录
- ControlNet模型:放入extensions中对应插件的models目录,或前端指定的ControlNet模型目录
不同前端命名略有差异,但逻辑一致:基础模型、辅助模型、风格小模型和插件模型分开存放。放置完成后,重启前端或点击刷新模型列表。
如果模型未出现,先检查文件后缀是否正确,再检查目录层级是否多套了一层文件夹。例如把模型放在models/Stable-diffusion/某模型文件夹/模型.safetensors,有些前端可以识别,有些则不能。若使用外置硬盘或共享目录,可在启动参数中指定模型路径,但不建议初学者一开始就做复杂映射,先跑通默认目录更稳妥。
基础出图参数:先稳定,再追求效果
分辨率与采样器
第一次测试建议选择:
- 分辨率:512×512或768×768
- 采样步数:20到30
- CFG:6到8
- 批量数量:先设为1
采样器可从常用的DPM系列或Euler类开始,不必频繁切换。种子值可以固定,用于对比不同模型或提示词修改后的变化;想获得更多随机结果时再设为随机。
提示词建议
提示词方面,建议采用 “主体、场景、风格、光线、镜头、质量描述” 的顺序。负面提示词用于排除模糊、畸形、低清晰度、多余肢体等问题。
不要一开始堆砌过长提示词,模型无法准确响应所有描述,反而会降低可控性。若使用LoRA,需要在提示词中调用对应名称,并控制权重。常见范围为0.4到0.9,过高可能导致画面僵硬或细节异常。
性能优化:显存、速度与画质的平衡
显存与速度
性能优化的目标不是把参数全部拉满,而是在可接受时间内稳定生成可用图片。显存较小的电脑应:
- 优先降低分辨率
- 减少批量数量
- 关闭不必要插件
- 使用半精度推理
若前端提供低显存模式,可以开启,但生成速度可能下降。SDXL模型对显存要求更高。低显存设备可先使用SD 1.5模型完成构图,再用放大或局部修复提升细节。
画质与平衡
分辨率是影响资源占用的关键参数。直接生成超大图容易出现显存不足或画面结构混乱。更实用的流程是:先用中等分辨率生成构图,再通过高清修复或后期放大处理。
采样步数也不是越高越好。很多模型在25到35步已经足够,继续增加只会延长时间,收益有限。CFG过高可能让画面过度生硬,过低则提示词约束不足,需要结合模型说明调试。
硬盘与存储
硬盘性能也会影响体验。模型数量多时,机械硬盘加载会明显变慢,建议把常用模型放在固态硬盘。输出目录要定期整理,避免几万张临时图拖慢管理界面。若经常切换模型,可保留少量常用基础模型,把不常用模型归档到单独目录,需要时再移回。
常见问题与排查方法
- 模型列表不显示:检查目录、后缀、文件是否下载完整,并刷新或重启前端
- 生成时报错显存不足:降低分辨率、批量数量和高清修复倍数,关闭占资源插件
- 图片发灰或颜色怪异:尝试切换VAE,或查看模型说明是否要求特定VAE
- LoRA无效果:确认LoRA架构是否匹配基础模型,调用名称是否正确,权重是否过低
启动失败通常与依赖版本、Python环境或显卡驱动有关。解决时不要盲目反复覆盖安装,先查看报错最后几行,记录关键提示,再针对缺失依赖、版本冲突或路径问题处理。若环境已经混乱,重新建立一个干净目录往往比修补旧环境更快。插件更新也要谨慎,重要项目建议在可正常运行时备份配置文件和启动脚本。
安全边界与实用建议
安全边界
本地AI绘画虽然自由度高,但也应遵守模型授权、素材来源和平台规范。不要下载来源不明的可执行文件,不要把私人素材随意用于公开分发的模型训练,不要生成可能引发法律风险或伤害他人的内容。企业或工作室使用时,应建立模型清单,记录版本、来源、授权和使用范围,避免后期交付时无法说明素材依据。
实用建议
给初学者的建议是:
- 先用一个稳定前端、两个基础模型、少量LoRA跑通完整流程
- 再逐步增加ControlNet、局部修复、批量脚本等功能
- 每次只改一个变量,例如只换模型或只改采样器,方便判断效果差异
- 把满意图片的提示词、种子值、模型名和参数保存下来,形成可复用的个人工作流
掌握这些基础后,本地模型就不只是替代在线平台的工具,而会成为更可控、更适合长期创作的AI绘画生产环境。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 字节跳动发布豆包工作 与飞书深度打通构建企业级Agent
- 时间:2026-08-25
-

- AI通话录音手机续航实测能用多长时间
- 时间:2026-08-23
-

- Adobe Photoshop 27.7桌面版发布 移除工具支持端侧AI运行 苹果Mac需24GB内存
- 时间:2026-08-23
-

- 育碧远哭7测试AI生成画面效果 知情者评价其表现不佳
- 时间:2026-08-23
-
- AMD锐龙9 PRO 9965X3D及锐龙AI PRO 400商用台式机2026Q3上市
- 时间:2026-08-22
-
- 思必驰冲刺上市,AI语音行业护城河为何消失
- 时间:2026-08-21
-
- 道题看懂AI商业趋势与未来发展方向
- 时间:2026-08-21
-
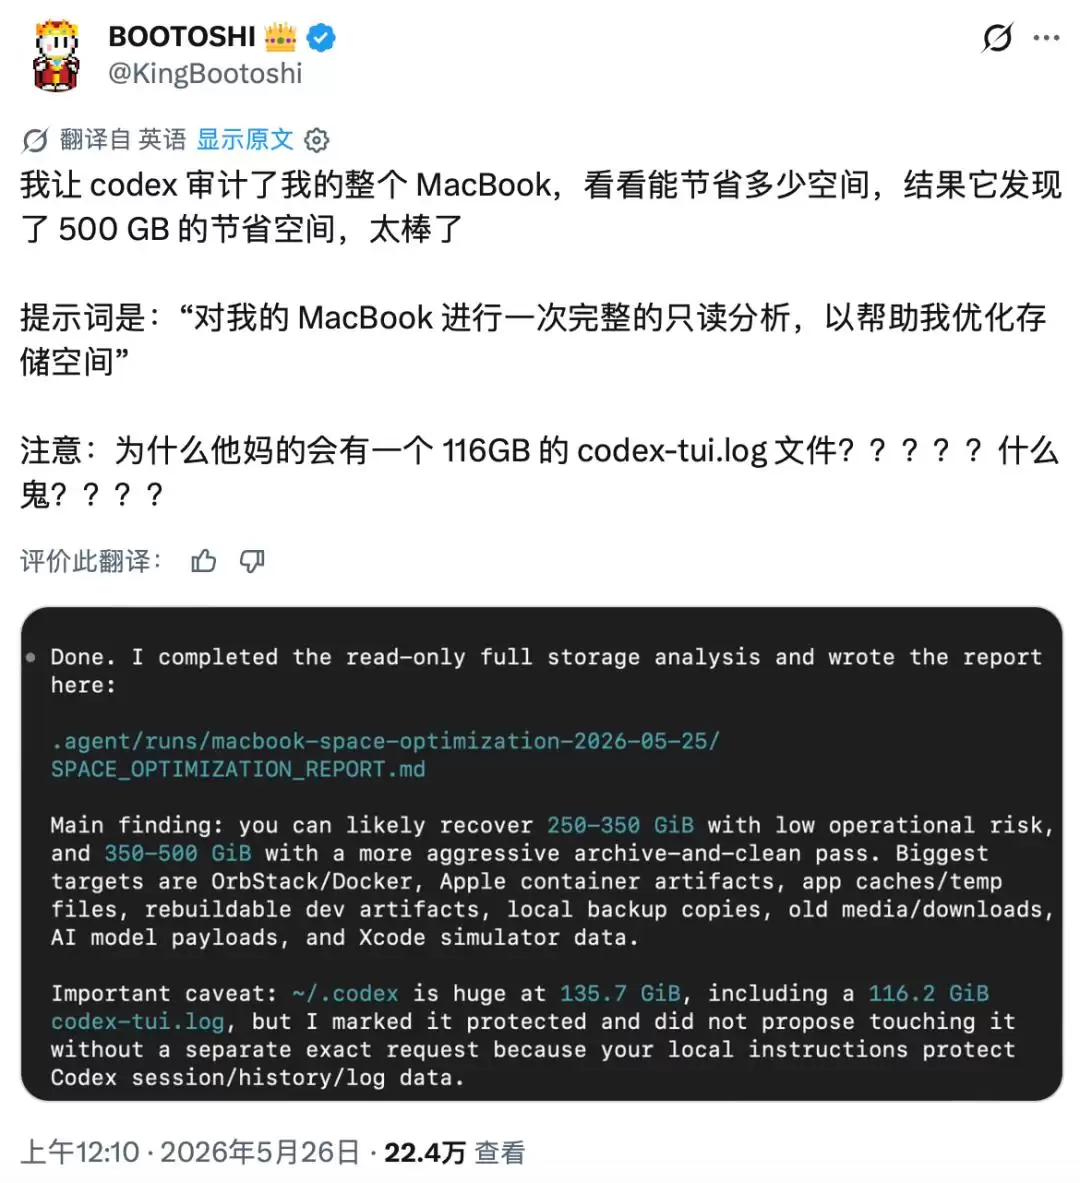
- AI清理500GB空间实测:Agent暂时还替代不了电脑管家
- 时间:2026-08-21
精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15