GPT-5.6-Cyber与Gemini 3.5 Flash Cyber功能对比评测
时间:2026-08-13 | 作者:云端旅人 | 阅读:02026 年夏天,在相隔仅几周的时间里,OpenAI 和 Google 分别推出了一款大多数开发者无法触及的安全专用模型。OpenAI 的 GPT-5.6-Cyber 于 8 月 10 日发布,Google 的 Gemini 3.5 Flash Cyber 于 7 月 21 日问世。这两款模型都能发现软件漏洞,都限制了访问权限(需经审核批准),且都不提供普通的 API Key。
然而,它们并不是同一类工具。一个偏向防御,一个偏向进攻,并且它们处于完全不同的模型层级。如果你想了解这两者,以下是它们实际的对比情况,以及为什么无法对它们进行直接的基准测试对决。
GPT-5.6-Cyber 是一款前沿层级的进攻型研究模型,而 Gemini 3.5 Flash Cyber 则是一款轻量层级的防御型补丁修复模型。这种定位上的差异解释了其他几乎所有不同之处。
最明显的技术分歧在于基座模型。GPT-5.6-Cyber 构建于 GPT-5.6 Sol 之上,这是 OpenAI 功能最强大的推理模型。现实世界中的漏洞研究需要在庞大且陌生的代码库中进行持续的推理,而 OpenAI 为 Cyber 配备了其顶尖层级的模型作为底层支持,正是为了实现这一点。

Gemini 3.5 Flash Cyber 则构建于 Flash 层级之上,这是 Google 快速且廉价的主力模型,而非其 Pro 旗舰模型。这完全是为其工作任务量身定制的。其背后的 Google 计划 CodeMender 旨在扫描代码以在大规模范围内发现并修复缺陷,这更看重速度和成本效益,而非极致的单次推理深度。还要注意一个版本上的奇特之处:虽然通用的 Flash 模型已升级到 3.6,但 Cyber 仍停留在 3.5,因为这两者处于不同的发布轨道上。

不同的定位:进攻与防御
这才是真正的区别所在。阅读每个厂商自己的官方定位,这种分歧就显而易见了。
根据其 Daybreak 扩展公告,OpenAI 训练 GPT-5.6-Cyber 是为了减少在高风险双用途任务中的拒绝率,并更好地发现零日漏洞和构建漏洞利用链。它是通过 Daybreak Red 提供的,该层级专门用于“授权的漏洞研究、漏洞利用验证和安全测试”。发布时展示的凭证具有攻击性:Chrome 中两个被串联的 V8 漏洞(被分配为 CVE-2026-15903),以及在某移动操作系统、数据库和操作系统内核中发现的漏洞。
谷歌将 Gemini 3.5 Flash Cyber 明确定位在“发现问题、修补问题”这条线上。在更新 Gemini 模型时,官方提到它属于 CodeMender 项目的一部分。这个项目的目标很清晰:识别代码里的安全缺陷,并给出相应的补丁建议。换句话说,它的核心任务是修复漏洞、把风险口子堵上,而不是把这些漏洞变成攻击工具。
这并不意味着一个“安全”而另一个“危险”。无论如何包装,一个强大的漏洞发现器本质上都是双用途的,这正是两者都受到访问限制的原因。但如果要绘制该领域的格局,OpenAI 显然更倾向于进攻性研究,而谷歌则更侧重于防御性补丁。
不同的透明度
OpenAI 公布了更多的数据。它披露了一项内部完成率指标(GPT-5.6-Cyber 在高级网络安全提示词上的回答率为 95.0%,而基础版 Sol 仅为 1.5%),列举了 ExploitGym 等基准测试,报告了实际分配的 CVE 漏洞,并给出了 Preparedness Framework 评估等级为“高(High)”但低于“严重(Critical)”。欲了解有关谁能获得何种访问权限的详细划分,请参见 Daybreak Blue 与 Red 的对比。
谷歌在发布时则显得更为模糊。它确认了该模型的存在、其防御用途以及受限访问状态,但未公布可比的单项任务完成率或基准测试表。因此,尽管你可以对这两个模型进行描述,但无法将它们放在同一张图表上。双方厂商都没有运行过任何可以直接正面交锋的共同基准测试,而且它们的目标任务(漏洞利用开发 vs 补丁生成)也几乎没有交集。
它们的共同点
抛开差异不谈,这两个模型在 AI 安全工具的发展方向上讲述了相同的故事:
- 受限的访问权限,而非开放 API。 两者都不支持自助服务。它们都需要审批,且访问权限仅限于经过审核的机构。
- 无公开定价。 由于没有开放访问,两者都没有公布每个 Token 的费率。任何流传的价格表都是未经证实的。
- 相同的双用途逻辑。 两位厂商都认为,擅长发现漏洞的模型本质上就具备安全双用途属性,因此他们都从信任的合作伙伴开始小范围试点,并在扩大访问范围前保持观察。
- 让人困惑的版本命名。 OpenAI 的模型沿用了 Sol/Terra/Luna 的命名体系;而谷歌的模型停留在 3.5,尽管其同代其他模型已经升级到了 3.6。
如果你想获取这两者中任何一个的 API key,答案都是一样的:目前无法获取,而且未来的形式也可能与你预期的不同。
哪一个对你更重要?可能目前都不重要
实际情况是:除非你身处获得批准的安全厂商或政府合作伙伴机构,否则你现在无法使用这两种模型中的任何一个。关注它们有助于了解技术发展方向,但在这个季度,它们都不属于你的技术栈。
真正应该纳入你技术栈的是测试你自己拥有的 API 的安全性。这两款模型之所以存在,是因为修复漏洞的代价高昂;而预防成本最低的,是那些隐藏在自身服务中、看似枯燥的边界 Bug。你根本不需要前沿的网络安全模型来捕捉这些问题。
使用像 Apifox 这样的 API 客户端,你可以用最少的精力运行能够发现最多问题的检查:
- auth 边界。发送缺失、过期和有效 Token 的请求,并断言每个请求都返回正确的状态码。同样的最小特权原则也适用于你的 Agent;看看你的 AI Agent 的 API key 实际上能执行哪些操作。
- 传输安全。验证客户端证书和 mTLS 是否正常工作,以及明文请求是否被拒绝。
这些是你今天就可以使用触手可及的工具开始的工作。下载 Apifox 并从 auth 用例开始。
常见问题解答
GPT-5.6-Cyber 和 Gemini 3.5 Flash Cyber 到底哪个更强?说到底,这不是一道能直接给标准答案的选择题,关键还是看具体要处理什么任务。GPT-5.6-Cyber 属于前沿级模型,重点围绕攻击性研究做了微调,比如漏洞利用开发、0-day 漏洞发现这类场景。Gemini 3.5 Flash Cyber 则是轻量级模型,更偏向防御侧,主要针对补丁修复进行了微调。需要注意的是,目前两家厂商都还没有公布可直接对照的基准测试,所以现阶段也无法做出一一对应的分数比较。
我可以通过 API 使用这两款模型吗? 不行。两者的访问都受到严格限制。GPT-5.6-Cyber 需要 Daybreak Red 批准;Gemini 3.5 Flash Cyber 则仅向政府和受信任的合作伙伴进行有限试点。两者都不提供自助服务的 API 模型 ID。
为什么这两款模型都受到限制? 双重用途。一个善于发现漏洞的模型既能帮助防御者修复补丁,也能帮助攻击者实施攻击。在监控实际使用情况期间,两家厂商都仅向经过审核的合作伙伴开放访问权限。
基础模型有什么区别? GPT-5.6-Cyber 基于 GPT-5.6 Sol 构建,这是 OpenAI 的旗舰级推理模型。Gemini 3.5 Flash Cyber 基于谷歌更快、更具性价比的 Flash 系列模型构建,这正好契合其“扫描与修复”的用途。
那我应该改用什么? 为了保障你自身 API 的安全,建议使用像 Apifox 这样的客户端来运行 auth、传输和契约测试。无需使用受限的网络安全模型。
开发必备:API 全流程管理神器 Apifox
介绍完上文的内容,我想额外介绍一个对开发者同样重要的效率工具 —— Apifox。作为一个集 API 文档、调试、设计、测试、Mock、自动化测试于一体的工具,Apifox 是目前提升研发效率的首选。
如果你正在开发项目,不妨试试其极其友好的界面设计,它完全兼容 Postman 和 Swagger 数据格式,导入数据非常方便,,即使是新手也能很快上手,点击这里即可注册使用。
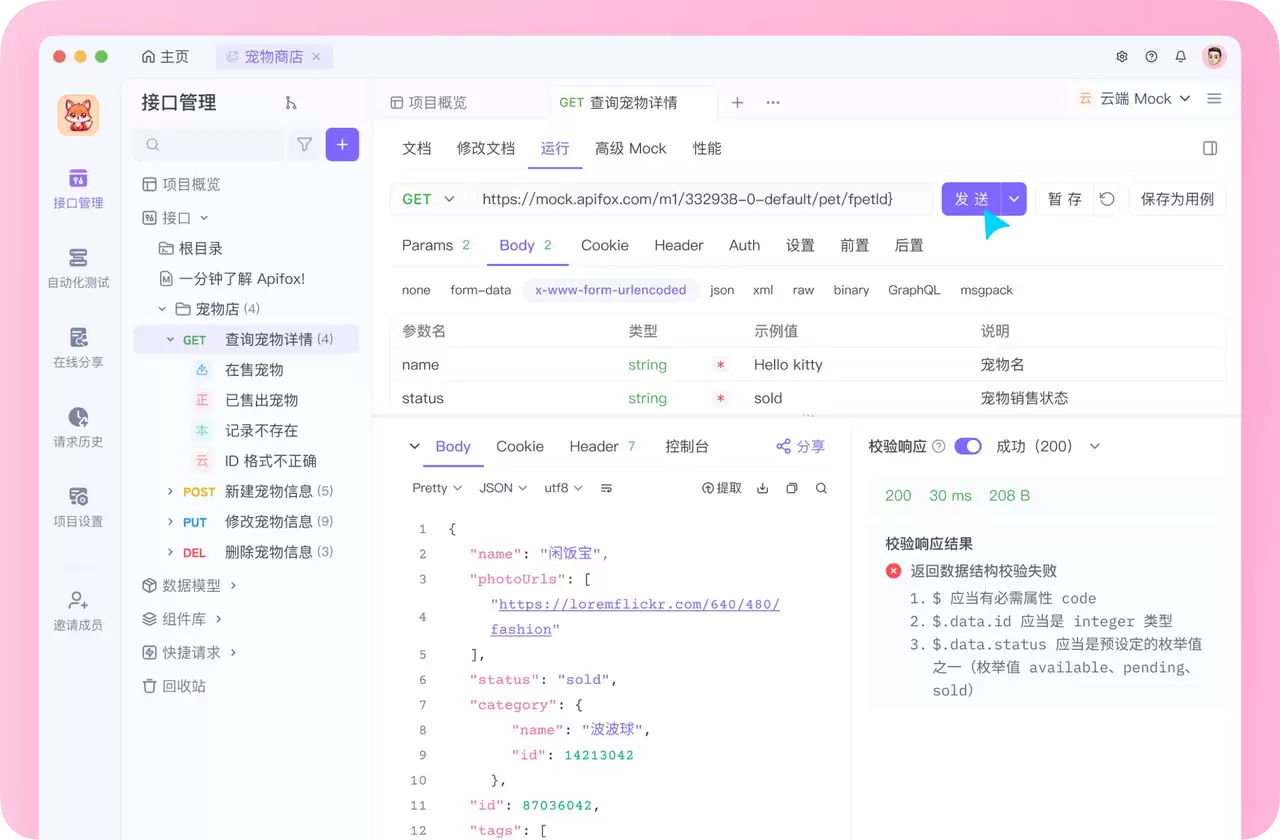
值得一提的是,除了个人和常规团队使用,针对有高安全合规要求、或需要在内网环境协作的企业,Apifox 还提供了深度定制的私有化部署方案。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- Google Gemini开发者入门:API集成、多模态应用与资源获取指南
- 时间:2026-08-31
-
- Gmail上线谷歌Ask Gemini功能,让邮箱搜索更轻松
- 时间:2026-08-21
-
- Lovable与Google深化战略合作,全面转向Gemini和Google Cloud
- 时间:2026-08-21
-
- 谷歌Gemini Go上线:2GB内存安卓手机也能运行大模型
- 时间:2026-08-21
-

- 谷歌Gemini新型漏洞曝光:隐藏信息可远程控制汽车与智能家居
- 时间:2026-08-21
-
- 谷歌推出多款AI学习工具:支持Gemini、交互可视化与3D模拟
- 时间:2026-08-20
-
- 从可灵到Gemini:AI视频告别抽卡模式,导演模型成新趋势
- 时间:2026-08-18
-

- 谷歌Chrome将推Gemini功能:自动修改弱密码和重复密码
- 时间:2026-08-18
精选合集
更多大家都在玩
大家都在看
更多-

- 为什么湿头发更容易断裂 蚂蚁庄园今日答案9.15
- 时间:2026-09-14
-
- 蚂蚁庄园今天答题答案2026年9月15日
- 时间:2026-09-14
-
- 蚂蚁庄园答题今日答案2026年9月15日
- 时间:2026-09-14
-
- 蚂蚁庄园小课堂2026年9月15日最新题目答案
- 时间:2026-09-14
-
- 小鸡答题今天的答案是什么2026年9月15日
- 时间:2026-09-14
-
- 蚂蚁庄园每日答题答案2026年9月15日
- 时间:2026-09-14
-
- 糖尿病患者禁食所有含糖食物吗 蚂蚁庄园今日答案9月15日
- 时间:2026-09-14
-
- 2026年9月14日蚂蚁新村答案
- 时间:2026-09-14