Spatial-TTT流式视觉空间智能框架:清华联合混元开源发布
时间:2026-08-15 | 作者:怪兽小助手 | 阅读:0Spatial-TTT是什么
先问一个问题:如果让AI看一段长达两小时的视频,然后问它“厨房水池的左边是什么”,它能答得上来吗?
这其实一直是个老大难。大语言模型虽然能懂文字、能看图,但面对连续的视频流,特别是长视频,往往会“看到后面忘了前面”。
清华大学、腾讯混元与南洋理工大学最近联合推出的Spatial-TTT,正是在解决这个痛点。
这个框架只有2B参数,但借助一种叫Test-Time Training(TTT)的技术,可以在观看视频流的过程中,持续更新内部的“空间记忆”。换句话说,它边看边记,而且能记整整120分钟。
在VSI-Bench、MindCube-Tiny等多个基准测试上,它的表现甚至超过了GPT-5、Gemini-3-pro这类闭源大模型,峰值显存占用比行业领先方案节省超过40%。
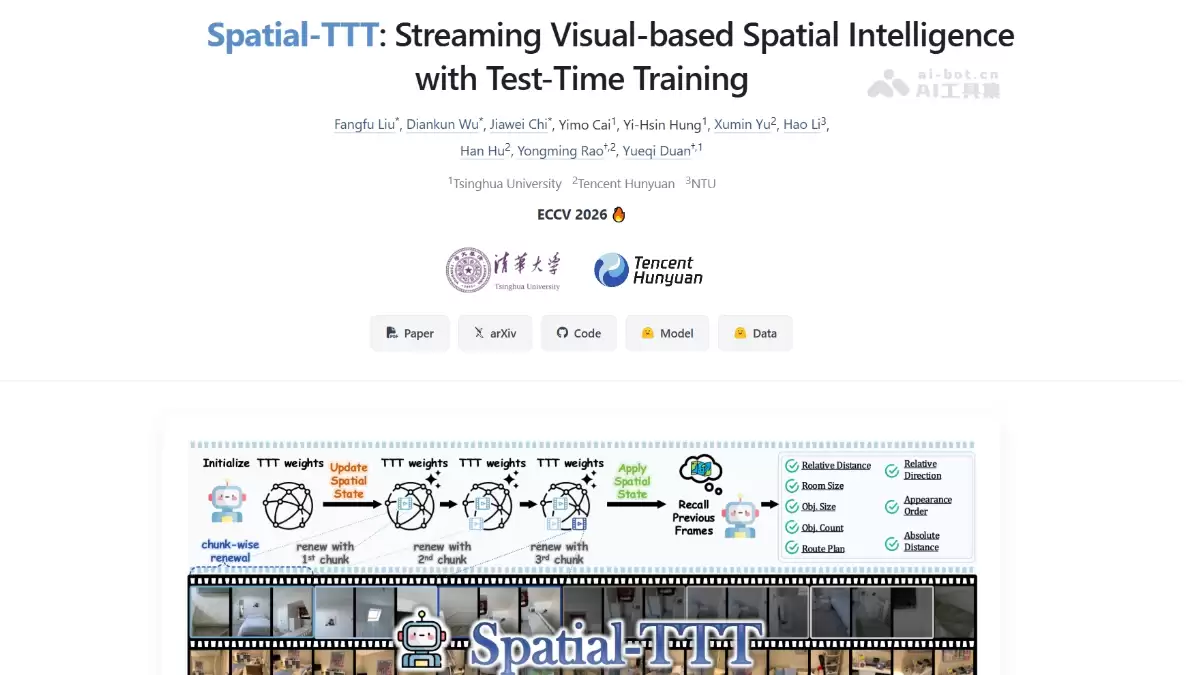
Spatial-TTT的主要功能
那么,这个框架具体能干什么?
- 流式空间记忆维护:视频流被切成小块,逐块输入。模型在线更新参数,用快速权重来存储,边看边累积3D空间证据,不用一次性把整段视频全装进“脑子”。
- 长时程空间推理:可以做相对/绝对距离估计、物体计数与大小判断、房间尺寸感知、方向识别、路径规划,甚至外观顺序推理。这些任务对空间理解的要求相当高。
- 超长视频处理:稳定处理10分钟到120分钟的连续视频流。在VSI-SUPER长期记忆基准上,性能几乎没有衰减。
- 高效推理:输入1024帧的情况下,峰值显存仅11.9GB,理论计算量799.4 TFLOPs——远低于同类大模型。
Spatial-TTT的技术原理
要理解它为什么能做到这些,需要看背后的技术细节。
这里有几个关键设计:
- 混合式TTT架构:研究团队在解码器里以3:1的比例交替插入TTT层和标准自注意力锚定层。75%的TTT层负责把长程空间信息写进快速权重,实现线性复杂度的记忆扩展;剩下25%的全注意力层则用来保留预训练模型的语义理解与跨模态对齐能力。这样既利用了TTT的长记忆优势,又不至于破坏原有的视觉-语言能力。
- 空间预测机制:传统的TTT用逐点线性投影生成Q/K/V,很容易忽略视觉token的局部几何结构。Spatial-TTT在TTT分支里引入了轻量级3D时空卷积,让快速权重学到的不是孤立token的映射,而是时空上下文到时空上下文的预测关系。这样一来,几何对应、视角变化和时间连续性都能被更稳定地捕捉。
- 稠密场景描述监督与渐进训练:现有空间智能数据大多是稀疏的局部问答,很难驱动快速权重学习全局更新。因此团队构建了涵盖全局语境、物体类别与数量、空间关系的稠密3D场景描述数据,采用两阶段渐进训练。第一阶段先通过稠密描述学习“记住整个空间”,形成全局3D意识;第二阶段再用数百万条空间VQA数据强化流式推理能力。
技术设计的重点
- 记忆能持续更新:不是简单拉长上下文,而是把空间信息写入内部状态。
- 保留原有多模态能力:通过混合注意力结构,避免长记忆机制破坏语义理解能力。
- 更适合空间任务:通过3D时空卷积,更稳定地建模几何关系和时间连续性。
如何使用Spatial-TTT
如果你想把Spatial-TTT用起来,流程大致如下:
- 环境准备:去GitHub仓库(https://github.com/THU-SI/Spatial-TTT/)克隆代码,配置好Python环境和依赖。
- 模型加载:加载预训练的Spatial-TTT-2B权重,初始化TTT快速权重。
- 输入视频流:把长视频切成连续的chunk,逐块输入模型。每处理完一个chunk,模型会自动更新内部空间状态。
- 空间问答:输入自然语言空间问题,比如“从红色蜡烛出发面向窗户,如何走到门口”。模型会基于累积的空间记忆生成答案。
- 扩展应用:可以接入机器人、自动驾驶或AR设备的实时视频流,实现持续空间感知。
Spatial-TTT的核心优势
相比同类技术,Spatial-TTT有几个非常突出的点:
- 小参数超越大模型:2B参数在多项空间基准上击败了GPT-5、Gemini-3-pro等闭源巨头。在MindCube-Tiny上,准确率领先Gemini-3-pro整整12个百分点。
- 线性扩展性:通过fast weights在线更新,显存与计算量随视频长度线性增长。这避免了传统长上下文模型那种平方级的复杂度爆炸。
- 空间记忆而非内容堆积:它不依赖无限膨胀的上下文窗口,而是把观察转化为可更新、修正和调用的内部空间状态。这种设计更适合物理Agent长期运行。
- 显存效率显著:1024帧场景下显存占用仅11.9GB,较行业领先方案(21.2GB)降低了超过40%。带显式几何编码器的对比模型在同等帧数下已经跑不动了。
一句话总结优势
参数更小、记忆更长、显存更省、空间推理更强。
Spatial-TTT的项目地址
- 项目官网:https://liuff19.github.io/Spatial-TTT/
- GitHub仓库:https://github.com/THU-SI/Spatial-TTT
- HuggingFace模型库:https://huggingface.co/collections/THU-SI/spatial-ttt
- arXiv技术论文:https://arxiv.org/pdf/2603.12255
Spatial-TTT的同类竞品对比
直接和目前最强的闭源模型Gemini-3-pro比一比,差距更直观:
| 对比维度 | Spatial-TTT | Gemini-3-pro |
|---|---|---|
| 参数规模 | 2B | 闭源,未公开 |
| 模型性质 | 开源(清华/腾讯混元/NTU) | 闭源(Google) |
| 核心机制 | TTT 快速权重 + 3D 时空卷积 + 混合注意力 | 长上下文 + 多模态预训练 |
| VSI-Bench 平均分 | 64.4 | 56.0 |
| MindCube-Tiny 准确率 | 76.2% | 63.9% |
| 120分钟视频处理 | 稳定运行(Recall 30.0 / Count 38.4) | 未公开支持,长视频易性能崩塌或 OOM |
| 1024帧峰值显存 | 11.9GB | 21.2GB+ |
| 1024帧计算量 | 799.4 TFLOPs | 1403.1 TFLOPs |
| 空间记忆方式 | 在线更新参数化空间状态 | 依赖长上下文窗口缓存 |
Spatial-TTT的应用场景
这项技术能用在哪些地方?想象一下:
- 机器人导航:服务机器人或家用机器人在房间里持续移动时,实时更新空间地图,能够回答“沙发相对于窗户的位置”,或者规划到达目标点的路径。
- 自动驾驶:车辆在长时程行驶中持续积累道路、路口与障碍物的空间关系,支持复杂的方向判断与距离估计。
- AR/VR 空间交互:头显设备在用户使用过程中持续理解环境布局,实现虚实融合的空间锚定与物体关系查询。
- 智能监控与安防:对长时间视频流进行在线空间分析,追踪物体出现顺序、计数与位置变化。不需要离线全量处理,可以实时响应。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 爱芯元智开源Magnetar一站式模型部署工具发布
- 时间:2026-08-21
-

- 沐曦股份完成阿里千问Qwen3.8-2.4T-A95B大模型Day 0适配
- 时间:2026-08-21
-

- 北大开源美学照片重构模型:废片一键变大片
- 时间:2026-08-21
-

- 腾讯与人大高瓴联合开源规划评测框架PlanningBench
- 时间:2026-08-20
-

- 苏州GEO系统开源部署实战:制造企业30天快速落地指南
- 时间:2026-08-18
-
- JimuChatBI v1.0发布:开源对话式Chat2BI智能问数产品
- 时间:2026-08-18
-
- 阿里云秒悟Meoo CLI开源工具一键部署上线指南
- 时间:2026-08-18
-
- 小米MiMo Code开源后Bug频发,5人2周做出5.1k星项目引热议
- 时间:2026-08-18
精选合集
更多大家都在玩
大家都在看
更多-

- 蚂蚁新村小课堂今日答案10月23日 江苏溧阳的跳幡神是一种
- 时间:2026-10-23
-
- 蚂蚁新村2026年10月23日答案最新
- 时间:2026-10-23
-
- 蚂蚁庄园答案2026年10月24日
- 时间:2026-10-23
-
- 蚂蚁庄园今天答题答案2026年10月24日
- 时间:2026-10-23
-
- 蚂蚁庄园今日答案2026年10月24日
- 时间:2026-10-23
-
- 秦始皇陵地宫至今未发掘,主要原因是 蚂蚁庄园今日答案10.24
- 时间:2026-10-23
-
- 小鸡答题今天的答案是什么2026年10月24日
- 时间:2026-10-23
-
- 蚂蚁庄园每日答题答案2026年10月24日
- 时间:2026-10-23