Boogu-Image-0.1:Boogu开源统一图像生成与编辑模型
时间:2026-08-15 | 作者:骑光打字机 | 阅读:0Boogu-Image-0.1是什么
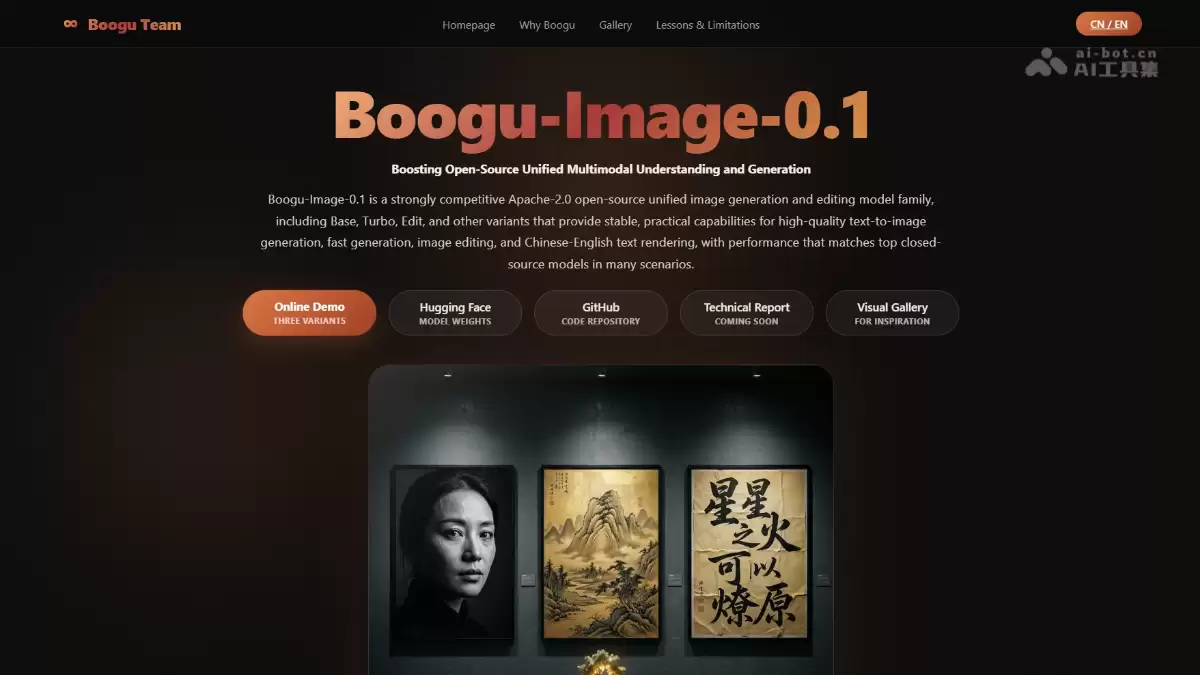
说到统一图像生成与编辑模型,最近Boogu团队开源的Boogu-Image-0.1系列确实值得关注。
这套模型家族在同一个架构下,同时实现了文生图、指令式图像编辑以及中英双语文本渲染。
家族中包含Base、Edit和Turbo三个变体,各自有不同的侧重。
在Boogu团队自建的Boogu Arena千级提示词ELO评测中,这个系列的表现位居所有参评开源与闭源系统的前列。而在Qwen-Image-Bench上,它更是拿到了开源模型第一的成绩。
Boogu-Image-0.1的主要功能
那么它到底能做什么?以下几个功能值得重点关注。
- 文生图生成:对摄影类提示词的理解相当精准,能够自动处理好自然光照、构图协调性,生成细节忠实、观感自然的高质量图像,尤其擅长复杂的真实场景还原。
- 指令式图像编辑:可以基于自然语言指令完成各种编辑操作。无论是插入、替换、移除物体,还是修改属性与材质、更换背景与场景,甚至跨艺术风格迁移,都能在保持原始主体与构图一致性的前提下完成。
- 中英双语文本渲染:这是它的核心亮点之一。海报、邮票、文档、UI界面、品牌指南这类文字密集型的视觉设计,它都能搞定,生成的文字具有可读性强、排版稳定的特点。
- 风格化生成:覆盖范围很广,从国风、像素风、绘本风到产品级渲染,应有尽有。对提示词比较敏感,但输出稳定度高,不会出现风格跑偏的情况。
- 海报与产品图优化:能够生成带有一致品牌风格、精致字体排印、专业灯光构图的个性化海报和产品可视化图像,电商方向非常实用。
- 图像内文本编辑:支持对图里的中英文字符进行替换、新增或删除操作,可以灵活调整字体、字重、颜色和布局,设计修改的效率大大提升。
Boogu-Image-0.1的技术原理
从技术角度看,这套架构的设计思路非常清晰。
统一多模态架构
统一多模态架构是核心。它将视觉理解与图像生成的能力整合在同一个模型框架里。
也就是说,模型既“看懂”了图像,又“画出”了图像。这种双向能力,为编辑任务提供了真正的语义级控制基础,不再是简单的像素级拼凑。
蒸馏加速推理
Turbo变体基于知识蒸馏技术打造。在参数量不变的前提下,它压缩了推理路径。
通常只需要3到4步,就能产出一张高质量的逼真摄影图像。更关键的是,它在加速的同时,双语文本渲染能力和提示词遵循度都没有缩水。
指令对齐编辑
Edit变体是10B参数的版本,在统一架构上针对图像编辑进行了专项优化。
通过指令对齐机制,它能够完成非常精细的局部修改,并且能最大程度保留原始主体和构图。
在做跨风格迁移或者内容替换时,不会出现传统编辑模型中常见的“整体重绘”失真问题。
双语文本渲染
模型在统一架构中完整嵌入了对中英文字符的结构化理解和生成能力。
通过版式感知机制,在海报、品牌物料这类文字密集的场景中,依然能保证可读排版和稳定的渲染输出,这一点很多模型都做不到。
如何使用Boogu-Image-0.1
使用方式很灵活,主要有以下几种选择:
- 在线体验:直接访问魔搭创空间的上线demo,上传图片、输入编辑指令就能用,完全不需要本地部署。
- 模型下载:通过ModelScope官方组织页面,可以获取Base、Edit、Turbo各个变体的完整权重。
- 本地部署:如果你有本地环境需求,GitHub仓库里已经提供了完整的训练和推理代码,按README配置好环境,加载模型就可以开始生成或编辑了。
Boogu-Image-0.1的核心优势
综合来看,这套模型有几个特别突出的点。
- 统一架构:一个模型家族覆盖生成、编辑、文本渲染三大任务,不用为了不同场景切换模型,流程极简。
- 极速推理:Turbo变体只要3到4步就能完成高质量生成,推理效率已经对标甚至超越部分闭源方案。
- 双语文本优势:在中文和英文文字渲染上表现都很稳定,尤其适合做中文海报和品牌物料的设计场景,这个方向目前开源模型里能做好的并不多。
- 编辑一致性:Edit变体在修改内容的时候,能高度保持原始主体与构图的一致性,避免了传统编辑模型中画风跳变、内容重绘的失真问题。
Boogu-Image-0.1的项目地址
相关资源可以直接从这些链接获取:
- 项目官网:https://boogu.org/
- GitHub仓库:https://github.com/boogu-project/Boogu-Image
- HuggingFace模型库:https://huggingface.co/Boogu
Boogu-Image-0.1的同类竞品对比
为了更直观地了解它的定位,这里和同样是国内开源模型的Qwen-Image-2.0做一个对比。
| 维度 | Boogu-Image-0.1 | Qwen-Image-2.0 |
|---|---|---|
| 发布方 | Boogu 团队 | 阿里巴巴通义团队 |
| 发布时间 | 2026 年 6 月 | 2026 年 2 月 |
| 开源协议 | Apache-2.0 | Apache-2.0 |
| 模型参数 | Edit 变体 10B;Base/Turbo 参数量与 Base 一致(未公开具体数值) | 扩散解码器 7B + Qwen3-VL 编码器 8B,合计约 15B 级别 |
| 核心架构 | 统一多模态理解与生成架构,将视觉理解与图像生成整合于单一框架 | 双组件架构:8B Qwen3-VL 视觉语言编码器 → 7B MMDiT 扩散解码器 |
| 统一能力 | 文生图、指令式图像编辑、中英双语文本渲染三合一 | 文生图、图像编辑、文本渲染统一于单一 7B 模型 |
| 最大分辨率 | 示例多为 1024×1024(支持更高,未明确上限) | 原生 2048×2048(2K),无需上采样 |
| 提示词长度 | 未明确公开上限 | 最高 1000 tokens |
| 文本渲染 | 中英双语,支持超密集文本、海报、品牌物料等复杂排版 | 中英双语,支持信息图表、PPT、海报、书法等,强调材质适配与结构化对齐 |
| 推理效率 | Turbo 变体仅需 3-4 步即可完成高质量生成 | 未明确优化步数,7B 轻量架构降低显存需求 |
| 本地部署 | 支持,通过 GitHub 与 ModelScope 获取权重和代码 | 支持,GitHub 开源,DiffSynth-Studio 支持 4GB 显存分层卸载 |
从参数和架构设计上看,两者的侧重点差异明显。
Boogu-Image-0.1的优势在于统一的单框架架构,把理解和生成能力整合在一起,编辑任务的一致性做得更好,并且Turbo变体的推理速度优势显著。
而Qwen-Image-2.0则在原生高分辨率输出和更长的提示词支持上占有优势。
Boogu-Image-0.1的应用场景
落到实际应用中,它的价值主要体现在以下几个方向:
- 电商设计:快速生成产品主图、详情页海报和多语言促销物料,支持基于参考图的风格统一与局部修改,极大提升设计效率。
- 广告营销:可以按照品牌指南直接生成中英双语海报和社交媒体配图,后续对已有素材做文案替换或布局调整也非常方便。
- 内容创作:面向短视频、自媒体等场景,提供风格化的插图、漫画分镜和meme图生成,尤其支持图像内文字精准编辑,创作自由度很高。
- 出版印刷:书籍封面、杂志排版、邮票和文档界面设计,这部分对文字的清晰度和版式的稳定性要求极高,它正好能胜任。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- Midjourney V8.2最新AI图像生成模型功能解析
- 时间:2026-08-13
-
- Google Earth上线Nano Banana 2图像生成功能一键生成AI场景与历史风貌
- 时间:2026-08-13
-
- 谷歌地球AI图像生成功能暂停 上线不足48小时加强安全防护
- 时间:2026-08-05
-
- Krea AI发布Krea 2首个从零训练基础图像生成模型
- 时间:2026-07-27
-
- 谷歌发布轻量级AI图像生成模型Nano Banana 2 Lite
- 时间:2026-07-26
-
- 谷歌发布Nano Banana 2 Lite模型,图像生成再提速挑战行业门槛
- 时间:2026-07-26
-
- 微软高精度图像生成模型MAI-Image-2.5-Pro
- 时间:2026-07-25
-
- 千问AI图像生成提示词编写技巧与教程
- 时间:2026-07-25
精选合集
更多大家都在玩
大家都在看
更多-

- 蚂蚁新村小课堂今日答案9月23日 火宫殿臭豆腐是哪个地方的非遗美食
- 时间:2026-09-23
-
- 蚂蚁新村2026年9月23日答案最新
- 时间:2026-09-23
-
- 蚂蚁庄园答案2026年9月24日
- 时间:2026-09-23
-
- 蚂蚁庄园今天答题答案2026年9月24日
- 时间:2026-09-23
-
- 蚂蚁庄园今日答案2026年9月24日
- 时间:2026-09-23
-
- 为什么大多数热水瓶的内胆是银色的 蚂蚁庄园今日答案9.24
- 时间:2026-09-23
-
- 小鸡答题今天的答案是什么2026年9月24日
- 时间:2026-09-23
-
- 蚂蚁庄园每日答题答案2026年9月24日
- 时间:2026-09-23