首次纯人类视频预训练VLA灵巧操作:少量数据微调即可部署
时间:2026-08-18 | 作者:白桃企划师 | 阅读:0实现具备人类水平的灵巧操作能力,是机器人学领域里一个令人振奋、但又极难攻克的“硬骨头”挑战。
多指灵巧手的硬件已经越来越成熟,但要让它们像人一样干活,难点仍然在数据。
高质量的机器人数据采集,往往需要耗费大量人力物力。以至于在所有视觉-语言-动作(VLA)模型里,数据规模一直是短板。
和大语言模型(LLM)与视觉语言模型(VLM)相比,机器人数据量级几乎不在一个层面上。这也直接限制了模型在真实复杂任务中的泛化能力。
微软亚洲研究院和清华大学近期联合发布了一项研究。论文《Scalable Vision-Language-Action Model Pretraining for Robotic Manipulation with Real-Life Human Activity Videos》提出了VITRA预训练框架,正面回应了这一痛点。

这项研究的核心思路很明确:能否构建一套全自动流程,把互联网上海量、无标注的真实人类活动视频,自动转化为机器人V-L-A模型可直接使用的数据?
团队给出了肯定答案。他们通过提取视频中的3D手部运动轨迹,进行原子级动作分割,并自动生成语言指令,最终构建了一个包含100万个片段、2600万帧的超大规模手部V-L-A数据集。
在此基础上,模型先在纯人类视频上完成预训练。随后进入从未见过的真实环境时,依然展现出相当不错的零样本(Zero-Shot)手部动作预测能力。
再结合少量真实机器人数据进行微调,就能在真实机器人上实现高成功率的灵巧操作,同时对新物体和新环境具备很强的泛化能力。
下面展开聊聊。
打通从人类视频到机器人数据的转化链路
最大的难题,在于如何填平非结构化人类视频与结构化机器人数据之间的鸿沟。
既需要高质量的动作标签,也需要精准的语言指令。那么,这条链路该如何建立?
研究团队构建了一套包含三大核心技术的完整体系,实现了从原始视频到V-L-A数据的无缝转化。

△
3D运动标注:精准恢复手部与相机轨迹
首先,要从单目、未标定、且相机可能移动的视频中,恢复精确的3D手部运动。这本身就是一个不小的挑战。
为此,他们提出了一种基于最新3D视觉技术的单目相机和手部姿态跟踪方法。
先通过背景光流判断相机状态并估计内参;
再结合深度视觉SLAM和深度估计模型跟踪相机姿态;
同时用手部重建模型提取每帧的3D手部姿态,包括手腕6D姿态和全关节角度。
最终,系统将这些信息整合起来,得到世界空间中的3D手部运动轨迹。
这套方法不仅提供了高精度动作标签,也为后续的动作分割和指令标注打下了基础。
原子级动作分割:基于速度极小值的自然切分
现有机器人V-L-A数据大多是短视距的原子级任务。因此,如何从长视频中精准切出这些片段,是关键问题。
研究团队发现,人类动作存在自然节奏。在动作切换期间,手部速度通常会发生变化,而速度极小值往往就是切换点。
于是,他们设计了一个简单但高效的分割算法:基于3D空间中手部移动速度的极小值进行切分。
通过检测世界空间中3D手腕轨迹的速度极小值,系统就能把长视频高效切成单一原子动作的短片段。整个过程无需任何额外人工标注,也不依赖额外模型推理。


指令标注:结合3D轨迹的精准动作描述
在语言指令生成上,团队将视觉语言模型(VLM)与3D手部轨迹结合了起来。
对于每个片段,系统会均匀采样8帧图像,并把手掌的3D轨迹投影叠加到图像上。随后,将这些带有轨迹高亮的图像输入给GPT-4。
系统提示其结合图像内容与轨迹信息,以祈使句形式描述指定手部的动作。
实验结果显示,这一方法效果显著。提供原子级视频片段并叠加3D手部轨迹后,GPT生成动作描述的准确性能够明显提升。
实现强大的零样本预测与真实世界泛化
基于自动构建的超大规模人类手部V-L-A数据集,团队设计并训练了一个VLA模型,专为灵巧操作而生。

△
1、结合VLM与扩散动作专家的模型架构
模型由VLM骨干网络(PaliGemma-2)和一个扩散动作专家(Diffusion Transformer,DiT)组成。
其中,VLM负责处理视觉观察、语言指令和相机视场角(FoV),并输出“认知特征”(Cognition Feature)。
扩散动作专家则接收该认知特征、当前手部状态以及带有掩码的噪声动作块,通过迭代去噪来预测未来的手部动作序列。
值得注意的是,模型采用了因果注意力(Causal Attention)机制处理动作去噪。这保证每个动作步骤的预测只依赖之前的动作,避免了零填充带来的干扰。
2、零样本手部动作预测:在未见环境中展现惊人能力
在完全未见的真实生活环境中,预训练模型展现出的零样本手部动作预测能力相当亮眼。

△
在抓取和一般动作预测的评估中,该模型显著优于仅在实验室环境下收集的数据(如EgoDex)上训练的模型,也优于使用原始人类标注数据训练的模型。
这充分说明,使用海量、多样化的真实生活视频进行预训练,确实能极大提升模型在复杂环境和未知物体上的泛化能力。
3、真实机器人灵巧操作:少量数据微调实现高效部署
为了在真实机器人上部署,团队将人类手部的动作空间与机器人灵巧手,比如Realman机器人配备星动XHAND1的动作空间进行了对齐。

△
只需要少量(约1.2K条)真实机器人遥操作数据,对预训练模型进行微调,就能在真实世界中执行抓取、放置、倾倒、清扫等多种灵巧操作任务。
实验结果表明,与未经人类VLA数据预训练的模型,或在其他数据集(如OXE、EgoDex)上预训练的模型相比,该方法在任务成功率上取得了显著提升。
面对未见过的物体和背景时,模型也表现出了卓越的鲁棒性。
VITRA真实世界部署的硬件核心支撑
VITRA框架为何能在真实机器人上实现出色的泛化能力?算法革新当然重要,但底层硬件同样关键。
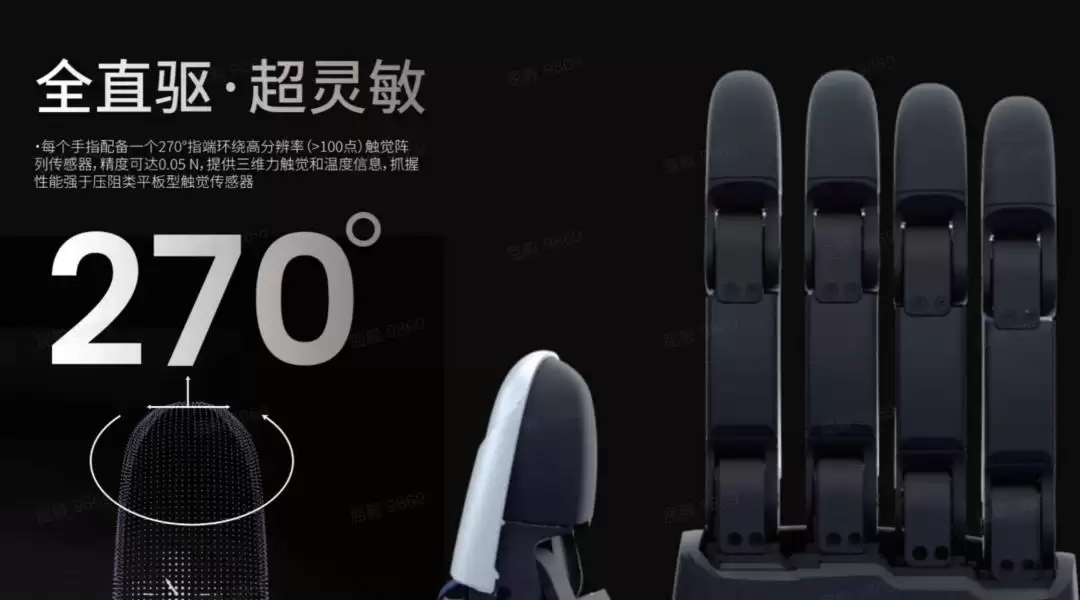
星动纪元自研的国内首创全直驱五指灵巧手星动XHAND1,正是这一能力的重要支撑。二者形成了高效的“软硬协同”。

△
高精度URDF与人类手部动作空间的无缝对接
VITRA框架的核心突破之一,在于将人类手部动作空间与机器人灵巧手的动作空间进行对齐。
星动XHAND1官方提供的URDF模型精度很高。不仅精确描述了运动和动力学参数,也完美映射了人类手关节的空间分布。
这种“数字孪生”级别的模型支持,让VITRA在微调阶段能够将人类关节角度精准映射到星动XHAND1的对应关节上。
这大幅降低了从人类视频到真实硬件之间的现实鸿沟,也确保了预训练策略能够在真实硬件上高效部署。
全直驱架构与高频响应:完美执行复杂灵巧操作
执行倾倒、清扫等复杂灵巧操作时,机器人需要极高的动态响应能力。
星动XHAND1采用的全直驱(Direct-Drive)电机架构,为这一算法提供了理想的硬件基础。
全直驱设计从根本上消除了传统减速器带来的摩擦、迟滞和非线性干扰,赋予灵巧手超灵敏的动态响应能力。
这使其能够瞬间且精准地执行VITRA模型输出的动作指令,并安全地操作各种未知物体。
丰富的传感器阵列:为未来多模态感知预留空间
虽然当前的VITRA模型主要依赖视觉输入,但星动XHAND1配备的丰富传感器阵列,如高分辨率触觉阵列,已经为未来的多模态感知预留了空间。
结合星动XHAND1强大的硬件感知能力,未来的VLA模型有望进一步融合触觉反馈,处理更精细、更复杂的“指尖步态(Finger Gaits)”任务。
数据规模的缩放定律
最后,研究还深入探讨了预训练数据规模对模型性能的影响。

△
实验发现了一个明显规律:随着预训练数据量增加,模型在零样本手部动作预测中的误差稳步下降,在真实机器人操作中的成功率持续上升。
这种清晰的缩放行为(Scaling Beha vior)表明,进一步扩大人类视频数据规模,有望持续提升VLA模型性能。
这项成果标志着,利用非结构化人类视频进行机器人VLA模型预训练,已经迈出了关键一步。
它通过一套全自动的数据转化方案,大幅降低了获取高质量机器人训练数据的门槛。
这不仅为多指灵巧手在更广泛、更加真实复杂的场景中应用铺平了道路,也为迈向真正泛化的具身智能打下了基础。
论文链接:https://arxiv.org/abs/2510.21571