SuperSonic 0.9.8版本更新发布内容详解
时间:2026-08-18 | 作者:半糖攻略君 | 阅读:0距离上个版本发布已经过去两个月,但不少用户早已从master分支提前尝鲜了新特性,也陆续提交了不少反馈和PR。
说实话,社区的力量确实让项目受益匪浅。0.9.8版本的核心关键词,其实可以概括为两个字:实用与灵活。

实用方面,从大模型连接到语义层,再到记忆管理和问答体验,多个模块都迎来了新特性和交互增强。
灵活方面,用户现在可以从更多维度定制自己想要的Chat BI环境。比如提示词、多轮对话策略、是否引入用户确认机制,甚至SQL修正和数据解读都能按需配置。
简单来说,SuperSonic的“可玩性”被拉高了一个档次,正在朝着更通用的Chat BI框架迈进。
大模型管理:告别“散装”配置
过去,大模型的连接配置要么在助理级别局部设置,要么在系统设置里全局搞定。
但问题也随之而来:同一个连接怎么让多个助理复用?不同场景下怎么切换不同的大模型?以及,每个场景的提示词如何做到差异化定制?
问题主要集中在三个方面:复用、场景选择和提示词定制化。
新版本对这块做了重构。交互上最直观的变化,就是新增了一个独立的大模型管理模块,跟数据库管理并列。
在助理管理下,则新增了大模型配置模块。用户可以为不同场景选择一个大模型连接,顺手还能把提示词也一并调整了。
Dify连接器:社区呼声的直接回应
有不少社区用户已经用Dify搭建了AI应用工作流,他们希望SuperSonic能直接通过Dify来对接大模型。
这个需求很明确,新版本就在接口协议中加入了DIFY类型。
维度管理:终于能“管”了
维度值本质上是企业的私有知识库。SuperSonic一直支持从数据库自动导入维度值来构建词典。
但问题是没有提供管理界面。导入之后,用户完全不知道该怎么搜索、编辑或者维护。
新版本升级了维度管理界面,让导入、搜索、编辑这些操作变得顺手多了。
记忆管理:手动注入,冷启动不难
0.9.4版本引入的记忆抽象,说白了就是把历史成功的QA转成未来的few-shot提示词。这是增强大模型生成能力的主要手段之一。
理论上,它能让助理实现“持续打怪升级”。
但问题来了:如果记忆完全依赖用户的实际问答,那就意味着在冷启动阶段,助理根本没有记忆可用。
之前的解决方式是配置一些示例问题,让系统后台自动触发问答来填充记忆。这算是一种间接手段。
但有些专业用户希望能直接手动注入记忆。新版本就加入了手动新增录入的功能。
需要提醒的是,Schema映射和语义S2SQL的录入有特定格式,建议参考系统自带的s2-exemplar.json案例。
语义S2SQL:WITH子句加持,场景更广
SuperSonic的核心理念是融合Headless BI和Chat BI。
具体到查询流程,就是一条路径:用户自然语言 → 语义S2SQL → 数据库SQL。
通过语义层做中转,好处是显而易见的:
- 既能充分利用数据语义信息来增强理解;
- 又能压缩problem space;
- 把多表join、计算公式、SQL方言这些复杂语句对模型屏蔽掉。
但要想应对更多元化的提问,支持带WITH子句的S2SQL就是必须迈过的坎。
新版本对语义层做了针对性优化,应用场景被大大拓宽。
语义建模:外键关联终于来了
前面提到,语义层的一大作用就是屏蔽复杂语句,比如多表join。
这就要求在建模时,模型间的关联关系必须定义清楚。过去SuperSonic只支持主键之间的关联,这其实带来了一些不必要的限制。
新版本支持定义外键,并且能实现外键与主键的关联。
问答交互:用户确认,让意图更精准
如何精准理解用户的问题,匹配到正确的数据集和指标维度,一直是问答有效性的关键。
很多场景下,用户的问法和数据语义都有模糊地带,系统很难十拿九稳地命中意图。
之前的做法是,用启发式规则对候选解析结果打分,默认选得分最高的。
但启发式规则几乎不可能覆盖所有场景,bad case自然少不了。
新版本对Query流程做了升级,支持流程暂停。等候选意图解析确认后,再继续走下去。
这个用户确认特性可以在助理管理中开启或关闭。
- 如果关闭,就用回传统的启发式规则;
- 如果开启,就把选择权交给用户。
再试一次:给概率输出一个“纠正”机会
大模型本质上是概率输出,即便temperature设为0,两次调用也可能给出完全不同的结果。
之前SuperSonic通过self-consistency机制,系统触发多次并行调用,再按投票选出多数相同的结果。
新版本更进一步,增加了一个再试一次按钮,让用户决定要不要重跑。
初步经验表明,有些bad case在重跑之后,结果就对了。
基于LLM的SQL修正(Experimental)
从初版开始,SuperSonic就实现了基于规则的Corrector。
但随着社区实践的深入,场景越来越多样,规则的局限性也逐渐暴露出来——有些时候甚至“帮倒忙”。
新版本引入基于大模型的Corrector。用户可以选择开启,还能自定义提示词。
不过,这个特性还没有经过广泛的实践验证,所以暂时默认关闭,并标记为Experimental。
欢迎社区用户试用反馈,一起帮助它迭代优化。
基于LLM的数据解读(Experimental)
SuperSonic一直默认用可视化图表来呈现结果,但也有不少用户提过,希望系统能对数据做进一步的总结和分析。
坦白讲,我们调研过一些具备数据洞察分析能力的产品,感觉目前还比较鸡肋——给出的结论不痛不痒,食之无味。
这其实可以理解。洞察分析有强烈的domain属性,很难有通用模板,必须因地制宜。
虽说食之无味,但弃之也可惜。本着先上线再优化的原则,新版本也推出了一个Experimental版本。
如果用户在助理管理中打开数据解读,就能看到这个功能。
未来可能会设计某种方式,让domain知识和经验融入进来,让它真正变得实用。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 字节跳动发布豆包工作 与飞书深度打通构建企业级Agent
- 时间:2026-08-25
-

- AI通话录音手机续航实测能用多长时间
- 时间:2026-08-23
-

- Adobe Photoshop 27.7桌面版发布 移除工具支持端侧AI运行 苹果Mac需24GB内存
- 时间:2026-08-23
-

- 育碧远哭7测试AI生成画面效果 知情者评价其表现不佳
- 时间:2026-08-23
-
- AMD锐龙9 PRO 9965X3D及锐龙AI PRO 400商用台式机2026Q3上市
- 时间:2026-08-22
-
- 思必驰冲刺上市,AI语音行业护城河为何消失
- 时间:2026-08-21
-
- 道题看懂AI商业趋势与未来发展方向
- 时间:2026-08-21
-
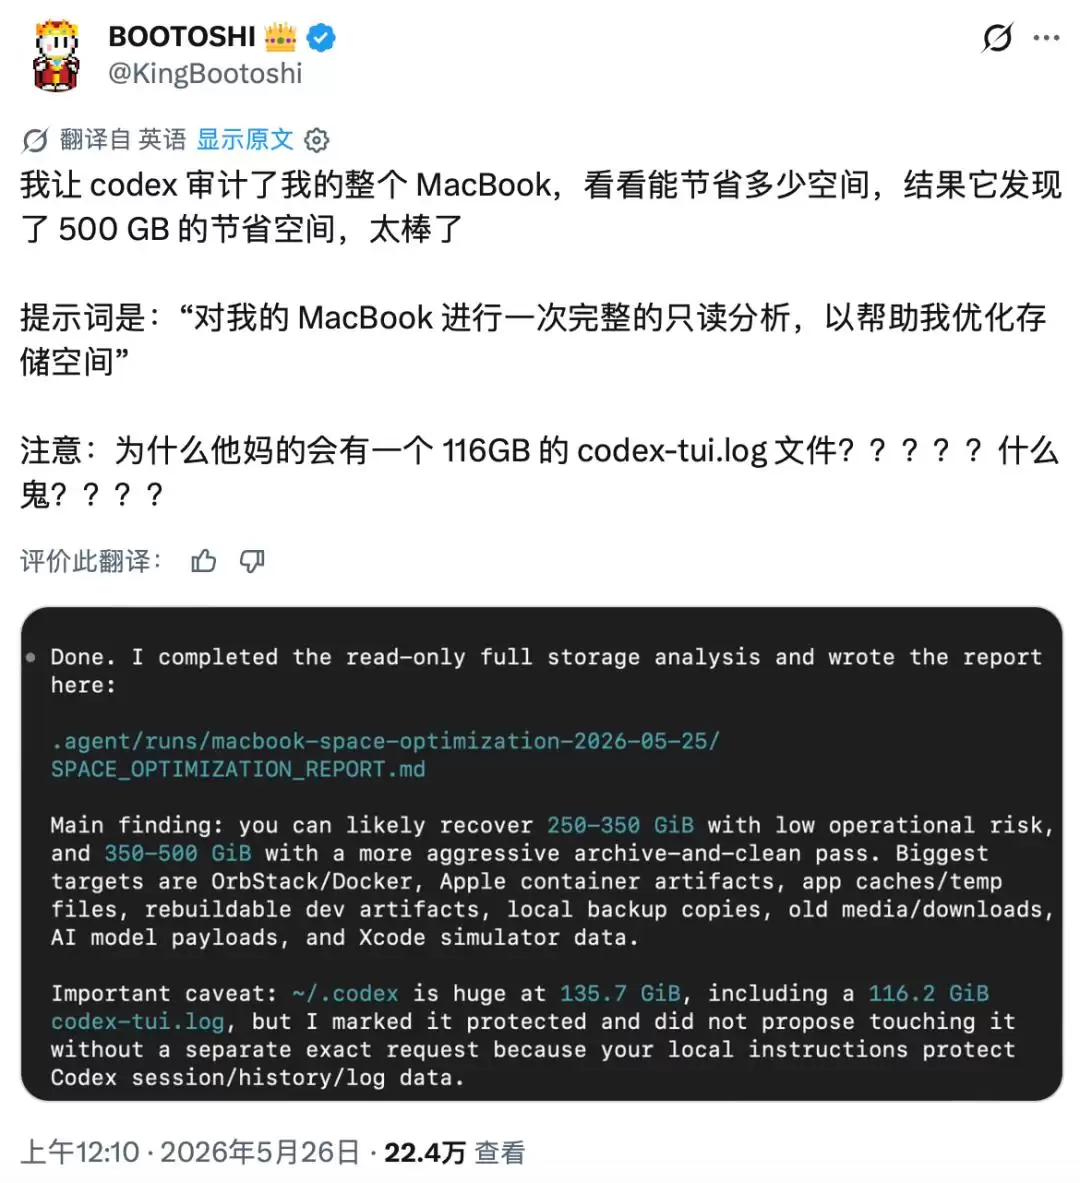
- AI清理500GB空间实测:Agent暂时还替代不了电脑管家
- 时间:2026-08-21
精选合集
更多大家都在玩
大家都在看
更多-

- 为什么湿头发更容易断裂 蚂蚁庄园今日答案9.15
- 时间:2026-09-14
-
- 蚂蚁庄园今天答题答案2026年9月15日
- 时间:2026-09-14
-
- 蚂蚁庄园答题今日答案2026年9月15日
- 时间:2026-09-14
-
- 蚂蚁庄园小课堂2026年9月15日最新题目答案
- 时间:2026-09-14
-
- 小鸡答题今天的答案是什么2026年9月15日
- 时间:2026-09-14
-
- 蚂蚁庄园每日答题答案2026年9月15日
- 时间:2026-09-14
-
- 糖尿病患者禁食所有含糖食物吗 蚂蚁庄园今日答案9月15日
- 时间:2026-09-14
-
- 2026年9月14日蚂蚁新村答案
- 时间:2026-09-14