替代NL2SQL的Agent与业务语义融合产品设计方案
时间:2026-08-18 | 作者:骑光打字机 | 阅读:0先聊聊行业里一个普遍的困惑:企业花大价钱建了数据仓库、数据湖,各种大屏驾驶舱也上了,但领导层想追一个为什么——比如为什么这个月业绩突然下滑——还是得层层提需求,等分析师出结论。
问题出在哪?数据它不撒谎,但它也不会主动告诉你“为什么”。可视化工具能回答“是什么”,但离真正的洞察还有一步之遥。
这就引出了我们今天要聊的主题:大模型技术怎么帮数据分析领域真正破局。

这篇文章会从几个核心角度展开:
- 先看大模型能解决哪些具体的业务痛点;
- 再讲一套切实可行的产品设计思路,重点是Agent架构加上数据语义层;
- 然后结合一个零售连锁行业的真实案例;
- 最后聊聊产品设计中的挑战和未来演进方向。
01 引言:大模型技术对于数据分析领域能够解决哪些痛点
管理团队的核心痛点
很多企业花了不少力气搭建数据基础设施,但数据产品往往停留在固化看板层面。决策层看到data,却看不到insight。
一旦想对某个细分指标做深度洞察,还得回头找分析团队,往往要等很久。更关键的是,领导层真正想知道的不是“发生了什么”,而是“为什么发生”。
比如:
- 为什么业绩下滑?
- 为什么某个门店销量不好?
- 为什么某个指标突然异常?
可视化驾驶舱只能给what,给不了why。所以很多老板真正期待的是:对着大屏直接问“为什么指标下降了?”,系统直接给出结论。
这才是大模型加数据真正该干的事。
业务人员的核心痛点
业务人员面临的核心问题,是工具门槛太高。要么学SQL,要么学复杂的BI工具。
好不容易拿到数据,还常常要手动导出Excel做透视表,才能进一步挖掘洞见。这个过程慢,而且依赖个人经验。
大家真正渴望的是:用自然语言对话,直接从海量数据里拿到结论,辅助日常决策。
技术团队的核心痛点
技术团队(数据开发、数仓工程师)的痛点也很典型:数仓搭好了,但业务方临时需求不断。
结果就是数仓里堆了大量临时ADS表,指标口径各自为政,数据分散、一致性差。这些问题相互叠加,传统范式已经越来越难应对。
新的解决思路
我们的核心思路是:用大模型Agent架构来改变原有范式。
- 过去是业务方提需求;
- 技术团队采买BI工具;
- 最后业务方不会用,或者数据分析师人力跟不上需求。
新范式是在中间加一个桥梁——语义层。让大模型参与到数据理解、意图解析和任务编排中,从而降低看数门槛。
02 解决方案:智能分析产品常见设计思路以及优化路径
为什么需要语义层
我们提出的关键概念之一,是在数据和业务之间添加语义层(Semantic Layer),作为连接业务语言和技术语言的桥梁。
构建数据语义层包含7个核心要素:先把数据集成进来,然后构建语义模型,通过数据虚拟化、OLAP计算等方式,供大模型去消费。
“仓内语义层”的局限
目前很多企业在尝试“仓内语义层”。也就是把整个数据语义口径层构建在数据仓库内部,包括指标对应的是哪个表的哪个字段、加工逻辑等。
但这套方式有两个硬伤:
- 第一,数据语义层完全由数据工程师在数仓里构建,业务方很难修改ETL作业,而看数口径是经常变化的,对业务方不够友好;
- 第二,即使数仓内部做了统一,一旦把数据集市的结果表同步到终端(比如BI工具、大屏、Data Agent),数据团队很难在终端维护指标口径,因为不同应用的负责人可能自己改口径,导致两边数据不一致。
指标口径都不统一,大模型就更难理解了。
直接NL2SQL的问题
基于仓内语义,很多团队尝试直接把数据中台内部的指标语义交给大模型,让它直接生成SQL。
这种方式也存在不少问题:
- 一是即使是最强的GPT-o1也会有准确性偏差;
- 二是大模型生成的SQL通常没经过OLAP优化,查数很慢,作为自然语言交互工具,等待体验极差;
- 三是缺乏对数据查询、数据权限的管控——不同用户问同一个问题,大模型不知道按什么口径、什么权限输出,存在数据安全风险。
因此,我们构建了一套“仓外语义”架构。
“仓外语义”架构的做法
具体做法是:在不改变原有数据仓库、数据中台表结构的情况下,增加一个“建模右移”的指标语义层。本质上,就是前面说的7要素。
它让业务团队、产品经理可以直接把指标、维度的核心要素做拼接。比如“借款人数”是一个原子指标,基于它会有分析维度:机构、产品、时间等。
这些指标和维度被原子化之后,就变得对大模型友好了。
自然语言如何转成可执行查询
举个例子:业务方问“帮我看一下最近30天的借款人数的增速如何?”
大模型先把这段中文自然语义解析成几个要素:
- 指标:借款人数
- 维度:最近30天
- 高级算子:增速
这个过程靠大模型本身的意图理解能力实现。解析出这些要素后,指标语义层会根据这些要素拼接出对应的SQL片段,交给OLAP引擎查询。
注意,这里大模型不直接生成SQL,而是做语义识别和片段拼接,从而避免幻觉。
同时,这个过程是低代码的,业务方也能参与调整指标口径。这是仓外语义相比仓内语义的最大优势。
数据人员与业务人员共建
这样一来,指标语义层的产品定位就变成了数据人员和业务人员共建的模式。
数据团队聚焦建好数仓,上层更灵活的指标定义和拼接交给业务团队。最终大模型理解的,就是业务团队设计好的指标语义和维度语义。
从根本上看,这种方式杜绝了幻觉问题。
完整流程与优势
整个流程变成:
- 用户用自然语言提出分析需求;
- 大语言模型进行意图识别;
- 把需求理解为对应的指标、维度(这个过程叫Natural Language to Semantics to API);
- 指标语义层通过数据虚拟化技术生成SQL片段;
- OLAP引擎查询;
- 返回结果。
在这个过程中,大模型只发挥自己擅长的思考、意图识别和解析能力;数据语义层发挥标准化的查询能力。
数据安全也有保障。比如北京、上海、深圳的业务人员都说“看一下近7天的销售额”,虽然问题一样,但系统能识别每个人的角色和权限级别,拿到不同的数据。
这是NL2SQL很难实现的。
NL2SQL与NL2Semantics的差异
下面这张图是我们某客户实测NL2SQL和我们NL2Semantics的效果对比。
简单单表查询时,NL2SQL还行。但难度上到三星以上,没有Semantic Layer和多任务规划机制,直接NL2SQL就会出问题。
比如第四个问题:既要看某个品牌最近三个月销量TOP3的商品,又要看这三个商品的好评率,还要做数据报告。
这其实需要多个任务衔接:
- 数据分析;
- 排序;
- 解读;
- 归因。
直接生成SQL根本搞不定。通过Agent架构,先把复杂请求拆解成原子能力,再结合指标语义层做解析。
对大模型来说,它只需要把“最近三个月”识别为时间,把“商品”识别为产品维度,把“好评率”识别为指标。映射关系搞清楚就行。
这些指标维度对应的SQL片段逻辑,在数据语义层维护。所以Agent加Semantic Layer的方式,能更好满足复杂场景下的查询需求。
03 技术架构:Agent架构结合数据语义层(Semantic Layer)如何实现产品落地
Agent架构为什么关键
要把Data Agent做好,除了语义层,Agent架构本身也很关键。
我们结合一个金融机构的例子来看:业务方问“看一下最近7天基金申购人数,哪个渠道跌得最多,再帮我做个总结”。
四个核心环节
从Agent角度,我们在底层把这个任务拆成四个环节:
- 专家雇佣
- 协同决策
- 动作执行
- 结果评估
专家雇佣机制好比有一个小组,每个角色各有所长。有的擅长数据提取,有的擅长可视化,有的擅长异常归因或写报告。
针对这个任务,需要三个专家一起参与:先取数据,再做异常归因,最后写报告。这三个专家,或者说三个API,会作为一个小组协同工作。
大模型在其中扮演什么角色
在协同决策中,大模型生成一个调度任务,把每一步的逻辑按顺序或异步编排好。
大模型在这里扮演规划者和协调者,就像交响乐团的指挥。不一定精通所有乐器,但能协调每个声部如何配合。
这是一种大小模型协同的机制:
- 大模型负责思考、协调;
- 把原子能力编排起来;
- 最终解决用户任务。
语义层保证取数准确,Agent架构保证数据分析子任务被有机编排,最终形成业务方能看懂的结论。
更具象的产品设计思路
下面是更具象化的产品设计思路。
用户提问后,先让大模型感知意图。如果不是数据分析类问题,就路由到其他Agent,比如知识库或文生图。
如果是数据分析,则通过planning机制拆解任务,并反思规划是否合理。同时还要考虑上下文:用户之前问过类似问题吗?可以做动态few-shot加速召回。
复杂问题被大模型做完planning后,通过工具调用实现具体任务:
- 取数;
- 归因分析;
- 生成报告。
这就是从理解用户意图,到编排、获取记忆、再到function执行的全流程。
关键点:数据语义层要保证取数准确;Agent机制负责把原子能力以合适的顺序和时间点编排并回传。
工具调用可能是同步的,比如取数、图像生成;也可能是异步的,比如数据解读、分析报告,大模型用时较长。
04 应用场景:某零售连锁行业智能分析助手落地案例
项目背景
接下来看一个零售连锁行业的真实案例——加盟连锁形态的零售商,希望赋能各级领导、门店经理。
以前所有看数、取数、指标分析,全靠总部十几人的专业BI分析师。但提需求的有上千人,效率问题可想而知。
落地方案的核心
我们先帮其在已有数据中台之上构建了Semantic Layer,让大模型明白公司内部有哪些指标和维度。
这层叫统一的数据语言:财务指标、门店指标、商品指标、供应链、外卖、毛利等所有指标的数据编织先管理好。不仅人能看懂,大模型也知道该怎么取数。
然后在数据应用层面构建大模型分析助手。注意:对原有数据仓库、数据湖完全没有侵入,只是在仓外构建了一个专门的数据语义层,做数据集成和加速。
最关键的就是这个Semantic Layer——数据语言和业务语言之间的桥梁。
系统如何运行
在此之上,通过Agent架构和规划器串联不同场景:查门店业绩表现、看客群画像、对财务指标做洞察等。
第一步,大模型做意图识别和planning。这里适配了百川、智谱、千问等多个国产大模型。
第二步,把对应的指标、标签、维度通过加速引擎查询出来。
指标语义沉淀的价值
下图是语义层的一个示意——当时有几百个指标,之前全在专业分析师脑子里,分析师一走,口径就丢了。
把指标语义和血缘存下来后,想知道某个指标,就能路由到对应的结构和语义。
业务使用效果
落地前,每个门店经理做月度复盘,都要靠专业分析师在BI或Excel里分析。成本高,门槛也高。
落地方案后,门店经理可以直接通过自然语言做指标洞察和分析。比如问“最近30天的销售额”,大模型把“销售额”“毛利”解析成指标,把“30天”解析成日期,然后通过语义层取数。
取到后还能点选生成可视化图表。发现指标异常时,大模型可以调度归因小模型做维度或因子分析,快速定位问题。
原来一个门店经理要花4小时,才知道某天毛利为什么跌、是什么商品跌了、谁负责的店跌了。现在通过自然语言交互,就能直接拿到结论。
最终价值
一方面,指标语义层告诉大模型指标体系怎么构建。另一方面,AIGC技术快速把数据结论以报告或文本形式呈现出来,业务方不用自己编排ETL作业。
语义层还配置了一些企业黑话的映射。构建指标体系、明确指标血缘关系,是归因分析的基础。
智能分析助手在准确性、人效、用户满意度方面都有显著提升,并通过强化学习机制(点赞/点踩)让大模型更好理解用户应用逻辑。
05 产品设计理念与挑战:LUI+GUI融合的产品设计理念与挑战
对于B端应用,大模型参数配置很复杂。我们建议产品形式不要像C端那样只有一个对话框,而是采用GUI与LUI结合的方式。
- LUI门槛低;
- GUI能把参数、按钮、追问以图形化形式呈现。
常见挑战1:用户提问模糊时,怎么提升交互体验
用户很多时候自己也不清楚请求是否清晰。比如门店经理问:“帮我看一下最近按照渠道的订单量,并对比一下去年同期。”
大模型不知道“最近”是7天还是30天,口径不明确,也不知道要怎样的对比。这时我们希望大模型能自己思考,做一些反问提示。
比如用户问“最近的资产情况”,大模型应思考这个指标常用的时间维度是什么,并给用户推荐。
用户想看“利润”,大模型要结合指标语义层反思:是前台毛利还是综合毛利?然后反问用户。这样才能解决语义不清时的查询准确率问题。
常见挑战2:如何让用户可以说企业内部的“黑话”
不同部门的人表述自然语言时可能很相似。比如用户运营部门说“看一下昨天某个门店的数据表现”,经营活动部门也这么说。
但每个人对“数据表现”的理解完全不一样:
- 运营可能想看首单、复购、召回;
- 经营分析可能想的是营收、成本、利润、损耗。
大模型不知道提问者是谁,所以需要把角色考虑进去。要让大模型知道你是谁,你对这四个字的理解是什么。
我们通过在后台配置企业专有名词(黑话),并考虑场景和角色来解决这个问题。有一个冷启动机制,需要教大模型用户是谁、用户关注什么,逐渐让大模型理解“黑话”映射的指标。
应用场景3:用户不仅需要提取数据,更需要分析思路
另一个大挑战是:业务方要的不仅仅是数据,而是结论、动作、建议。
不能只把数据表交给用户。在数据基础上,还需要帮用户做快速归因解读。
通过持续反思,让大模型形成追问机制,更快帮用户解决特定场景的问题。
06 未来展望:智能数据分析产品演进展望
最后总结一下对数据智能分析产品未来方向的看法。
GPT-o1推出后,基础能力更强了,已经具备某些垂直领域的专业能力。但目前大部分工具,包括Data Agent,还是以listening为主——等着用户提问,然后回答。
更好的模式应该是:大模型在理解用户分析历史、理解用户角色之后,主动帮用户提问。
比如面向财务人员,大模型每天自动帮他跑关心的几个指标、生成报告。把分析范式从listen变成speak,才更符合数字员工的真实体验。
大模型像一个员工,能主动思考、主动帮你想问题、主动分担任务。
同时,当有了数据结论之后,更好的形式是这个系统能串联决策,从conclusion到decision。
比如发现某个指标不好,建议动作是什么。这样才能连接企业内部更多决策体系,充分发挥数据价值。
从listen到speak,从basic planning到expert strategy,从conclusion到decision——这三个层次的演进,才是Data Agent作为主动化、智能化数字员工的真正定位。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 字节跳动发布豆包工作 与飞书深度打通构建企业级Agent
- 时间:2026-08-25
-

- AI通话录音手机续航实测能用多长时间
- 时间:2026-08-23
-

- Adobe Photoshop 27.7桌面版发布 移除工具支持端侧AI运行 苹果Mac需24GB内存
- 时间:2026-08-23
-

- 育碧远哭7测试AI生成画面效果 知情者评价其表现不佳
- 时间:2026-08-23
-
- AMD锐龙9 PRO 9965X3D及锐龙AI PRO 400商用台式机2026Q3上市
- 时间:2026-08-22
-
- 思必驰冲刺上市,AI语音行业护城河为何消失
- 时间:2026-08-21
-
- 道题看懂AI商业趋势与未来发展方向
- 时间:2026-08-21
-
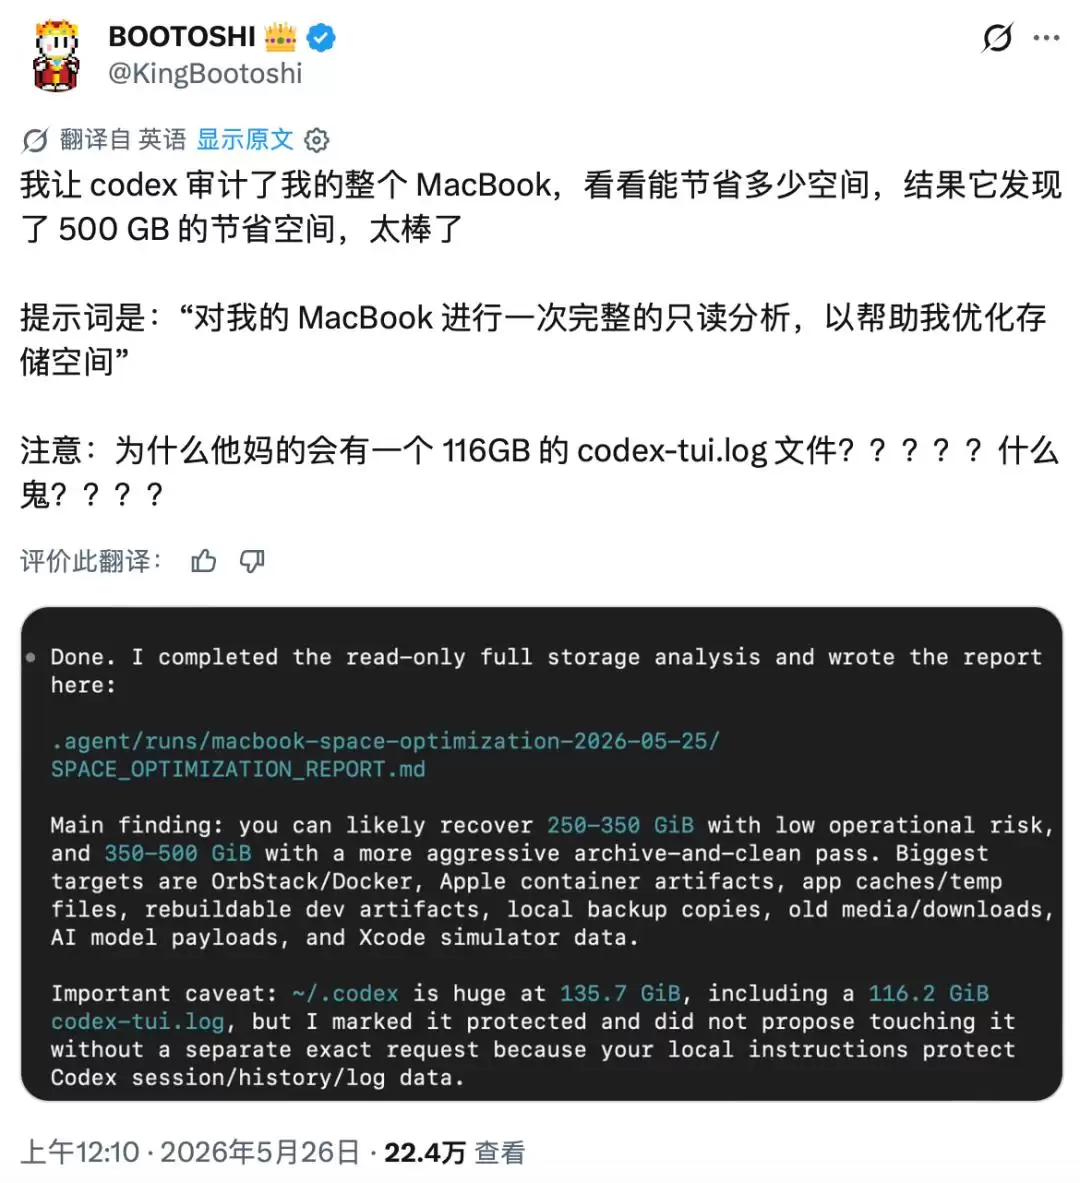
- AI清理500GB空间实测:Agent暂时还替代不了电脑管家
- 时间:2026-08-21
精选合集
更多大家都在玩
大家都在看
更多-

- 为什么湿头发更容易断裂 蚂蚁庄园今日答案9.15
- 时间:2026-09-14
-
- 蚂蚁庄园今天答题答案2026年9月15日
- 时间:2026-09-14
-
- 蚂蚁庄园答题今日答案2026年9月15日
- 时间:2026-09-14
-
- 蚂蚁庄园小课堂2026年9月15日最新题目答案
- 时间:2026-09-14
-
- 小鸡答题今天的答案是什么2026年9月15日
- 时间:2026-09-14
-
- 蚂蚁庄园每日答题答案2026年9月15日
- 时间:2026-09-14
-
- 糖尿病患者禁食所有含糖食物吗 蚂蚁庄园今日答案9月15日
- 时间:2026-09-14
-
- 2026年9月14日蚂蚁新村答案
- 时间:2026-09-14