AI编程新范式崛起:提示词工程会被取代吗
时间:2026-08-21 | 作者:云端旅人 | 阅读:0先说几个关键判断。
一位工程师曾分享过自己的演变轨迹:一年前写代码,还得老老实实打开 IDE。
去年 11 月,他干脆把 IDE 卸了——因为同一时间可能跑着 5 到 10 个 Claude,所谓的“写代码”,其实就是对着 Claude 发号施令。
而到了现在,连提示词都不怎么亲自写了。取而代之的是一堆循环在自动运转,循环本身负责提示 Claude、判断下一步该做什么。他本人的工作,变成了写这些循环。
说这话的人是 Anthropic 工程师、Claude Code 的创建者 Boris Cherny。
在他看来,这正是接下来几个月、甚至今年剩下的时间里,我们会看到的又一次范式转移。
几乎同一时间,现在 OpenAI 任职的“龙虾之父”Peter Steinberger 也在 X 上表态:“你不该再给编程 Agent 写提示词了。你应该设计一套循环机制,让这些循环去提示你的 Agent。”
这条帖子很快斩获 150 万浏览量,评论区里开发者们吵得不可开交。

这两位关键人物的公开表态,把一个新概念推到了台前:Loop Engineering。
简单来说,开发者不再手动向编程 Agent 输入提示词,而是去设计一套能够持续提示、调度和约束 Agent 的循环系统。
已经有网友开玩笑说,LinkedIn 上很快会掀起一波“Loop Engineering”的新潮流。
Peter 则回应道,别急,大概还得三个月,之后人们就该讨论“设计你的循环舰队”了。
这股讨论的热度背后,是社区已经开始把“写 Loop”视为继“写 Prompt”之后的下一层抽象。
有人把这个变化概括为“从 prompt engineer 到 meta-prompt engineer”。
也有先行者表示,这条路确实走得通。
“我就在搭建循环流程,配置终于调顺了,但字符膨胀的问题开始冒头,额度烧得飞快。烦人的是,它明明能跑通,可只要搞清楚哪里出了问题,就能用两倍速度、更低成本完成同样的事。”
Loop 不是机械重复
面对这个新概念,不少开发者第一反应是:这不就是个 cron job 吗?反复告诉模型“把这个应用做得更好”而已?
但真正让 Loop 变得有用的,是反馈循环。
想想一个开发团队日常需要什么:
要知道新功能是否按预期工作;
要知道哪里能改进;
要知道用户还有哪些问题;
要知道哪些工作流可以优化;
要知道优化能带来什么价值。
有些信息 LLM 可以直接访问数据获得。
有些则需要你自己生成。比如用户访谈、创建任务,或者干脆让模型自己跑 A/B 测试、增加监控。
和开发团队一样,你需要明确的 OKR 或目标。
给内部员工开发应用,目标可以是提升性能、降低错误率、自动化工作流;如果是电商,目标就是优化从转化漏斗到成交的流程、提高收入。
甚至可以像 Dependabot 那样,用来升级库、修复安全漏洞、管理技术债、做 QA。
关键在于,必须有一个清晰的目标,以及一个能验证输出结果的反馈闭环。
YC CEO Garry Tan 在转发相关讨论时也提醒,不要把 Agent 变成“富士康工厂”式的重复劳动机器。
Agent 通常是智能且有思考能力的,开发者应该让它们承担更多工作,而不是重复执行同一个动作。
有开发者补充,可以让 Agent 做更多事,但边界必须明确。
提供清晰的上下文;
提供可信的工具;
提供可审计的操作记录;
提供安全的停止条件。
这样 Agent 才能自主运行,而不至于演变成一套失控的“影子自动化”。
一名开发者在 Peter 的帖子下指出,设计 Loop 只完成了一半。
另一半,是在 Loop 里放入能够说“不”的机制——比如测试、类型检查或真实错误。
没有反馈机制的 Loop,只会让 Agent 不断重复并自我确认。Peter 回应说,自己的项目中使用 VISION.md 文件来应对这个问题。
这些讨论说明,真正有效的 Loop Engineering 不是简单的自动化脚本,而是一套带有反馈闭环的工程系统。
什么情况下继续;
什么情况下停止;
什么情况下回滚;
什么情况下交给人类。
这些都需要明确。否则,Agent 的错误可能在循环中被不断放大。
也有开发者指出,这高度依赖具体场景。
如果用 Loop 构建 Web 应用,可能导致系统膨胀,之后又得用另一个 Loop 去削减复杂度。必须建立严格的治理栈和清晰规范。
还有人追问一个更实际的问题:所谓 Loop,到底是在 CLI 里循环、在 shell 脚本里循环,还是直接让 Claude 自己循环?
Claude Code 已经提供了原生 Loop 能力
事实上,Claude Code 早就发布了 Loop 功能。
开发者可以在 CLI 中设置周期性提示词,让 Claude Code 按固定间隔反复执行任务。
Boris Cherny 近期还介绍过自己现在的工作流:让大量 AI Agent 长时间并行工作,夜间通常运行“几千个”AI Agent,持续执行更深层次的开发任务,通过 Claude App 管理。
这套工作流的关键,在于 Claude Code 中两个面向持续自动化的功能:/loops 和 Routines。
具体来说:
用户可以通过 cron 在本地定时运行 /loops,让 Agent 按计划循环执行任务;
Routines 则运行在服务器端,可以执行周期性任务。
即使工程师合上笔记本电脑,相关 Agent 仍然可以继续工作。
Loops 有一个关键变化:不再依赖外部 cron 或 shell loop。
过去用脚本包裹 claude -p 时,每次调用都是一次“冷启动”,缺少上一轮上下文;而 Loops 会在持续存在的 Claude Code 会话中运行,保留上下文窗口、工具权限和 MCP 连接。
Agent 能记住上一轮操作,并在下一轮继续推进。
开发者可以用自然语言创建任务,比如:“每 5 分钟检查一次 PR 构建是否通过。如果失败,就读取错误日志,修复问题,并推送一个新 commit。”
也可以通过命令创建:
/loop "Summarize any new posts tagged #announcements in the team Slack channel" --interval 30m --expires 8h
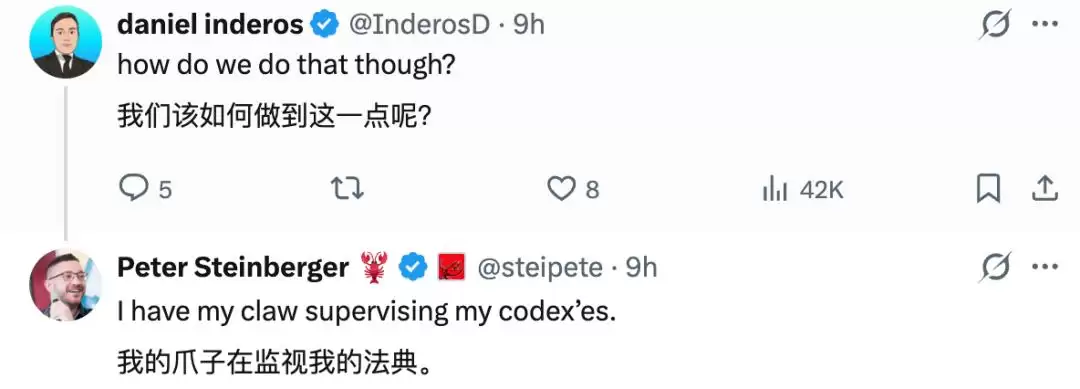
当网友问 Peter 具体怎么做时,他只表示在用 claw 监视其 Codex,没有过多解释。
目前,Codex 虽然有自动化和定时能力,但在 CLI 里并没有像 Claude Code 那样设立明确的原生循环命令。
比如创建新计划循环的 cron create;
查看活跃 Loop 的 cron list;
以及终止指定 Loop 的 cron delete。
有意思的是,有用户问 Peter 如何在 VS Code 中实现这一点,Peter 反问:“现在还有谁用 VS Code?”
正如一位网友所说:“我们已经从‘学会写代码’,走到了‘学会编写那个会写代码的东西’。不知为什么,这听起来既像进步,又像一场金字塔骗局。”
开发者:你们有无限 token 供应,我没有啊
设想很美好,但现实是,这种循环工程的 token 消耗量一点不低。
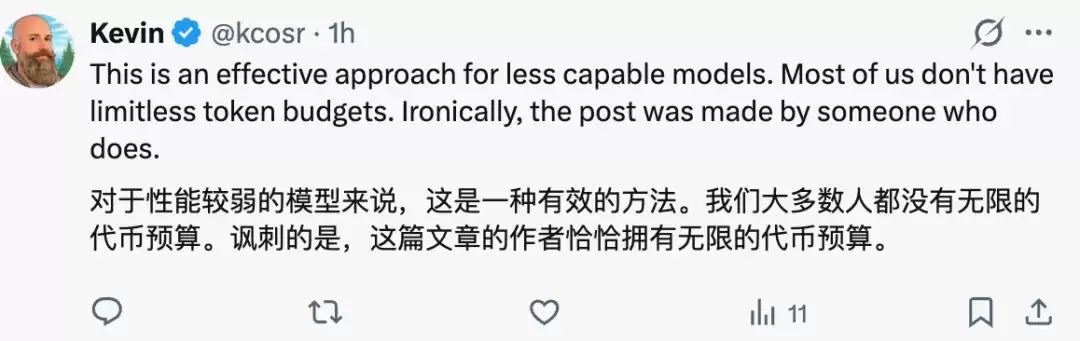
无论是 Boris Cherny 还是 Peter Steinberger,其背后的公司都提供了近乎无限的 token 支持,但对社区中的大多数人来说,自己的 token 预算可没那么高。
此前,Developers Digest 发文提醒,每一次 Loop 迭代都是一次完整提示词执行。
如果设置 1 分钟执行一次、连续运行 8 小时,就会产生 480 次 API 调用。团队需要提前规划使用成本。
对于 token 消耗问题,实际上连 Peter 也无解。
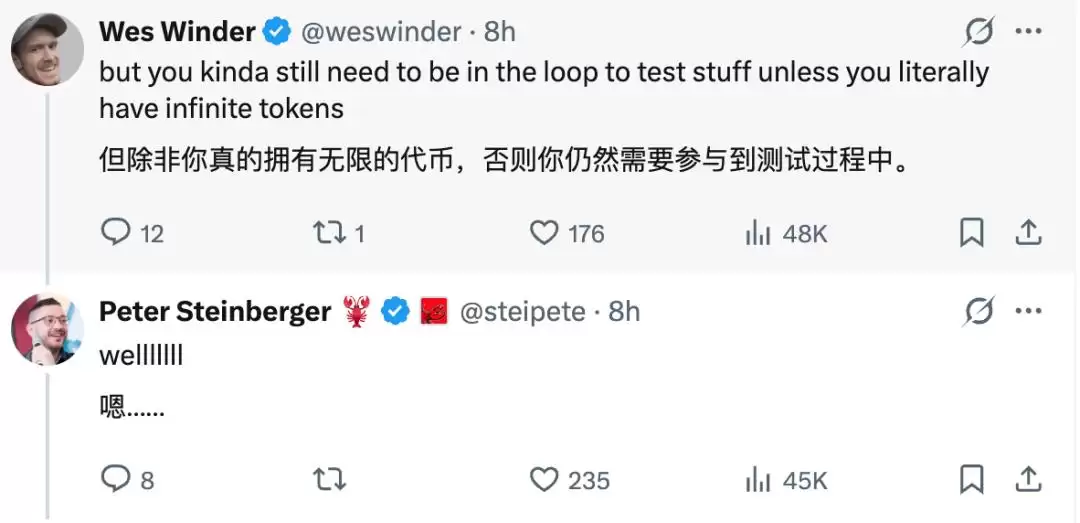
有人指出“20 美元的套餐根本不可能”,他只能回答:“没错。可难道你的时间真不值钱吗?”
还有开发者打了个比方:Loop 可以是 for 循环,也可以是 while 循环。
Token 充裕的公司可以随意使用 while 循环;Token 紧张的初创公司也能用 for 循环实现同样目标,只是花的时间更长。
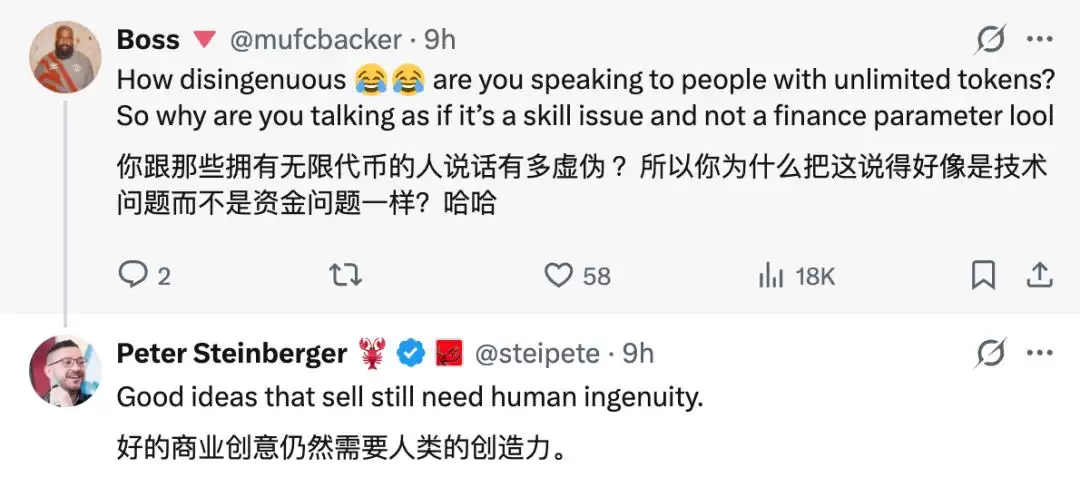
为此,有网友半开玩笑地对 Peter 说:“多么虚伪啊,你在对那么有无限 token 的人说这些吗?为什么把这事儿说得好像是技术问题,而不是资金问题?”
Peter 的回答也挺“正确废话”的:能卖出去的好创意,依然需要人类的巧思。
具体落地中,当前 Claude Code 对 token 消耗问题的做法基本是做各种限制:
Loops 支持最小 1 分钟间隔,最长运行 3 天,到期自动停止;
以避免无人管理的后台进程和失控 API 账单;
Loops 不是持久化后台任务系统;
它绑定当前 Claude Code 会话,关闭终端或结束会话后,Loop 就会停止。
这一设计是为了安全和可预测性,避免任务在用户遗忘后继续消耗 API 额度。
此外,Claude Code 也提供禁用 Loop 的开关。如果担心自动化任务失控、API 成本跑飞,或者不希望团队成员使用循环式 Agent 工作流,可以关闭这个功能。
除成本外,Loop 的实现可能比想象中麻烦得多。
“所有人都在冲向 loops,但调试一个已经跑了 47 轮的状态机,比修好一个 prompt 难 10 倍。”有网友指出。
“Loops 的方向是对的,但我们跳过了一个关键阶段:大多数人现在连一个可靠的一次性 prompt 都还写不好。”
一些已经开始使用 Loop 的开发者表示,“一开始什么都很容易设置,但之后你才会意识到,里面有一堆痛点,修起来又太费劲。”
“现在想想,我都有点对不起同事,因为是我把 Loop 引进并推广到我们组织里的。现在如果迁移到另一个方案,会耗费大量时间和资源,所以我们只能再撑一阵子,直到它变得实在太痛苦为止。”有开发者跟帖道。
“我们也干过这事,把它集成进来,想在一个项目里试用 Loop。结果现在光是把那个项目的数据导出来,再迁到我们现在用的工具里,就已经要花很多时间和精力,没人想干。我的建议是:能多早迁就多早迁。时间拖得越久,情况只会变得越糟。”有开发者回复称。
Claude Code 如何一年内从 20 分钟跑到“数天”
Loop 工程的重点在于:让 Agent 在长时间运行中持续不跑偏,并能可靠判断自己有没有做对。
这方面,Claude Code 自己就是典型代表。
Anthropic 应用 AI 团队的工程师 Ash 近日表示,公司当前探索方向更偏“尽量完全自主”。
目标是把人类判断写入 Harness,而不是在不稳定环节插入人工兜底。
团队会同时运行多个生成结果、阅读失败案例、调整提示词,反复迭代,直到可以较放心地让 Agent 自主运行。
过去一年,Claude Code 已从“只能连续运行约 20 分钟、连 Bash 命令和字符串转义都容易出错”,进化到“几乎由 Claude Code 自己编写,并可连续运行数天”的阶段。
Anthropic 工程师 Andrew 指出,让 Agent 连续运行数小时甚至数天,核心难点主要有三类:
上下文;
规划;
自我判断。
首先,上下文窗口有限,新会话会让 Agent 像“失忆”一样从头开始。
长会话中还会出现上下文腐烂(context rot),模型越接近上下文窗口末尾,越容易出现“上下文焦虑”,匆忙结束任务。
其次,模型默认并不擅长长期规划。
它可能一次性试图完成所有任务,也可能只做完一半功能就停止。
更关键的是,模型很难准确判断自己的输出。
它经常会把半成品误认为完成——前端按钮已经出现,但后端逻辑并不存在。
为解决这些问题,Anthropic 采用了两条路径:
一是继续提升模型本身,把更多长时任务能力写入模型权重;
二是改造模型外部的 Harness,也就是围绕模型的智能体脚手架。
在具体机制上,Anthropic 早期长时运行 Agent 会先由初始化 Agent 将模糊需求拆解成一组持久化文件。
例如 feature_list.json、progress 文件、Git 仓库和初始化脚本。
随后,Agent 在新鲜上下文窗口中反复执行:
读取当前进度;
启动项目;
选择一个未完成功能;
实现;
测试;
提交代码;
并继续下一轮。
这种模式通过“新上下文窗口 + 持久化工件 + 验证循环”来缓解长任务中的上下文丢失和任务漂移。
但随着 Opus 4.6 等新模型能力增强,Anthropic 已开始简化这类 Harness。
Opus 4.6 更擅长规划和工具选择,Sonnet 4.6 则以更低成本提供接近 Opus 的执行能力,因此常见组合是用 Opus 做规划、用 Sonnet 执行代码。
同时,服务器端压缩和百万级上下文窗口使模型可以在单一长会话中保持更久连贯性,不再总是依赖频繁开启新会话。
生成器—评估器—规划器:当前的前沿 Harness 模式
当前,Anthropic 正在内部实验的前沿 Harness 模式是:生成器—评估器—规划器结构。
这个设计借鉴了生成对抗网络(GAN)的思想:生成器负责构建应用、评估器负责批判和打分,两者通过对抗压力不断提升结果质量。
与让一个 Claude Code 会话自查不同,Anthropic 会让评估器拥有独立上下文窗口和系统提示词。
并真正使用 Playwright 打开网页、点击、截图和测试应用,而不只是阅读代码 diff。
不过,Ash 指出,自我评估是一个陷阱。
模型很容易对自己的作品过于宽容,但如果把“构建者”和“批评者”拆开,单独训练一个更严苛的评估器会更可控。
他用人类类比称,一个人评价一幅画或一道菜很容易,但亲自画出来或做出来要难得多。
大语言模型同样如此:它作为批评者和作为生成者之间存在能力差距,而 Harness 可以利用这种差距。
在评估主观质量方面,Anthropic 还尝试将“品味”写成可评分的量规。
Ash 表示,很多人认为设计审美无法评估,但只要有足够明确的观点并写下来就可以评分。
比如,Anthropic 将前端应用质量拆成四类标准:
设计;
原创性;
工艺;
功能性。
并根据模型能力调整权重。
由于 Opus 4.6 在功能性上已经较强,当前评估更侧重设计和原创性,目的是避免常见的“紫色渐变”“AI 味审美”等问题。
为了从页面生成走向完整应用,Anthropic 又引入了规划器角色。
规划器只负责把一句话需求拆成高层规格和冲刺阶段,而不是提前规定所有技术细节。
真正开始写代码前,生成器和评估器还会先协商“什么叫完成”。
生成器提出要实现的功能和测试方式;
评估器则反驳范围是否过大、测试是否太弱、是否漏掉边界情况。
双方通过磁盘文件来回沟通,直到形成一份契约。
之后评估器按照这份契约验收,而不是按照最初模糊需求验收。
至于“Ralph Loop”(让 AI 在同一个任务上持续工作,直到真正完成所有目标)是否仍有价值,Andrew 表示,在百万级上下文窗口和 Opus 4.6 的连续会话能力下,Anthropic 已经在部分场景从新会话切换到单一长会话加压缩,但具体选择仍取决于用例和评测。
Ash 则认为,上下文腐烂是当前模型的临时性缺陷,某些支架组件未来可能会随着模型进步被移除。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 微软自研AI编程大模型取代Claude 开发者受益
- 时间:2026-08-22
-

- Claude iOS版设置菜单重设计上线,新增记忆文件功能
- 时间:2026-08-21
-

- Claude攻克百年数学猜想,黎曼猜想之后再引关注
- 时间:2026-08-21
-

- 微软意外泄密Claude Mythos万亿参数与训练规模曝光
- 时间:2026-08-21
-

- 专家预测年底实现,Claude Mythos今日跑出3小时6分成绩
- 时间:2026-08-21
-

- Bun用Claude Code 9天重写100万行代码后安全吗测试通过率引质疑
- 时间:2026-08-21
-

- 把Claude Code作为可编程基础设施:从提效工作到让系统自动干活
- 时间:2026-08-20
-

- Claude进军蛋白质设计:15个靶点攻克14个成果亮眼
- 时间:2026-08-20
精选合集
更多大家都在玩
大家都在看
更多-

- 以下哪种食材被称为“地下苹果” 蚂蚁庄园今日答案9.18
- 时间:2026-09-17
-
- 蚂蚁庄园今天答题答案2026年9月18日
- 时间:2026-09-17
-
- 蚂蚁庄园答题今日答案2026年9月18日
- 时间:2026-09-17
-
- 蚂蚁庄园小课堂2026年9月18日最新题目答案
- 时间:2026-09-17
-
- 小鸡答题今天的答案是什么2026年9月18日
- 时间:2026-09-17
-
- 蚂蚁庄园每日答题答案2026年9月18日
- 时间:2026-09-17
-
- 蔬菜洗完掉色,说明是被染色了,是真的吗 蚂蚁庄园今日答案9月18日
- 时间:2026-09-17
-
- 满襟蜡绘花纹巧染就花纹当绣裳说的是哪种传统技艺 蚂蚁新村今日答案2026.9.17
- 时间:2026-09-17