Spark快速开发入门之Scala基础教程二
时间:2026-08-21 | 作者:星际追番人 | 阅读:0写在前面
面向ja va开发者。实际上,具有ja va基础学习scala是很容易。
ja va也可以开发spark,并不比scala开发的spark程序慢。
但学习scala可有助于更快更好的理解spark。
比如spark的很多算子group,filter之类的,全都是scala语言本身所具备的功能。
再比如,想做一个更高级别的spark开发者,势必需要了解spark源码。
哪怕不需要通读,但也需要了解scala语言。
快速入门的意思先具备一个宏观上的系统而整体的把控,然后再到这个框架上去把血肉丰满。
从阅读源码的角度来说,作为一个ja va开发者,在数据类型和容器,控制语句等方面,哪怕不会写,至少能大致读懂。
但涉及到更高层次的高阶函数,就很头痛了。
比如list。只会讲声明,增删查改以及循环。就能满足大多数情况下的开发。
至于其它的功能,通过查看文档,或者源码,就可以搞懂。
涉及到像增这一块,比如添加一个元素,list有【++: ++ +: :+ :: ::: :】等很多功能。
但本文只涉及最简单的东西。
总之,这是一个简易版的入门。后续的学习不能停止
3 类,对象,特征
类
scala的类定义非常灵活
class test4
class test2{}
class test3(x:Int)
定义一个带构造函数的类
class Point (x : Int,y : Int){

    def add() : Int = {
    x1 + y2
    }

}
通过this来重写构造函数
  def this(X1 : Int){
    this(X1,1)
  }

  def this(X2 : String){
    this(0,1)
  }
除了重写构造函数,还可以当作当前对象的引用。
def add(x:Int) : this.type = {
    this
  }
等价于
  def add(x : Int,y : Int) : Point = {
    this
  }
继承
scala属于单继承。
跟ja va一样,scala使用extends关键字来继承父类,使用override重写父类方法。
scala的方法的重载与重写遵循ja va的规则。
class print (x : Int) extends Point(1,1){

  override def add(x : Int,y : Int) : this.type = {
    this
  }

}
case class
case class跟普通class略有区别
- 1:case class可直接使用,不需new()。
- 2:case class默认实现了序列化。
- 3:case class默认重写了equals和hashcode。
- 4 : case class可以自动对属性进行模式匹配以及隐式转换。
比如在spark中,读取文件自动转换为dataset.
case class data(DEVICENAME: String, LID: BigInt,ADDRESS:String,ID:BigInt)
session.read.option("encoded", "utf-8").json(path).as[data]
下面这种写法就会报错
class data(DEVICENAME: String, LID: BigInt,ADDRESS:String,ID:BigInt)
session.read.option("encoded", "utf-8").json(path).as[data2]
抽象类
scala的抽象类跟ja va类似。
只能定义方法体,没有实现。
只能定义var类型的变量,不能定义val类型的变量。
因为val类型的变量,子类无法重写。
abstract class PointAbstrct (x:Int) {

  var x : Int

  def add(x:Int)

}
特征
Scala的特质(Trait)和Ja va的接口有些相似,不过它还能有方法的实现。
这就像抽象类一样,但和Scala的抽象类比起来,它无法定义构造函数。
通常情况下,Scala的类只能继承一个父类。
然而如果是特质(Trait),那就可以继承多个,从结果上看,这就实现了多重继承。
对象
对于class类,通过new可以得到类的对象。
对于case class可通过apply直接使用类对象。
还可以直接创建一个object对象。
scala中没有静态的修饰符,但object类中的全都是静态成员。
在object类中可以直接定义入口函数main。
可以直接调用访问级别允许的变量及函数。
伴生对象
当一个object对象与一个class类名称相同且object与class在同一个源文件时,我们称object为class的伴生对象。
同时,class也被称为object的伴生类。
object和class可以互相访问对方的私有属性。
class applyclass {

  private val name : String = ""

  object applyclass{
    //初始化
  }

}
ja va
public class applyclass{

    static{
        //初始化
    }

}
前面讲到case class的时候,case class得到一个对象不需要new。
编译器会为Case Class自动生成伴生对象
-
编译器会为伴生对象自动生成以下方法
- apply
- unapply
所以:
case class data(DEVICENAME: String, LID: BigInt,ADDRESS:String,ID:BigInt)

val data2 = data.apply("test", 0, "test2", 0)

val option = data.unapply(data2).getOrElse("")
伴生类通过apply得到实例对象,通过unapply传入一个对象得到,从中取值。
单例对象
class Scala private{//private的构造函数

  def add() = 0
}


object Scala{//在伴生对象中得到类的实例,并向外部暴露
    val scala =  new Scala
}

 object test{
  def main(args: Array[String]): Unit = {
    val scala = new Scala//异常
    Scala.scala.add()
  }
}
伴生对象与apply方法
如果一个class与一个object具有相同的名字,那么我们就认为它们互为伴生。
object为class的伴生对象。
如下图所示,object Apply为class Apply的伴生对象。
需要注意的小细节是,伴生对象的apply函数哪怕没有参数也需要加上一对”()”.
class Apply {
  def apply = {
    println(" class apply")
  }

  def test = println("class test")
}

object Apply{
  def apply() = {//注意这里的apply()函数定义哪怕没有参数,也不能省略()
    println("object apply")
    new Apply
  }

}

object main_ extends App{
  val apply = Apply()
  apply.test
}
我们可以在伴生对象里实现apply函数,在函数里做一些事情。
如果我们想要得到class对象的实例,而没有通过new的方式,那么它会先去执行该class的伴生对象的apply函数
执行上述代码,结果:
object apply
class test
可以看到,第一行代码得到一个apply对象,它首先执行了伴生对象的apply(),然后执行了class Apply的test()。
可以表明它确实是一个class Apply对象。
apply的应用:
比如可以用来实现单例,需要两个步骤:
- 一把class的构造设为private
- 二在class的伴生对象里实现apply函数,在这里返回class的对象。
class Apply private {//构造函数私有化
  def apply = {
    println(" class apply")
  }

  def test = println("class test")
}

object Apply{
  val apply_i = new Apply()//伴生对象可以访问类的私有属性和函数
  def apply() = {//注意这里的apply()函数定义哪怕没有参数,也不能省略()
    println("object apply")
    apply_i
  }

}

object main_ extends App{
//  val apply = Apply()
//  apply.test

  for(i <- 0 until 10){
    val apply_i = Apply()
    println(apply_i)
  }

}
执行代码结果:
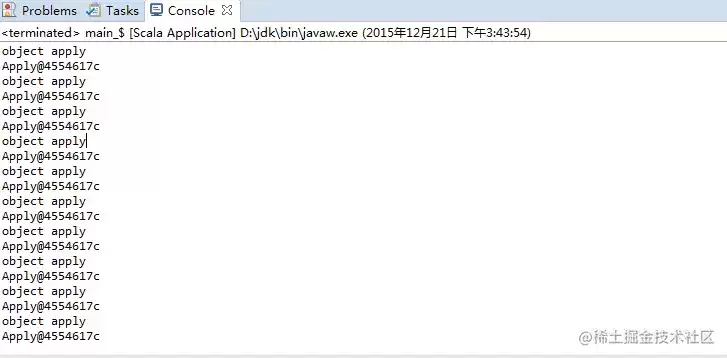
可以看到均为同一对象。
4. 高阶函数,偏函数,闭包
高阶函数
高阶函数就是将函数作为参数或者返回值的函数。
object function {

  def main(args: Array[String]): Unit = {
    println(test(f,10))
  }

  def test(f:Int => String , num : Int) = f(num)

  def f(num:Int) : String = {
    10 + num + ""
  }

}
在spark中,经常将只需要执行一次的函数定义为匿名函数作为参数传递给高阶函数。
如map,flatMap。
以map为例,最全面的写法是
object function {
  def main(args: Array[String]): Unit = {
    val list = List("spark","hadoop","hbase")
    list.map(f2:String=>(String,Int)).foreach(println)
  }
  def f(x:String) : (String,Int) = {
    (x,1)
  }
}
匿名函数的写法
list.map((x:String) => (x,1)).foreach(println)
利用匿名函数的参数推断,可以进一步简化的写法
list.map((x) => (x,1)).foreach(println)
如果只有一个参数
list.map(x => (x,1)).foreach(println)
可以使用_代替参数
list.map((_,3)).foreach(println)
偏应用函数
偏应用函数指的是如果一个函数有n个参数,为其提供少于n个参数的函数叫做偏应用函数。
又叫做部份函数。
其实也点类似于方法重载。
  def f1(x:Int,y:Int,z:Int) = x+y+z

  def f2(y:Int,z:Int) = f1(1,y,z)
偏函数
在scala中,偏函数是数学里的一个概念,它指的是定义域X中的某些值,在值域Y中可能不存在与之对应的情况。
简单来讲,就是入参需处于指定范围。
正因如此,它比普通函数多了个isDefinedAt方法,用于判断参数是否在该函数的接受范围内。
与普通函数不同,偏函数是scala.PartialFunction[-A,+B]的对象。
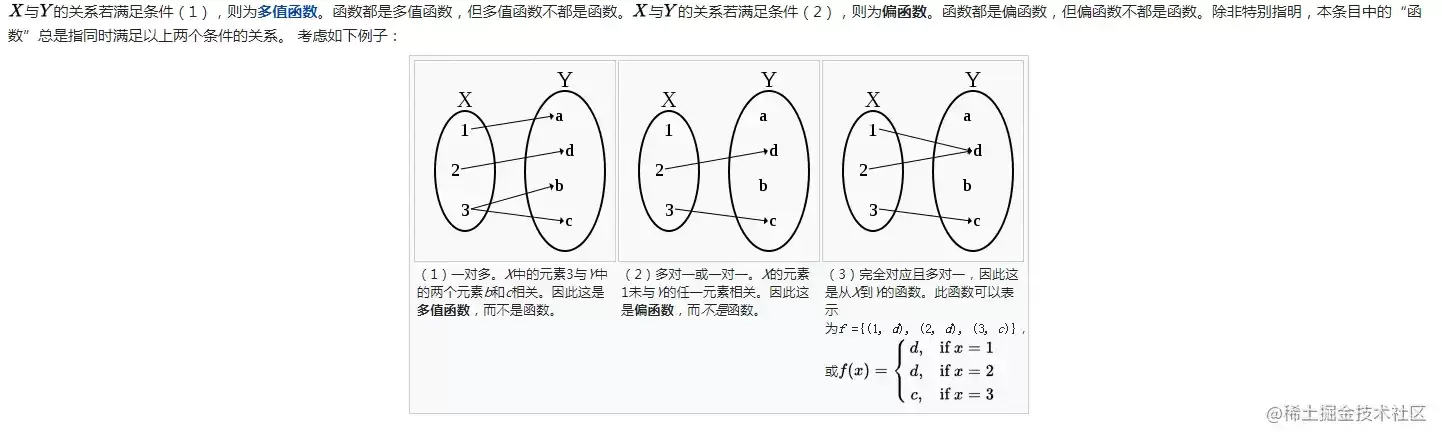
先看一个例子
//这是一个偏函数
  val pf: PartialFunction[Int, String] = {
    case 1 => "One"
    case 2 => "Two"
    case 3 => "Three"
  }

  //这不是一个偏函数
  val pf2: PartialFunction[Int, String] = {
    case 1 => "One"
    case 2 => "Two"
    case 3 => "Three"
    case _ => "else"
  }

    println(pf(1)) //One
    println(pf2(4)) //else
    println(pf(4)) //异常
偏函数的定义
PartialFunction[Int, String]
Int为输入类型,String为返回值类型。
pf的定义域为所有int,值域为【1,2,3】,除了【1,2,3】以外的参数并没有与之对应的返回值。
所以pf是一个偏函数。
调用偏函数传入定义域以外的参数就会报错,但是偏函数提供了其它的方法来避免这种情况。
使用isDefinedAt来判断是否可以传入此参数,返回一个布尔值。
println(pf.isDefinedAt(4)) //false
orElse相当于连接。
条件是两个偏函数的类型是一样的。
val pf: PartialFunction[Int, String] = {
    case 1 => "One"
    case 2 => "Two"
    case 3 => "Three"
  }

val pf2: PartialFunction[Int, String] = {
    case 4 => "Four"
    case 5 => "Five"
    case 6 => "Six"
  }

pf orElse pf2相当于

val pf: PartialFunction[Int, String] = {
    case 1 => "One"
    case 2 => "Two"
    case 3 => "Three"
    case 4 => "Four"
    case 5 => "Five"
    case 6 => "Six"
  }
andThen
对函数的结果进行下一步的处理。
前提是前一个的偏函数返回值类型是后一个偏函数的输入类型。
如,上面两个函数就是报错。
    pf andThen pf3
    pf3 andThen pf//异常

val pf2: PartialFunction[Int, String] = {
    case 1 => "One"
    case 2 => "Two"
    case 3 => "Three"
    case _ => "else"
  }


  val pf3: PartialFunction[String, String] = {
    case "One" => "One"
    case "Two" => "Two"
    case "Three" => "Three"
    case "else" => "else"
  }
偏函数的意义在于粒度的问题。
可以把一个函数细分,然后在不同的功能的时候对这些函数进行排列组合,自由灵活的达到想要的功能。
柯里化
看代码最直观
  def add(x:Int,y:Int,z:Int) = x+y+z
  def add2(x:Int)(y:Int)(z:Int) = x+y+z
函数add到add2的过程就是柯里化。
两个函数参数类型个数和返回值都是一样的。
但是过程不一样。
函数add直接相加。
函数add2先演变为
val result = add2(x)
再演变为
val  add2(y:Int) = result + y
val result2 = add2(y)
最后是
val add2(z:Int) = result2 + z
val result3 = add2(z)
关于其应用及其意义,参照fold,aggregate。
闭包
闭包函数返回值依赖于函数外部的变量。
  val y : Int = 0
  def f(x:Int) = x + y
  println(f(10))
我们定义了一个形参x,调用的时候传入,另一个函数外部的变量y,是一个自由变量。
这样就定义了一个闭包。
因为它引用到函数外面定义的变量,定义这个函数的过程是将这个自由变量捕获而构成一个封闭的函数。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 迅捷路由器怎么调信号最强,设置时要注意什么?
- 时间:2026-08-27
-

- vivo浏览器怎么卸不掉?原因和解决方法在这里
- 时间:2026-08-27
-

- OPPO R11s黑屏了,怎么强制恢复出厂设置?
- 时间:2026-08-27
-

- 飞利浦显示器包装盒有生产日期和保修期吗?怎么看?
- 时间:2026-08-27
-

- 联想新平板开机必须联网吗?怎么做?
- 时间:2026-08-27
-

- 平板横竖屏切换设置与问题解决
- 时间:2026-08-27
-

- 移动电源容量怎么测?要准备哪些工具?
- 时间:2026-08-27
-

- 荣耀90 Pro防水吗?防水级别多少?怎么用才安全
- 时间:2026-08-27
精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15