AI辅助研发内部复盘:上下文工程与认知解码实践
时间:2026-08-21 | 作者:宇宙开黑者 | 阅读:0摘要
在AI辅助研发的前两篇复盘中,我们分别探讨了“三层控制框架”和“人机协作边界”。然而,当我们真正深入到动辄百万行代码的老项目(Legacy Code)改造现场时,会发现一个更为本质的挑战:认知鸿沟。
AI并不懂你的业务历史,不理解你的数据血缘,更猜不透前人留下的那些“玄学”代码背后的苦衷。直接将AI投入到这样的环境中,无异于让一个不懂路况的赛车手去开一辆刹车失灵的老爷车。
本文作为系列复盘的第三篇,将聚焦于“上下文工程(Context Engineering)”与“认知解码”。我们将跳出简单的Prompt技巧,深入探讨如何通过系统化的手段,将人类工程师对老项目的理解“编译”成AI可执行的指令。
文章包含三个核心实战代码案例:基于AST的遗留系统依赖分析、利用Embedding技术构建项目级知识库以实现RAG(检索增强生成)、以及通过自动化契约测试守护老项目的接口兼容性。
核心目标是展示如何将“理解”工程化,如何让AI真正“读懂”老项目,从而实现从“盲改”到“精修”的质变。

第一章:认知的瓶颈——为什么AI在老项目面前显得“弱智”?
在老项目改造中,我们常感到AI“不好用”。它生成的代码风格不符、逻辑错误,甚至凭空捏造API。
这并不是大模型变笨了,而是我们给它的上下文(Context)严重不足。
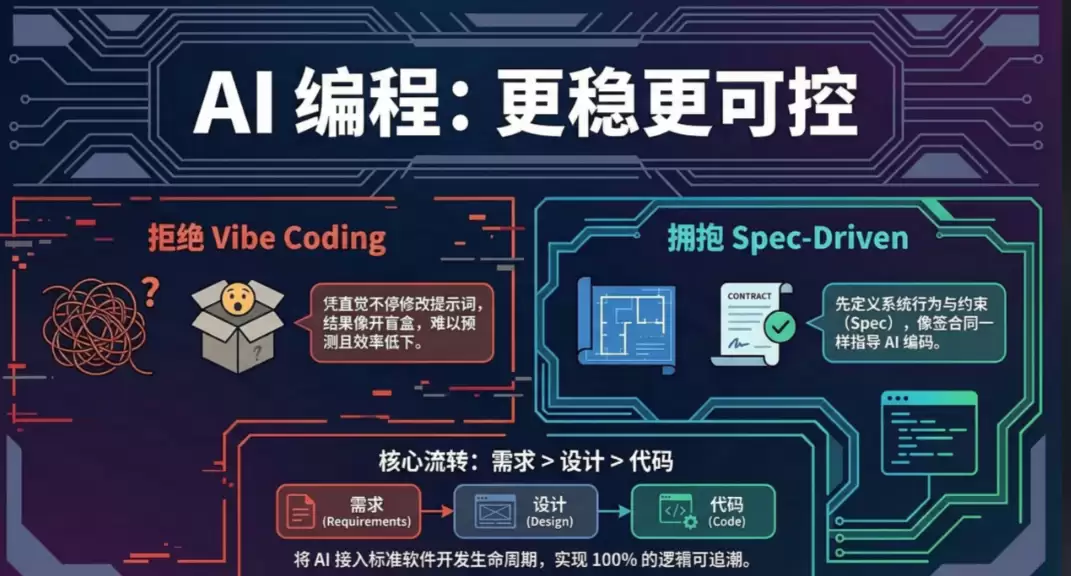
1.1 老项目的“三座大山”
-
隐式知识(Tacit Knowledge):代码通常只写下了“做什么”,真正关键的“为什么要这么做”,往往并不会留在代码里。
比如某个看起来很别扭的
if判断,背后可能是在兼容2015年的某个特定浏览器,也可能是为了绕开一个后来已经修复的数据库Bug。问题就在这里:AI只能看到眼前的代码,看不到Git提交记录里的来回讨论,也读不到那些早就被删掉的Jira工单。
-
熵增与腐烂(Entropy & Rot):老项目充满了“技术债”。变量命名随意(
a,b,temp)、函数职责混乱、注释与代码脱节。AI基于统计概率生成代码。它会倾向于生成“看起来正确”的通用代码,而不是符合当前项目混乱现实的代码。
-
长尾依赖(Long-tail Dependencies):老项目往往依赖特定版本的库、特定的操作系统环境或特定的硬件配置。
AI的训练数据通常偏向主流和最新的技术栈,对这些长尾、陈旧的配置缺乏认知。
1.2 从“提示词”到“上下文工程”
解决上述问题的关键,在于从“如何问问题(Prompting)”转变为“如何构建环境(Context Engineering)”。
提示词是线性的、临时的。
上下文工程是立体的、持久的。它包括:
规则层:定义什么是“好代码”(如
CLAUDE.md)。知识层:提供项目专属的背景知识(如业务术语表、架构决策记录 ADR)。
记忆层:让AI记住之前的对话和修改历史。
检索层:在庞大的代码库中实时检索相关信息(RAG)。
接下来的三个案例,将分别展示如何构建这四个层面,以攻克老项目改造的难题。
第二章:案例一——基于AST的依赖分析与“理解”工程化

场景痛点
接手一个庞大的单体Ja va老项目,需要重构核心支付模块。
但该模块调用了数十个其他模块的Service,且很多调用是隐式的(如反射、XML配置)。人工梳理依赖关系需要数周,且极易遗漏。
解决方案
利用抽象语法树(AST)进行静态代码分析,并将分析结果转化为AI可理解的“知识图谱”。
这不仅是理解项目的过程,也是为AI构建“记忆层”的过程。
代码实现
Step 1: 编写AST解析脚本,提取调用关系
我们使用 tree-sitter 库,因为它对多种语言支持良好,且适合在Python环境中处理。
# ast_analyzer.pyfrom tree_sitter import Language, Parserimport jsonimport os# 1. 加载语言库(需提前编译)# git clone https://github.com/tree-sitter/tree-sitter-ja va.git# gcc -o ja va.so -shared -fpic ja va/src/parser.c -Ija va/srcJA VA_LANGUAGE = Language('./build/ja va.so', 'ja va')parser = Parser()parser.set_language(JA VA_LANGUAGE)def analyze_ja va_file(file_path):"""解析单个Ja va文件,提取类名、方法名和被调用的其他方法"""with open(file_path, 'rb') as f:source_code = f.read()tree = parser.parse(source_code)root_node = tree.root_noderesult = {"file": file_path,"classes": [],"methods": [],"calls": [] # 存储方法调用关系}# 查询类定义class_query = JA VA_LANGUAGE.query("""(class_declarationname: (identifier) @class_name) @class_def""")# 查询方法定义method_query = JA VA_LANGUAGE.query("""(method_declarationname: (identifier) @method_nameparameters: (formal_parameters) @paramsbody: (block) @body) @method_def""")# 查询方法调用call_query = JA VA_LANGUAGE.query("""(method_invocationobject: (identifier) @receivername: (identifier) @method_namearguments: (argument_list) @args) @call""")# 提取类for node, name in class_query.captures(root_node):if name == "class_name":result["classes"].append(node.text.decode())# 提取方法和调用current_method = Nonefor node, name in method_query.captures(root_node):if name == "method_name":current_method = node.text.decode()result["methods"].append(current_method)for node, name in call_query.captures(root_node):if name == "call":# 简化逻辑:记录调用者和被调用者call_info = node.text.decode()result["calls"].append({"caller": current_method,"callee": call_info})return resultdef scan_project(project_path):"""扫描整个项目"""project_knowledge = []for root, _, files in os.walk(project_path):for file in files:if file.endswith(".ja va"):full_path = os.path.join(root, file)analysis_result = analyze_ja va_file(full_path)project_knowledge.append(analysis_result)return project_knowledgeif __name__ == "__main__":# 假设项目路径为 /legacy-projectknowledge_base = scan_project("/legacy-project")# 将分析结果保存为JSON,作为AI的上下文知识库with open("project_knowledge.json", "w") as f:json.dump(knowledge_base, f, indent=2)print("项目知识图谱构建完成,共分析 {} 个文件。".format(len(knowledge_base)))
Step 2: 将知识图谱转化为AI的“系统提示”
有了 project_knowledge.json,我们可以在每次与AI交互时,加载相关的上下文。
# ai_context_builder.pyimport jsondef build_context_for_refactoring(target_module, knowledge_base_path="project_knowledge.json"):"""为目标模块构建AI上下文"""with open(knowledge_base_path, 'r') as f:kb = json.load(f)context = "你是一个资深的Ja va架构师,正在进行老项目重构。以下是当前项目的依赖分析报告:nn"# 筛选与目标模块相关的信息relevant_info = []for item in kb:# 简单匹配:如果文件路径包含目标模块名if target_module in item["file"]:summary = f"文件: {item['file']}n"summary += f"定义的类: {', '.join(item['classes'])}n"summary += f"定义的方法: {', '.join(item['methods'])}n"# 找出外部调用external_calls = [c['callee'] for c in item['calls'] if c['caller']]if external_calls:summary += f"调用了外部方法: {', '.join(set(external_calls))}n"relevant_info.append(summary)if not relevant_info:return "未找到相关模块信息。"context += "n---n".join(relevant_info)context += "nn请根据上述依赖关系,分析重构风险,并提出兼容方案。"return context# 示例:为支付模块构建上下文prompt = build_context_for_refactoring("com/example/payment")print(prompt)# 将此 prompt 发送给 AI...Step 3: AI 基于上下文的分析输出
现在,AI不再盲目建议,而是基于事实进行分析。
案例价值
此案例展示了“理解工程化”。我们没有指望AI自己去“猜”依赖关系,而是通过AST工具将隐式的代码关系显式化,并喂给AI。
这使得AI的分析从“直觉”变成了“有据可依”。
第三章:案例二——基于RAG的项目知识库与“记忆”工程化

场景痛点
老项目文档缺失,仅有的一些Wiki也已过时。新人入职或老项目改造时,需要反复询问老员工。
我们希望建立一个“项目问答机器人”,能够随时解答关于代码逻辑、业务背景的问题。
解决方案
可以借助向量数据库(Vector Database)和嵌入模型(Embedding Model),搭建一套检索增强生成(RAG)系统。
做法并不复杂:把代码、注释、Git 提交信息以及分散的文档内容统一向量化,沉淀进知识库里。
等用户发起提问时,系统会先把相关知识检索出来,再由 AI 结合这些检索结果给出回答。
代码实现
Step 1: 数据预处理与向量化
我们需要将不同类型的知识(代码、Git Log、文档)清洗并切块(Chunking)。
# rag_data_preparation.pyimport osimport gitimport tiktokenfrom langchain.text_splitter import RecursiveCharacterTextSplitterfrom langchain_community.vectorstores import Chromafrom langchain_community.embeddings import HuggingFaceEmbeddings# 1. 加载代码和文档def load_code_files(project_path):docs = []for root, _, files in os.walk(project_path):for file in files:if file.endswith(('.ja va', '.xml', '.properties', '.md')):path = os.path.join(root, file)with open(path, 'r', encoding='utf-8', errors='ignore') as f:content = f.read()docs.append({"source": path, "content": content})return docs# 2. 加载Git提交历史(挖掘隐性知识)def load_git_history(repo_path):repo = git.Repo(repo_path)commits = list(repo.iter_commits())history_docs = []for commit in commits[:200]: # 限制数量message = commit.message.strip()diff = commit.diff(commit.parents[0] if commit.parents else None, create_patch=True)for item in diff:if item.diff:history_docs.append({"source": f"Commit: {commit.hexsha[:8]}","content": f"提交信息: {message}n代码变更:n{item.diff.decode('utf-8', 'ignore')}"})return history_docs# 3. 文本切块def split_documents(docs):text_splitter = RecursiveCharacterTextSplitter(chunk_size=1000,chunk_overlap=200,length_function=len,separators=["nclass ", "npublic ", "nprivate ", "n# ", "n// ", "nn", "n", " ", ""])chunks = []for doc in docs:splits = text_splitter.split_text(doc["content"])for split in splits:chunks.append({"source": doc["source"], "content": split})return chunks# 4. 创建向量库def create_vector_store(chunks, persist_directory="./chroma_db"):embeddings = HuggingFaceEmbeddings(model_name="sentence-transformers/all-MiniLM-L6-v2")vectorstore = Chroma.from_texts(texts=[chunk["content"] for chunk in chunks],metadatas=[{"source": chunk["source"]} for chunk in chunks],embedding=embeddings,persist_directory=persist_directory)vectorstore.persist()print(f"向量库创建完成,共存储 {len(chunks)} 个文本块。")if __name__ == "__main__":project_path = "/legacy-project"print("开始加载代码文件...")code_docs = load_code_files(project_path)print(f"加载了 {len(code_docs)} 个文件。")print("开始加载Git历史...")git_docs = load_git_history(project_path)print(f"加载了 {len(git_docs)} 条提交记录。")all_docs = code_docs + git_docsprint("开始切块...")chunks = split_documents(all_docs)print(f"切分得到 {len(chunks)} 个文本块。")print("开始创建向量库...")create_vector_store(chunks)print("项目知识库构建完毕!")Step 2: 构建RAG问答系统
有了向量库,我们就可以实现一个简单的问答接口。
# rag_qa_system.pyfrom langchain_community.vectorstores import Chromafrom langchain_community.embeddings import HuggingFaceEmbeddingsfrom langchain.chains import RetrievalQAfrom langchain_community.chat_models import ChatOllama # 假设使用本地Ollama运行的模型def setup_qa_chain(persist_directory="./chroma_db"):embeddings = HuggingFaceEmbeddings(model_name="sentence-transformers/all-MiniLM-L6-v2")vectorstore = Chroma(persist_directory=persist_directory, embedding_function=embeddings)# 使用本地大模型,保护代码隐私llm = ChatOllama(model="qwen2:7b-instruct") qa_chain = RetrievalQA.from_chain_type(llm=llm,chain_type="stuff",retriever=vectorstore.as_retriever(search_kwargs={"k": 5}), # 检索最相关的5个块return_source_documents=True)return qa_chaindef ask_question(qa_chain, question):print(f"问题: {question}")result = qa_chain.invoke({"query": question})print("n答案:")print(result["result"])print("n参考来源:")for doc in result["source_documents"]:print(f"- {doc.metadata['source']}")if __name__ == "__main__":qa_chain = setup_qa_chain()# 示例问题1:关于业务逻辑ask_question(qa_chain, "为什么UserServiceImpl里的getUserInfo方法要判断null?")# 示例问题2:关于历史包袱ask_question(qa_chain, "三年前是谁修改了PaymentService,为什么要加那个try-catch?")案例价值
此案例实现了“记忆工程化”。AI不再仅仅依赖训练时的通用知识,而是拥有了针对当前项目的“私人记忆”。
通过RAG,我们解决了大模型“幻觉”问题,让AI的回答有了确切的依据(Source Documents)。
这对于理解老项目的“历史原因”至关重要。
第四章:案例三——契约测试与“验证”工程化

场景痛点
在老项目中修改代码,最怕“改坏”了。特别是修改公共模块或接口时,可能会影响下游未知的调用方。
传统的单元测试只能保证内部逻辑正确,无法保证对外契约的稳定性。
解决方案
引入契约测试(Contract Testing),并利用AI自动生成和维护测试用例。
我们将Pact框架与AI结合,让AI理解接口定义,并生成各种正常和异常的测试场景。
代码实现
Step 1: 定义契约(Pact文件)
契约文件描述了消费者(Consumer)对提供者(Provider)的期望。
# pacts/UserServiceClient-UserService.json{"consumer": { "name": "UserServiceClient" },"provider": { "name": "UserService" },"interactions": [{"description": "获取用户信息,用户存在","request": {"method": "GET","path": "/users/123","headers": { "Accept": "application/json" }},"response": {"status": 200,"headers": { "Content-Type": "application/json" },"body": {"id": "123","name": "张三","age": 30,"role": "admin"}}},{"description": "获取用户信息,用户不存在","request": {"method": "GET","path": "/users/999"},"response": {"status": 404}}]}
Step 2: 利用AI生成测试桩(Provider States)
老项目中,数据库环境复杂,很难构造测试数据。我们可以利用AI根据契约自动生成测试桩代码。
# ai_test_stub_generator.pyimport jsondef generate_spring_test_stub(pact_file_path):"""根据 Pact 文件生成 Spring Boot 的测试桩代码"""with open(pact_file_path, 'r') as f:pact = json.load(f)provider_name = pact['provider']['name']interactions = pact['interactions']test_code = f"""import org.junit.jupiter.api.Test;import org.springframework.beans.factory.annotation.Autowired;import org.springframework.boot.test.autoconfigure.web.servlet.WebMvcTest;import org.springframework.test.web.servlet.MockMvc;import static org.springframework.test.web.servlet.request.MockMvcRequestBuilders.*;import static org.springframework.test.web.servlet.result.MockMvcResultMatchers.*;@WebMvcTest({provider_name}Controller.class)class {provider_name}ContractTest {{@Autowiredprivate MockMvc mockMvc;// AI Generated Test Stubs based on Pact Interactions"""for interaction in interactions:desc = interaction['description'].replace(' ', '_')req = interaction['request']res = interaction['response']test_code += f"""@Testvoid {desc}() throws Exception {{// Given: Provider State Setup// TODO: AI suggests setting up DB state here based on '{interaction['description']}'// e.g., if description contains '用户存在', ensure user 123 is in DB.// When & ThenmockMvc.perform({req['method']}("{req['path']}").accept("{res['headers'].get('Content-Type', 'application/json')}")).andExpect(status().is({res['status']}));// Additional assertions for response body"""if 'body' in res:# 简单示例:验证JSON字段存在for key in res['body']:test_code += f""".andExpect(jsonPath("$.{key}").exists());n"""else:test_code += "}n"test_code += "}n"return test_code# 生成测试代码stub_code = generate_spring_test_stub("pacts/UserServiceClient-UserService.json")print(stub_code)# 将代码写入文件with open("UserServiceContractTest.ja va", "w") as f:f.write(stub_code)Step 3: 自动化验证流水线
我们将上述过程集成到CI/CD流水线中:
AI 扫描:每次代码提交,AI 扫描接口定义的变化。
契约更新:如果接口变化,AI 辅助更新 Pact 文件。
测试生成:AI 根据新的 Pact 文件生成测试桩。
执行验证:运行契约测试,确保老接口的行为未被破坏。
案例价值
此案例实现了“验证工程化”。契约测试是保护老项目的“安全阀”。
通过AI自动生成测试桩,我们解决了老项目测试数据难构造、测试代码维护成本高的痛点。
这使得我们可以放心大胆地使用AI进行重构,因为任何破坏兼容性的行为都会被契约测试立即捕获。
第五章:综合复盘——构建AI时代的“理解-约束-验证”闭环

将上述三个案例串联起来,我们构建了一个完整的AI辅助老项目改造闭环:
-
理解阶段(案例一):利用AST分析工具,将代码的静态结构转化为知识图谱。
这解决了“项目长什么样”的问题。
-
记忆阶段(案例二):利用RAG技术,将代码、文档、历史记录向量化,构建项目专属知识库。
这解决了“为什么这样写”的问题。
-
验证阶段(案例三):利用契约测试和AI生成的测试代码,建立自动化防护网。
这解决了“改了会不会坏”的问题。
在这个闭环中,AI不再是一个孤立的聊天窗口,而是深度嵌入到研发流程的各个角落。
人类工程师的角色也从“代码编写者”转变为“上下文管理者”和“质量守门人”。
5.1 关键心得
-
垃圾进,垃圾出(GIGO):AI的输出质量完全取决于输入的上下文质量。
花时间构建高质量的上下文(规则、知识库、测试),是所有工作的前提。
-
工具链思维:不要指望一个Chatbot解决所有问题。
需要将AI能力与AST解析器、向量数据库、CI/CD流水线等传统工具链深度集成。
-
持续迭代:上下文工程不是一劳永逸的。
随着项目的演进,知识库需要更新,规则文件需要调整,测试需要补充。
5.2 团队落地建议
建立项目知识库:立即开始为你的老项目构建RAG知识库。 这是ROI最高的投资。
标准化规则文件:在团队内统一
CLAUDE.md或.cursorrules的格式和内容,确保AI行为的一致性。推广契约测试:在涉及核心接口的项目中,强制引入契约测试,并将其作为AI辅助重构的安全基线。
结语

老项目改造是一场艰苦的战役,但AI为我们提供了前所未有的武器。
通过本篇复盘介绍的上下文工程技术,我们可以将“理解”这一最困难、最耗时的环节工程化、自动化。
我们不再是盲人摸象,而是拥有了一张清晰的地图和一个强大的导航系统。
在未来的复盘中,我们将进一步探讨如何利用AI进行架构级别的重构决策,以及如何管理AI辅助开发带来的新型技术债。
请持续关注本系列,与我们一同探索AI时代的软件工程之道。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 字节跳动发布豆包工作 与飞书深度打通构建企业级Agent
- 时间:2026-08-25
-

- AI通话录音手机续航实测能用多长时间
- 时间:2026-08-23
-

- Adobe Photoshop 27.7桌面版发布 移除工具支持端侧AI运行 苹果Mac需24GB内存
- 时间:2026-08-23
-

- 育碧远哭7测试AI生成画面效果 知情者评价其表现不佳
- 时间:2026-08-23
-
- AMD锐龙9 PRO 9965X3D及锐龙AI PRO 400商用台式机2026Q3上市
- 时间:2026-08-22
-
- 思必驰冲刺上市,AI语音行业护城河为何消失
- 时间:2026-08-21
-
- 道题看懂AI商业趋势与未来发展方向
- 时间:2026-08-21
-
- AI清理500GB空间实测:Agent暂时还替代不了电脑管家
- 时间:2026-08-21
精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15