NVIDIA Cosmos 3世界动作模型如何构建机器人控制策略
时间:2026-08-21 | 作者:星河游者 | 阅读:0机器人策略泛化的核心挑战
机器人领域的一个核心挑战,是构建超越其训练演示的泛化策略。
当物体形状、位置或照明发生变化时,在训练场景中取得成功的策略通常会失败。
泛化到这些新条件,要求策略理解任务背后的物理基础,而不仅仅是模拟演示。这种能力来自于其构建的主干。
从 VLA 到 WAM 的转变
构建语言条件机器人策略的标准方式,是在预训练的视觉语言模型(VLM)中添加动作模块,从而生成视觉语言动作(VLA)模型。
这种方法在多面手操控中,发挥了重要作用。
然而,VLM主干是用于学习描述世界,而非预测世界的演变。
当任务依赖于预测场景变化时,机器人所需的正是这种缺失的动态模型。
于是,越来越多的研究人员,开始用视频世界模型取代语言主干,生成世界动作模型(WAM)。
NVIDIA研究人员Jim Fan,在他的机器人开发结束演讲中,探讨了这一转变,这一想法后来被总结为“VLA已死,世界动作模型万岁”
本文将探讨后训练如何将 WAM 转变为专门的机器人策略,WAM 与 VLA 相比如何,以及为什么开放的 NVIDIA Cosmos 3 世界模型为构建 WAM 奠定了坚实的基础。
现在如何构建经过后训练的策略
在 VLA 范式中,预训练的 VLM 提供对场景和语言指令的语义理解,而后训练则学习将这种理解映射到机器人动作。
现代通用机器人策略越来越多地建立在这种方法之上。
不过,VLM经过优化后,能够生成与图像相关的文本,但却无法对场景的演变方式进行建模。
它无法知晓抓手闭合时杯子的状态。
它无法知晓毛巾是如何折叠的。
它也无法知晓物体松开后会落在哪里。
VLA在语义方面具有良好的泛化能力,但在对不可见的行为和环境进行物理泛化时效果欠佳。
原因在于,它们的核心是模型语言和感知,而非世界动态。
WAM 的变化
WAM 通过在视频世界模型上构建策略,来克服动态建模的限制。
由于主干模型对世界的演变方式进行建模,后训练不必从头开始教授动力学。
因此,它专门用于已经具有物理学基础的模型。
NVIDIA 研究论文 World Action Models is Zero-shot Policies 表明,联合预测视频和动作可提供 VLA 无法轻松获取的策略属性:
-
它从不同的数据中学习。VLA 会学习将指令映射到轨迹,并且通常需要对同一任务进行近乎相同的演示。
WAM 学习物理:物体在推、抓或丢弃时的移动方式。任何交互数据都能让它有所收获。
在 VLA 上浪费的各种数据集,会成为训练信号,而数据收集会变得更便宜。
-
它在开放世界中泛化。物理学比语义学更具有通用性。
物体下落或滑动的方式不会随着物体的变化而改变,因此已学习动力学的模型,会将该知识带入从未接受过训练的场景和动作中。
-
它只需很少的演示就能适应新的机器人。理解物理交互的模型需要的任务特定数据少之又少,因此无法专门用于新的机械臂或机械手。
对于制定策略的团队而言,以下是实际的优势:
达到给定能力所需的数据更少
训练分布之外的行为更好
实现新实施的路径更短
它们是预训练主干的属性,因此它们显示在每个经过后训练的策略中。
Cosmos 3 是强大的 WAM 基础
Cosmos 3 是一个基于 Mixture-of-Transformer (MoT) 架构构建的全模型世界基础模型。
多模态输入流经自回归 Transformer,用于推理生成文本等离散 token。
这将引导扩散转换器实现连续的模态,包括图像、视频、音频和动作。
文本由 next-token 解码生成;其他一切 (包括动作) 均通过迭代降噪合成。
单个模型涵盖这些模态,同时保持生成机制最适合每个模态。
Cosmos 3 有三种尺寸:4B NVIDIA Cosmos Edge、16B NVIDIA Cosmos Nano 和 64B NVIDIA Cosmos 3 Super。
Cosmos 3 拥有广泛的物理世界数据,是后训练的坚实基础。
该数据集包括大约 7.67 亿张图像、3.48 亿个真实世界动态视频,以及涵盖机器人操作、自动驾驶、摄像头运动和以自我为中心运动的 800 万个动作样本。

图 1. VLA 根据语义推理和机器人状态生成机器人动作,而 WAM 联合预测动作和未来世界状态
从世界模型到机器人策略
Cosmos 3 策略 DROID 模型
Cosmos 3 是实现专业化的起点。
Cosmos3-Nano – policy-DROID 是 Cosmos 3 Nano 为 DROID 平台提供的 160B 参数后训练策略,DROID 平台是一个带有 Robotiq 抓手的 Franka Panda ARM。
4B 版本 Cosmos3-Edge-Policy-DROID 也以同样的方式进行后训练,可用于设备端部署。
给定语言指令和多摄像头观察,它将生成机器人动作轨迹。
其 Omni 基础包含三个属性:
-
它在行动时想象。当模型输出动作时,还可以输出视频:如果执行这些动作,机器人的摄像头会看到什么。
动作和预测结果同时来自同一模型。
-
它保留了完整的 Omni 架构。后训练不会删除任何内容。
策略检查点仍然可以进行推理并生成视频,而不仅仅是输出关节位置。
-
先验是可测量的。Cosmos 3 技术报告比较了使用相同的方法、数据和计算进行训练的两种 DROID 策略。
一个从基础检查点开始,而另一个从使用多域动作数据训练的 Omni 检查点开始。
Omni Checkpoint 将 RoboLab 的成功率从 28.1%提高到 36.8%。
这清楚地表明,这种改进来自于架构,而不仅仅是规模。
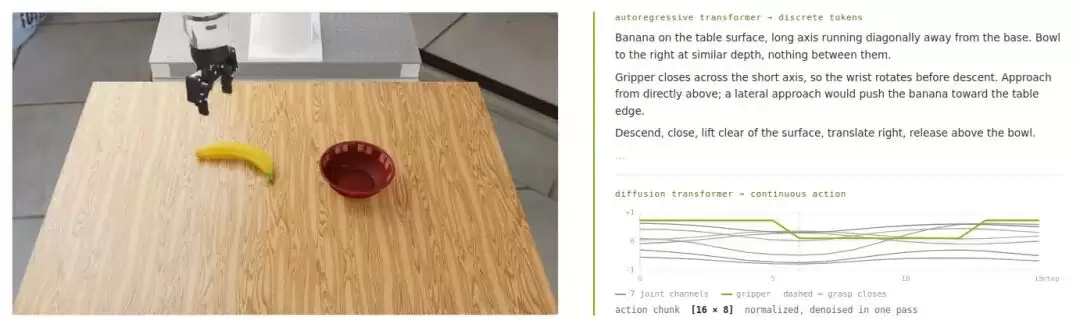
图 2. 机器人在桌面上观察到一根香蕉 (左) ;该模型的预测行动计划显示为文本
部署注意事项
WAM 承载着完整的生成式世界模型,而不仅仅是动作头部。
它比紧凑型 VLA 大,但 Cosmos 3 会映射到不同的部署层,而不是强制进行一次权衡:
-
工作站服务 ( Nano,16B) 。Cosmos3-Nano – policy 在机器人旁边运行,而不是在板载上运行。
现实世界的 DROID 部署在单个 NVIDIA RTX PRO 6000 上为其提供服务,机器人通过网络流式传输观察结果,并接收返回的动作块。
-
设备端 (边缘、4B) 。Cosmos 3 Edge 直接在嵌入式硬件上运行相同的策略工作负载。
它以机器人控制分辨率 ( 640 × 360 观察) 运行,并在 NVIDIA Jetson Thor 上生成每次推理的 32 项操作,同时实现 15 Hz 的实时控制。
NVIDIA 边缘计算机 (包括 RTX PRO GPU、DGX、GeForce RTX GPU 和 Jetson,包括新的 Jetson T2000 和 T3000 模组) 均支持此功能。
为何使用 Cosmos 3 构建机器人策略?
WAM 代表着从学习到行动到学习世界如何演变的转变。
Cosmos 3 使这种方法切实可行:
-
开放的基础,SOTA 的起点。基础模型、数据集、后训练配方、经过训练的权重、评估工具和服务堆栈均根据允许商业用途的许可证发布。
-
更快的适应。强物理先验会减少新策略所需的任务特定数据。
将您的数据转换为机器人学习生态系统已记录的 LeRobotDataset 格式,然后运行已发布的 recipe。
-
一个基础,许多机器人。每个新化身,例如 Franka、双臂设置、UR、WidowX,仍然需要自己的后训练运行。
但所有这些模型都从相同的预训练基础开始,而不是从头开始预训练世界模型,从而减少了每个模型所需的演示。
开始使用
评估 WAM 是否优于当前 VLA 的最快方法,是使用您自己的数据对 Cosmos 3 中的 WAM 进行后训练并进行比较。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- Cosmos 3:英伟达开源全模态物理AI基础大模型介绍
- 时间:2026-08-21
-
- 英伟达推出轻量化全模态物理AI世界模型 Cosmos 3 Edge
- 时间:2026-07-27
-
- 英伟达开源4B参数世界模型Cosmos 3 Edge
- 时间:2026-07-25
-
- NVIDIA正式推出Cosmos 3开放物理人工智能世界基础模型
- 时间:2026-07-24
-
- Cosmos 3 Edge 详尽完整版从零开始全面介绍与深度解析
- 时间:2026-07-21
-
- 清华团队推出AI学习神器Cosmos对话即学习
- 时间:2026-07-18
精选合集
更多大家都在玩
大家都在看
更多-

- 八大山人是谁
- 时间:2026-09-21
-
- 精浓度越高,消毒效果越好吗 蚂蚁庄园今日答案9.22
- 时间:2026-09-21
-
- 蚂蚁庄园今天答题答案2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园答题今日答案2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园小课堂2026年9月22日最新题目答案
- 时间:2026-09-21
-
- 小鸡答题今天的答案是什么2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园每日答题答案2026年9月22日
- 时间:2026-09-21
-
- 以下哪一项是闽南地区的特色小吃 蚂蚁庄园今日答案9月22日
- 时间:2026-09-21