字节开源Bernini统一框架:提升DiT视频编辑理解与生成能力
时间:2026-08-21 | 作者:星河游者 | 阅读:0AI视频编辑先理解再动手
视频生成这事儿,最让创作者头疼的,往往不是画质不够好,而是模型压根听不懂人话。
想把晴天改成雪天,它可能只会往画面上撒几片雪花。
想把一段动画塞进商场LED大屏,结果边界乱飘、透视不稳。
问题就在于:AI视频生成,能不能先理解创作者到底想改什么,再动手?
就在最近,字节商业化技术团队给出了一个行业新解法——开源了面向视频生成与视频编辑的统一框架:Bernini。
核心思路很直接:让多模态大模型先负责语义理解与规划,再交给diffusion模型完成高质量视觉渲染。
它覆盖参考生成、视频编辑等多种任务,重点就两个字:可控。
比如改变整体视觉风格时,不只是单帧画得好看,前后帧的一致性也稳住了:
这让AI视频生成从“听prompt干活”,向“先理解、再动手”又迈进了一步。
目前Bernini的推理代码和权重已经开放。
一条指令改视频,Bernini轻松拿捏「可控编辑」
过去很多视频生成模型,更像是按提示词出片。
而Bernini想解决的是一个更实际的问题:生成之后,怎么继续改?
日常调整需求听起来简单,但对视频模型并不容易。
因为视频编辑不是改一张图,而是要在一段连续画面里,既听懂指令,又保住主体、结构、镜头和运动关系。
稍微处理不好,就会出现主体变形、背景漂移、动作断裂、帧间闪烁等问题。
Bernini的核心思路,正是把这个过程拆得更清楚。

可以把Bernini理解成一个AI视频片场里的「导演+后期团队」。
负责导演的是多模态大模型规划器MLLM-based planner。它会先看懂你的文本指令,同时理解源视频、参考图片、参考视频这些素材,判断目标画面应该变成什么样。
等这一步想清楚后,再交给diffusion模型DiT-based renderer完成视觉渲染,把规划好的语义目标,真正变成连续、稳定、高质量的视频画面。

Bernini框架的妙处就在于分工足够清楚:多模态大模型负责想明白,Diffusion Transformer负责生成出来。
从文本到视频生成,到视频编辑,再到基于图像和视频参考的复杂控制生成,全部覆盖。
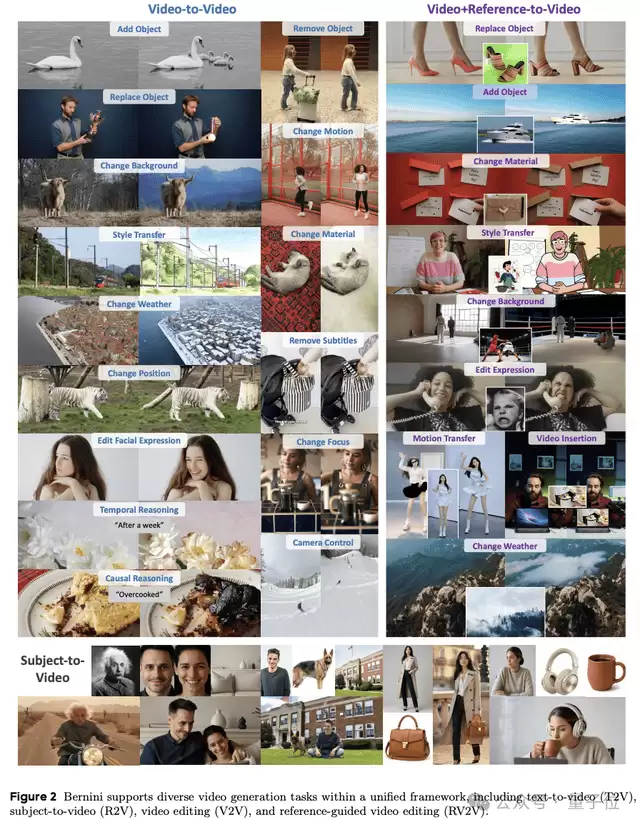
这套分工,也让Bernini在视频可控编辑上展现出一批相当直观的能力。
基础编辑:一条指令改天气、季节、材质和风格
最基础的能力,是一条指令改变天气、季节、材质和风格。
比如同一段城市航拍视频,输入指令后,可以从晴天切到雾天、雨天、雪天。
关键不只是天上多几片雪、画面加一层滤镜,而是连带调整天空、光照、路面、建筑表面和整体环境氛围,让天气变化看起来像真的发生在原场景里:

进阶编辑:开始进入「镜头语言」
更进一步,Bernini的语义编辑已经开始进入「镜头语言」。
首先,它能控制画面关注区域的视角、焦点和动作。
在视角编辑上,Bernini能进一步理解场景里的三维关系。
因此,视角调整结果更符合透视、结构和空间逻辑:

在焦点编辑能力上,Bernini还能够根据指令调整画面的关注区域,让视频叙事重心随之改变。
比如一个画面里有多个物体,可以让镜头更关注桌上的收音机,也可以让焦点从前景转到背景:

视频创作里最容易卡bug的,还有动作。
很多AI视频静止看还行,一动起来就露馅。
值得一提的是,Bernini在保留主体身份和场景结构的前提下,可以高精准度地改变主体动作行为。
下面这段棕熊视频,哪怕从普通状态改成起身跳舞、咆哮,环境、光照和镜头关系依然能保持稳定:

这意味着,Bernini改视频不只是让主体「动起来」,还要让动作变化「自然嵌进」原来的画面里。
从反复抽卡到哪里不对改哪里,AI视频终于开始有点后期软件的味儿了。
参考素材上场,视频创作更可控、更一致
AIGC内容创作时,还有一个常见问题:很难用一句prompt精确描述想要的视觉效果。
尤其碰到具体材质、某个商品、某种电影色调,或者需要植入到屏幕里的视频素材时,更容易翻车。
Bernini除了编辑能力,还有一个很实用的功能:支持图片和视频作为编辑参考。
它还能基于参考输入直接生成新视频,把物体、角色和场景的一致性问题拿捏得更稳。
不只靠prompt:用图片和视频作为编辑参考
先看Bernini参考生成的第一个能力——编辑参考。
它让创作者直接用视觉样例控制结果,广告创意、电商展示、影视预演、二次创作都可以直接受益。
参考主体:指定元素自然融入画面
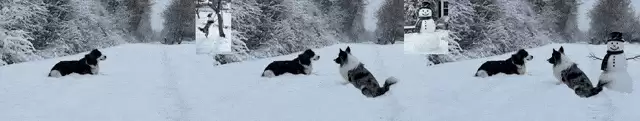
比如增加指定主体的案例,只需要放入一张狗狗参考图,视频里就能自然出现同款狗狗。
再输入一张雪人图片,雪人也能顺滑融进当前视频里,光照、透视、边缘关系都处理得非常自然:
参考材质:纹理变化稳定保留
除了参考主体,Bernini还能参考材质。
给它布料、朱砂壶、大理石、金属等不同材质参考,原视频里的盘子就可以被改成对应纹理视觉质感。
而且材质变化会跟着目标物体稳定存在,而不是播放几帧就漂移、错位或失真:

参考风格与内容植入:从风格迁移到屏幕替换
风格参考也不在话下。
哪怕参考图横跨卡通、写实、水墨、赛博朋克等完全不同的视觉风格,Bernini也能提取风格特征并迁移到视频里。
原视频里的主体和运动关系也会高度保留,风格变化随着时间轴稳定延续。
此外,Bernini还有一类很实用的能力:图像与视频植入。
街头灯箱、商场LED大屏、地铁电视,甚至镜头里任何一块屏幕,都可以变成展示位。
Bernini能把一张海报、一段视频精准填进目标区域里,还能跟着原片镜头一起移动,边界不破、透视不乱、时序不抖。
例如给一段街头实拍再提供一张油画图片,Bernini就能把油画自然贴进招牌里,画面融合度非常强。
广告预览、影视预演、虚拟拍摄里,很多原本要反复抠帧、跟踪、校透视的工作,这下也能被收进一次推理里了。
从参考图生成视频:更一致的物体、角色和场景
除了编辑已有视频,Bernini还支持基于参考图直接生成「新视频」。
单图参考生成:既能做产品片,也能做创意短片
先看单图参考生成。
只给一张香水产品图,再输入「生成一段产品展示视频」,模型就能生成真人手持香水转动的画面。
瓶身轮廓、金色液体、黑色标贴这些关键细节,都能和原图保持很高的一致性。
换成一条运动头带,再让模型自由发挥,还能生成一只羊驼戴着头带站在沙漠的画面。
同一个能力,既能做正经产品片,也能搞脑洞创意短片。
多元素组合参考生成:分散素材重组为统一角色
再进一步,Bernini还能实现多元素组合参考生成。
喂进去的参考图不一定需要来自同一个物体。
比如一座大理石半身像、一副粉色猫耳耳机、一件黑色T恤、一条热带印花短裤,再加一张落日海滩长椅。
几张图原本八竿子打不着,Bernini却可以把它们组合成同一个视频角色。
这类能力放到IP联名、虚拟人塑造、广告概念片里就很有用。
素材库里原本分散的元素,可以被重新组合成一个全新的角色和场景。
多角度参考:同一物体在不同镜头下保持一致
此外,Bernini还有一个关键能力:同一物体的多角度参考。
商品和角色很少只有一面,包有背带,车有尾灯,雕塑有侧脸和背面。
模型如果只看过正面,镜头一转就容易开始自由发挥。
Bernini可以吃进同一物体的多张角度参考图——比如喂给它大理石雕塑的五张多角度参考,再让它生成一段连续镜头,雕塑从不同角度出现时,五官、肌肉走向、衣袍褶皱都能保持高度一致。
场景关键帧到连续镜头:向世界模型能力靠近
最后是场景关键帧到连续镜头。
给到同一办公区休息廊的几张关键帧,比如沙发、绿植、走廊尽头的玻璃门,Bernini可以生成一段连续平移镜头。
这一步已经开始接近更长线的世界模型能力。
考验的不只是这一帧好不好看,还包括模型能不能理解同一个场景在连续镜头里的空间关系。
虚拟漫游、游戏关卡生成、影视预演,甚至具身智能模拟,往后都绕不开这种连续性。
从语义规划到视觉渲染,Bernini的关键是「先理解,再生成」
那么,Bernini为什么能同时吃文本、视频、参考图,还能把结果做得更稳?
核心原因在于,它没有让一个模型包办所有事情,而是把任务拆成了两步。
第一步:语义规划
第一步是「语义规划」,让模型先理解目标。
Bernini首先使用MLLM-based planner来理解文本、视频和参考视觉输入,并直接在ViT embedding space中预测目标语义表示。
这个目标语义表示可以理解成生成前的一张「语义草图」。
它不直接规定每个像素长什么样,而是先描述清楚:目标视频应该包含什么内容、结构怎么变、哪些元素要保留、哪些地方要被编辑。
第二步:视觉渲染
第二步是「视觉渲染」,把语义转化成高质量视频。
拿到语义规划后,DiT-based renderer负责生成最终画面。
对于视频编辑任务,它还会结合源视频的VAE features,尽量保留原视频里的细节和非编辑区域,避免一改就把整段画面带跑。
多参考输入如何处理
还有一个关键点是「多参考输入」怎么处理。
当多个参考图、源视频、目标视频被串进同一个序列里时,不同素材可能会出现相同的时间和空间坐标,模型容易认混。
所以Bernini引入了Segment-Aware 3D Rotary Positional Embedding,也就是SA-3D RoPE。
它会给不同视觉片段加上各自的segment标记,让模型分清哪个是参考图、哪个是源视频、哪个是目标输出,同时还能保留时间和空间位置关系。
在字节商业化技术团队自建的Arena结果里,面对几款国内外主流闭源模型,这个开源框架已经站进了第一梯队。
说到底,Bernini最让创作者有实感的地方,不只是画面更好看,而是它让AIGC创作少了一点「玄学」。
- 以前写一大段prompt,AI未必懂;
- 以前想改一个小地方,它可能整条视频都重来;
- 以前给了参考图,它也可能只学到一点皮毛,最后主体、材质、风格全都跑偏。
而Bernini解决的,正是这种创作里的失控感。
它先理解用户想要什么,理解原视频里哪些内容要保留,也理解参考图片、参考视频到底提供了什么视觉信息。
然后,再把这种理解转成可以生成、可以编辑、可以稳定落地的视频结果。
少一点反复碰运气,多一点真正可控的创作空间,这也是Bernini最有价值的地方。
让大家用自己的素材、自己的想法,去探索AI视频创作还能怎么变得更好用、更听话、更接近真实创作流程。
目前率先开源的Bernini-R,对应Bernini三阶段训练流程中的第二阶段模型。
包含MLLM Planner的完整版本也在代码整理中,预计近期将进一步开放。
参考链接
- GitHub:https://github.com/bytedance/Bernini
- Hugging Face:https://huggingface.co/ByteDance/Bernini
- Project Page:https://bernini-ai.github.io

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- Seko AI视频Agent官方入口与使用指南2026
- 时间:2026-08-21
-

- 千问App付费方案上线:办公助理最高128元每月,AI视频生成单独收费
- 时间:2026-08-17
-

- AI视频创作别只拼画质,真正稀缺的是创意脑洞
- 时间:2026-08-16
-

- HappyHorse 1.1阿里升级版AI视频生成模型介绍
- 时间:2026-08-15
-
- 英伟达AI视频分析工具实测:整体偏弱但仍有实用价值
- 时间:2026-08-15
-
- AI视频生成7月大战:超200亿资本入场,谁已进入决赛圈
- 时间:2026-08-14
-
- 个智能Agent协同作战,OiiOii开启AI视频分镜导演级创作时代
- 时间:2026-08-13
-

- Vidu Q3角色场景一键锁定 告别AI视频穿帮
- 时间:2026-08-05
精选合集
更多大家都在玩
热门话题
大家都在看
更多-

- 精浓度越高消毒效果越好吗
- 时间:2026-09-22
-
- 蚂蚁庄园每日答题答案2026年9月23日
- 时间:2026-09-22
-
- “秋高气爽”主要是由于秋季空气中哪种成分减少 蚂蚁庄园今日答案9月23日
- 时间:2026-09-22
-
- 农谚“一场秋雨一场寒”描述的是秋季哪种天气现象 蚂蚁庄园今日答案9.23
- 时间:2026-09-22
-
- 蚂蚁庄园今天答题答案2026年9月23日
- 时间:2026-09-22
-
- 蚂蚁庄园答题今日答案2026年9月23日
- 时间:2026-09-22
-
- 蚂蚁庄园小课堂2026年9月23日最新题目答案
- 时间:2026-09-22
-
- 小鸡答题今天的答案是什么2026年9月23日
- 时间:2026-09-22