很多人在把 Job 换成 SupervisorJob 后,第一反应是“子协程明明抛了异常,为什么 child.join() 没报错?”问题不在于协程没失败,而在于 SupervisorJob 改变了失败传播规则。下面按行为差异、代码现象和可落地的处理方式拆开说明,方便你判断什么时候该用它,什么时候又必须自己兜住异常。
Job 和 SupervisorJob 的核心差异
两者最大的区别,不是“能不能创建子协程”,而是子协程失败后是否向上传播。
- 普通 Job(
Job/Job()):一个子协程异常失败后,会自动向父级传播,导致父 Job 立即失败,同时取消其他子协程。这是典型的“失败传播”模型。 - SupervisorJob:子协程失败默认被隔离,不会自动传给父级,也不会连带取消其他兄弟协程。这是 Supervisor 模式的核心,也就是“独立失败”。
如果你的任务集合要求“一个失败,全体收摊”,普通 Job 更符合预期;如果你的任务彼此独立,比如多个 UI 请求、多个后台同步任务,SupervisorJob 更合适。
为什么 child.join() 在两种模型下表现不同
普通 Job:join() 会跟着失败链路感知异常
val job = Job()
val child = launch(job) {
    throw RuntimeException("Child failed")
}
try {
    child.join()  // 异常会在这里被重新抛出!
    println("这行不会执行")
} catch (e: Exception) {
    println("捕获到异常: $e")
}
// 父 job 也已经失败
这里的关键点是:普通 Job 会把子协程失败视为整个任务树的失败。因此,join() 不只是“等它结束”,还会沿着失败传播链路把异常暴露出来。
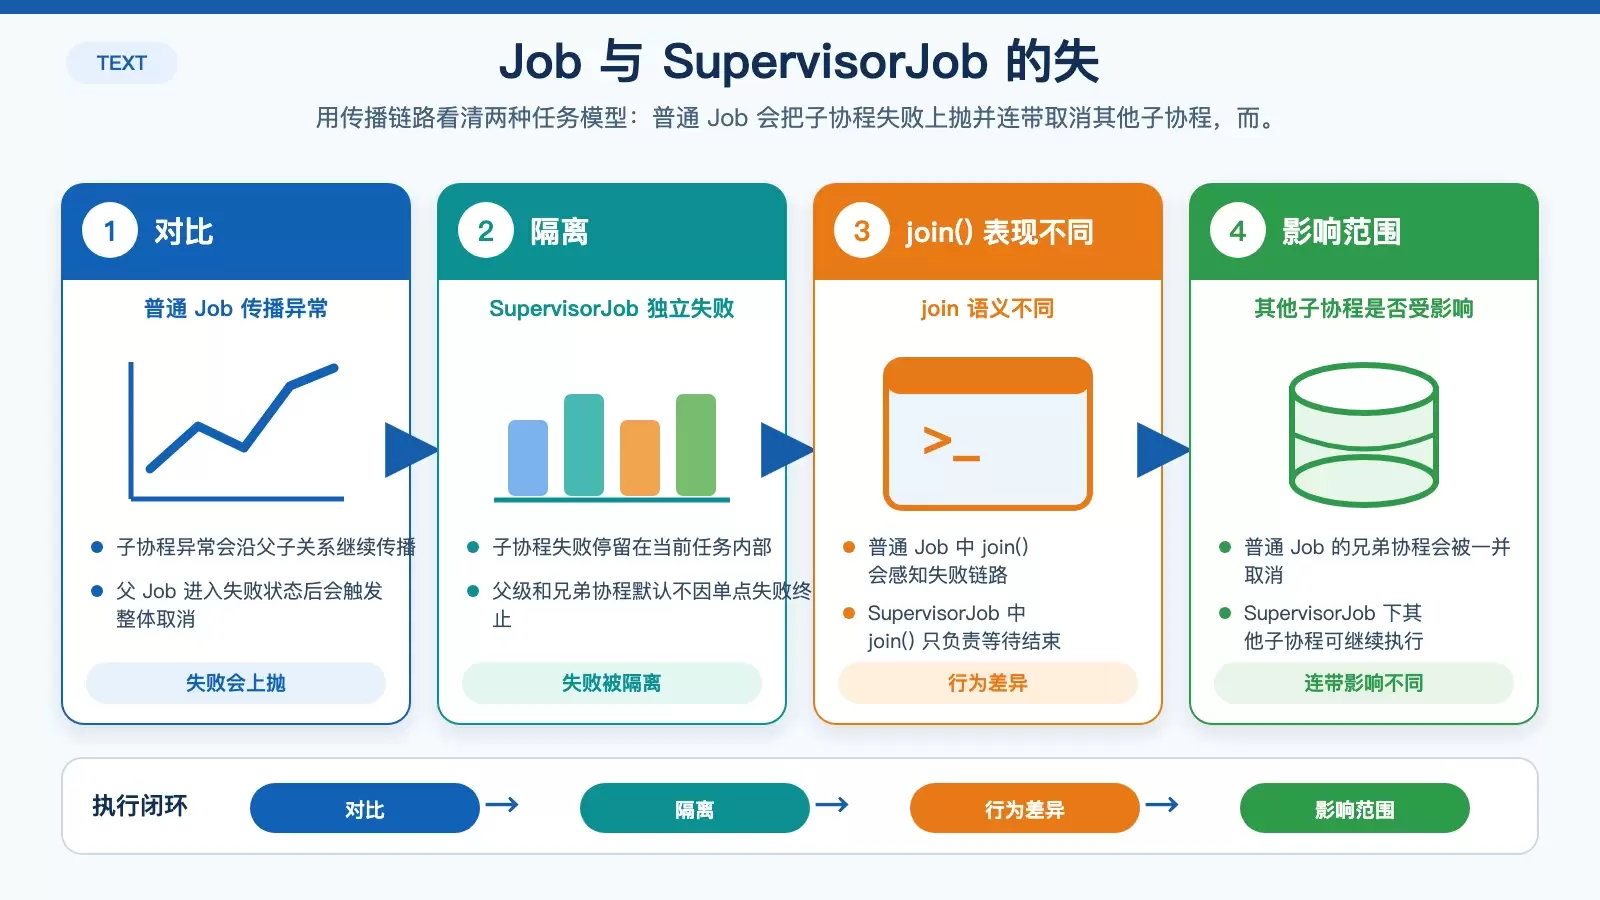
结论:在普通 Job 模型里,子协程异常通常不会悄悄消失,因为父子关系本身就会推动异常继续向上传播。
SupervisorJob:join() 只等待结束,不负责把异常抛给你
val supervisor = SupervisorJob()
val child = launch(supervisor) {
    throw RuntimeException("Child failed")
}
try {
    child.join()  //  这里不会抛出异常!
    println("这行会执行")
} catch (e: Exception) {
    // 这不会执行!
    println("不会捕获到异常")
}
这也是最容易让人误会的地方。子协程确实失败了,但在 SupervisorJob 下,这个失败被限制在子协程自身,不会自动升级成父级失败,也不会通过 join() 重新抛出。
结论:join() 在这里的语义更接近“等它执行完”,而不是“顺便把失败结果也交给我处理”。
异常被隔离后,会带来什么实际影响
一旦切换到 SupervisorJob,你得到的是更高的隔离性,但代价也很明确。
- 异常可能被静默忽略:如果没有额外处理,子协程已经失败,但调用方只做了
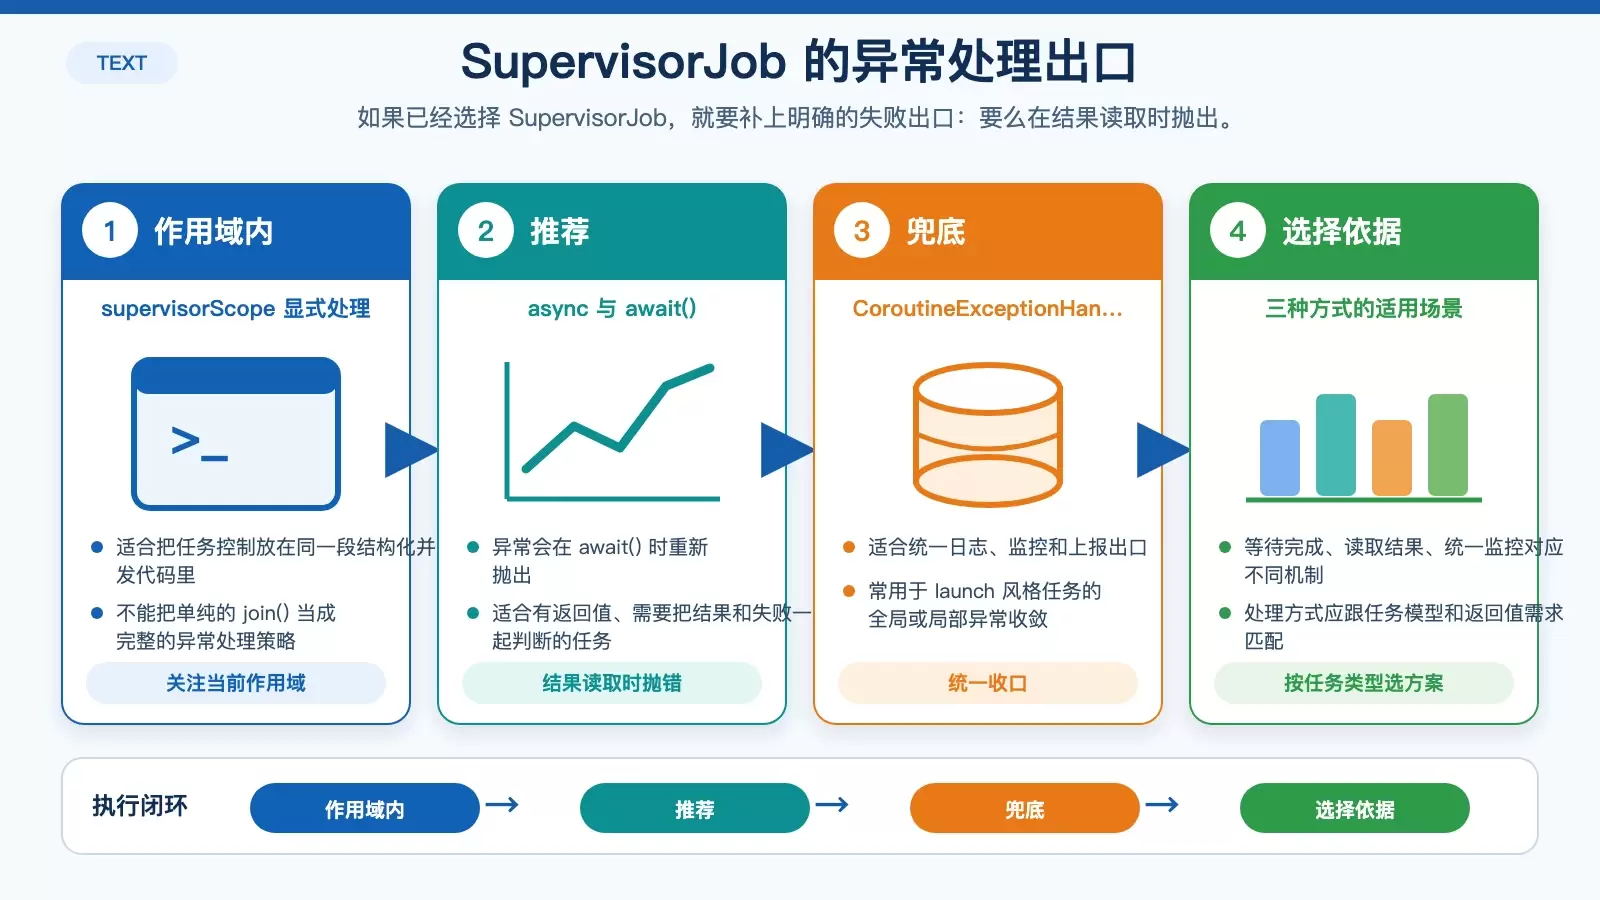
join(),表面上看流程仍然继续。 - 需要显式监控失败:你必须主动决定,是在子协程内部捕获、在结果读取阶段抛出,还是统一交给异常处理器。
这正是很多线上问题的来源:程序没有崩,但任务其实没做成;日志也不一定完整,结果就是定位困难。
在 SupervisorJob 下,正确处理子协程失败的 3 种方式
方法 1:在作用域内显式处理 join 相关逻辑
supervisorScope {
    val child = launch {
        throw RuntimeException("Failed")
    }
    try {
        child.join()
    } catch (e: Exception) {
        println("显式处理: $e")
    }
}
这段代码保留了原始写法,但需要注意一个理解点:在 SupervisorJob 语义下,是否能通过这里的 catch 接住异常,取决于你拿到异常的方式是否真的沿当前调用链暴露出来。也就是说,单独写一个 join(),并不能替代明确的失败处理策略。
方法 2:使用 async + await() 获取结果并接住异常
supervisorScope {
    val deferred = async {
        throw RuntimeException("Failed")
    }
    try {
        deferred.await()  // 这里会抛出异常
    } catch (e: Exception) {
        println("捕获: $e")
    }
}
这是最适合“任务有返回值”场景的方案。async 会把异常保存在结果对象里,等到调用 await() 时再抛给调用方,因此异常路径更清晰,也更适合和业务结果一起处理。
方法 3:使用 CoroutineExceptionHandler 做统一兜底
val handler = CoroutineExceptionHandler { _, exception ->
    println("捕获到异常: $exception")
}

val supervisor = SupervisorJob()
val scope = CoroutineScope(Dispatchers.Default + supervisor)

val child = scope.launch(handler) {
    throw RuntimeException("Failed")
}

child.join()  // 异常会被 handler 处理
如果你的重点是日志、监控、上报,或者需要给某一类 launch 任务统一加异常出口,CoroutineExceptionHandler 会更稳妥。它不能替代所有业务级处理,但很适合作为最后一道兜底。
为什么 SupervisorJob 要这样设计
| 特性 | Job | SupervisorJob |
|---|---|---|
| 异常传播 | 自动向上传播 | 隔离,不传播 |
| 其他子协程 | 全部取消 | 不受影响 |
join() 行为 | 抛出异常 | 不抛出异常 |
| 设计目标 | 原子性任务组 | 独立任务集合 |
SupervisorJob 的设计目标很明确:
- 它适合管理一组相互独立的子任务。
- 一个任务失败,不应该把其他还在正常执行的任务一起取消。
- 异常处理权交给开发者,而不是默认替你做“整体失败”的决定。
- 常见场景包括 UI 中多个独立网络请求、后台多个并行任务、互不依赖的数据刷新流程等。
所以它不是“更安全的 Job”,而是“把失败传播改成失败隔离”的另一种任务模型。
更稳妥的最佳实践写法
// 场景:需要并行执行多个独立任务,分别处理各自异常
val supervisorJob = SupervisorJob()
val scope = CoroutineScope(Dispatchers.IO + supervisorJob)

// 任务1 - 独立处理异常
val task1 = scope.launch {
    try {
        // 可能失败的操作
    } catch (e: Exception) {
        // 处理这个特定任务的异常
    }
}

// 任务2 - 使用 async 获取结果
val task2 = scope.async {
    // 可能失败的操作
}

// 分别处理
runBlocking {
    task1.join()

    try {
        val result = task2.await()
    } catch (e: Exception) {
        // 处理 task2 的异常
    }
}
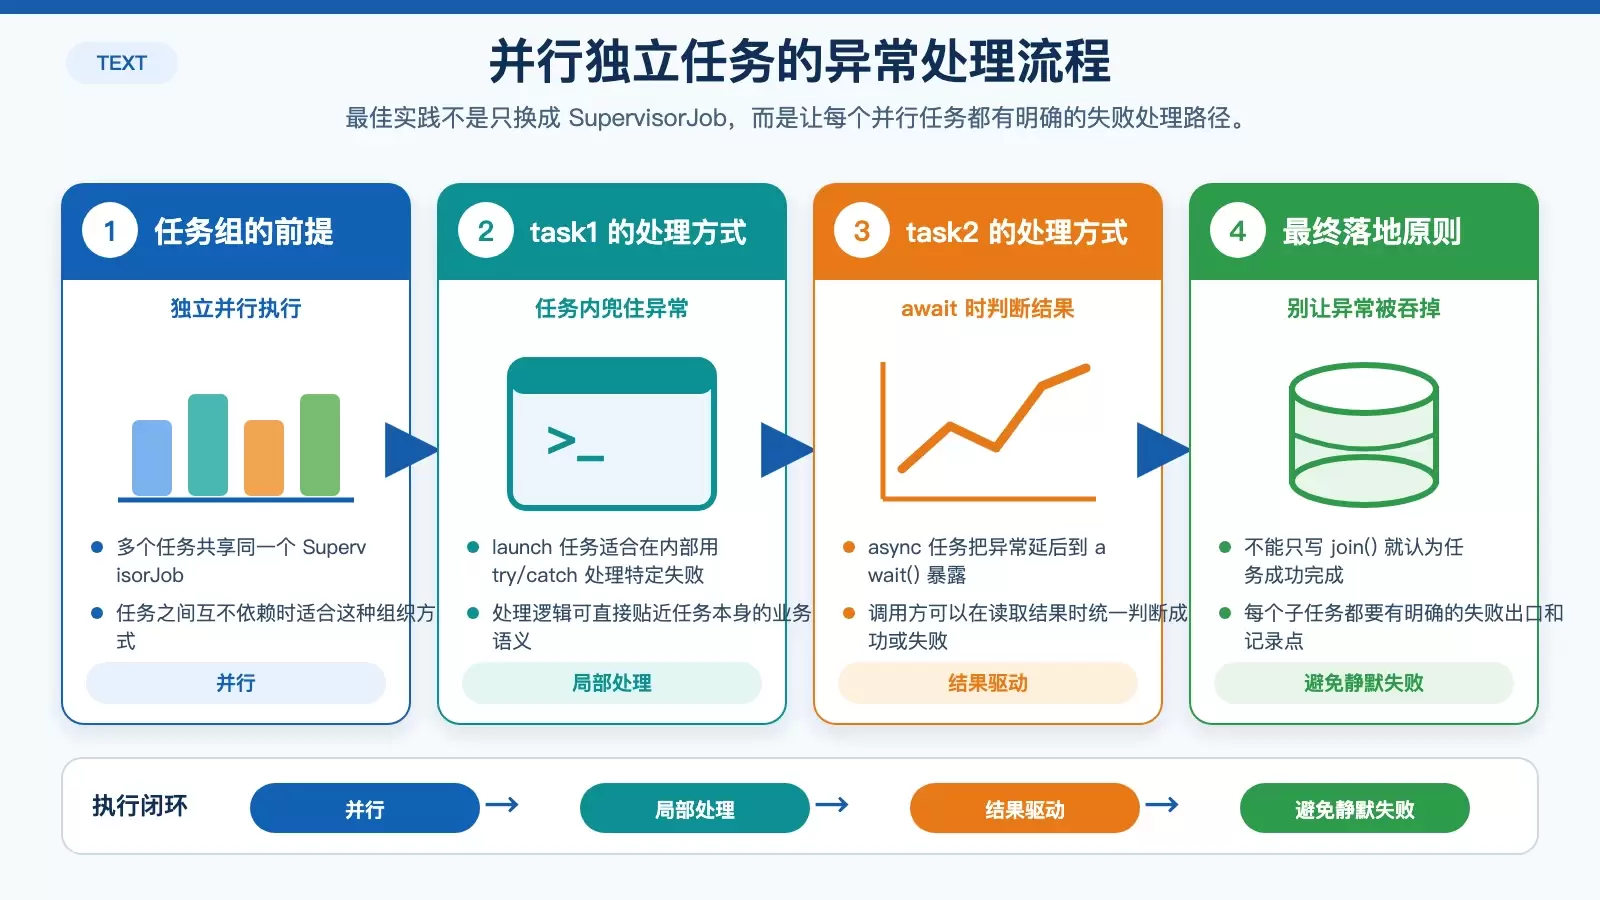
这段写法对应的是最常见、也最符合 SupervisorJob 初衷的场景:多个任务并行执行,但每个任务都要有自己的失败出口。
可以直接记住一句话:
- 只想等待任务结束,用
join()。 - 要拿结果并感知失败,用
await()。 - 要做统一兜底和日志收敛,用
CoroutineExceptionHandler。
最终结论:SupervisorJob 下 child.join() 不会自动把子协程异常抛出来,根本原因是它采用了异常隔离而不是失败传播。它很适合独立任务集合,但前提是你已经为每个子任务设计好显式的异常处理路径。









