很多 Kotlin 协程问题,表面上看都是“怎么取消任务”,实际卡点往往是:你要停掉的是某一个正在执行的任务,还是整个协程作用域。Job.cancel() 和 Scope.cancel() 名字接近,但影响范围、后续是否还能继续 launch、以及在结构化并发里的职责都不一样。看完这篇你可以直接判断:当前场景应该取消单个 Job,还是应该回收整个 Scope。
先看结论:两者取消的不是同一层级
Job.cancel() 面向的是某一个具体任务;Scope.cancel() 面向的是整个协程作用域。两者都能触发取消,但处理对象不同,带来的结果也不同。
Job.cancel():只取消单个 Job
val job = launch {
    // 协程体
}
job.cancel()  // 只取消这个特定的 job
它的行为可以概括为三点:
- 只取消单个 Job及其子协程
- 不会影响同一作用域中的其他 Job
- 当前 Job 取消后,所属作用域本身仍可继续使用
val job1 = scope.launch { /* 任务1 */ }
val job2 = scope.launch { /* 任务2 */ }

job1.cancel()  // 只取消 job1,job2 继续运行
这类取消更适合“精确停止某一个任务”,例如用户手动终止某次请求、取消某个后台计算,或者替换掉某次旧搜索。
Scope.cancel():取消整个作用域
scope.cancel() // 取消整个作用域及其所有协程
它的行为则更“整体化”:
- 取消整个作用域中的所有协程
- 该作用域被取消后,不能再启动新的协程
- 与这个 Scope 关联的所有子 Job 都会一起被取消
val scope = CoroutineScope(Dispatchers.IO)

scope.launch { /* 任务1 */ }
scope.launch { /* 任务2 */ }

scope.cancel()  // 取消所有任务,且 scope 不能再 launch 新协程
这更像是在回收一整组任务的生命周期,常见于页面销毁、组件退出、整个工作流结束这类场景。
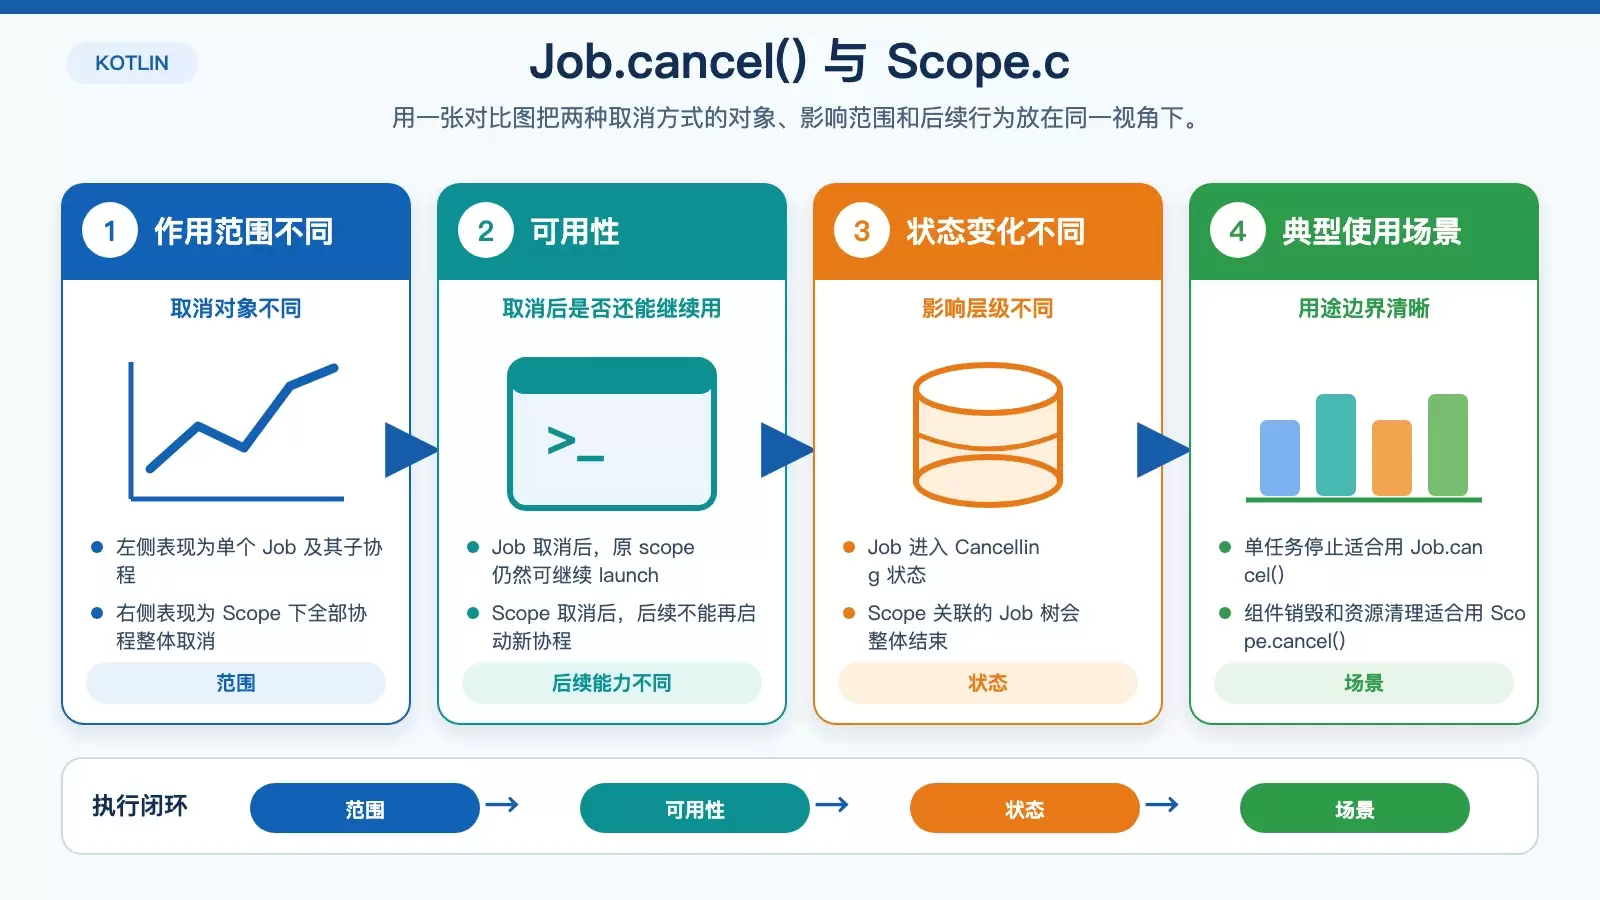
关键区别可以从 4 个维度判断
| 特性 | Job.cancel() | Scope.cancel() |
|---|---|---|
| 作用范围 | 单个 Job + 其子协程 | 整个作用域 + 所有协程 |
| 后续使用 | 作用域仍可继续启动新协程 | 作用域已失效,不能启动新协程 |
| 状态影响 | 该 Job 进入 Cancelling 状态 | Scope 和关联 Job 整体取消 |
| 典型场景 | 取消特定任务 | 清理整个界面或组件资源 |
如果你只需要停止一个任务,同时保留当前作用域继续接活,用 Job.cancel();如果你希望这批协程全部退出,并且后面也不再继续在这个作用域上启动新任务,就该用 Scope.cancel()。
放到代码里看,差别会更直观
示例一:取消 jobA,不影响 jobB
val scope = CoroutineScope(SupervisorJob())

val jobA = scope.launch {
    delay(1000)
    println("Job A 完成")
}

val jobB = scope.launch {
    delay(2000)
    println("Job B 完成")
}

// 只取消 jobA,jobB 继续运行
jobA.cancel()

// scope 仍然可用,可以启动新协程
scope.launch { println("新协程") }
这个例子里,jobA.cancel() 只会影响 jobA。jobB 不受影响,scope 也依然可用,所以后面还能继续 launch 新协程。
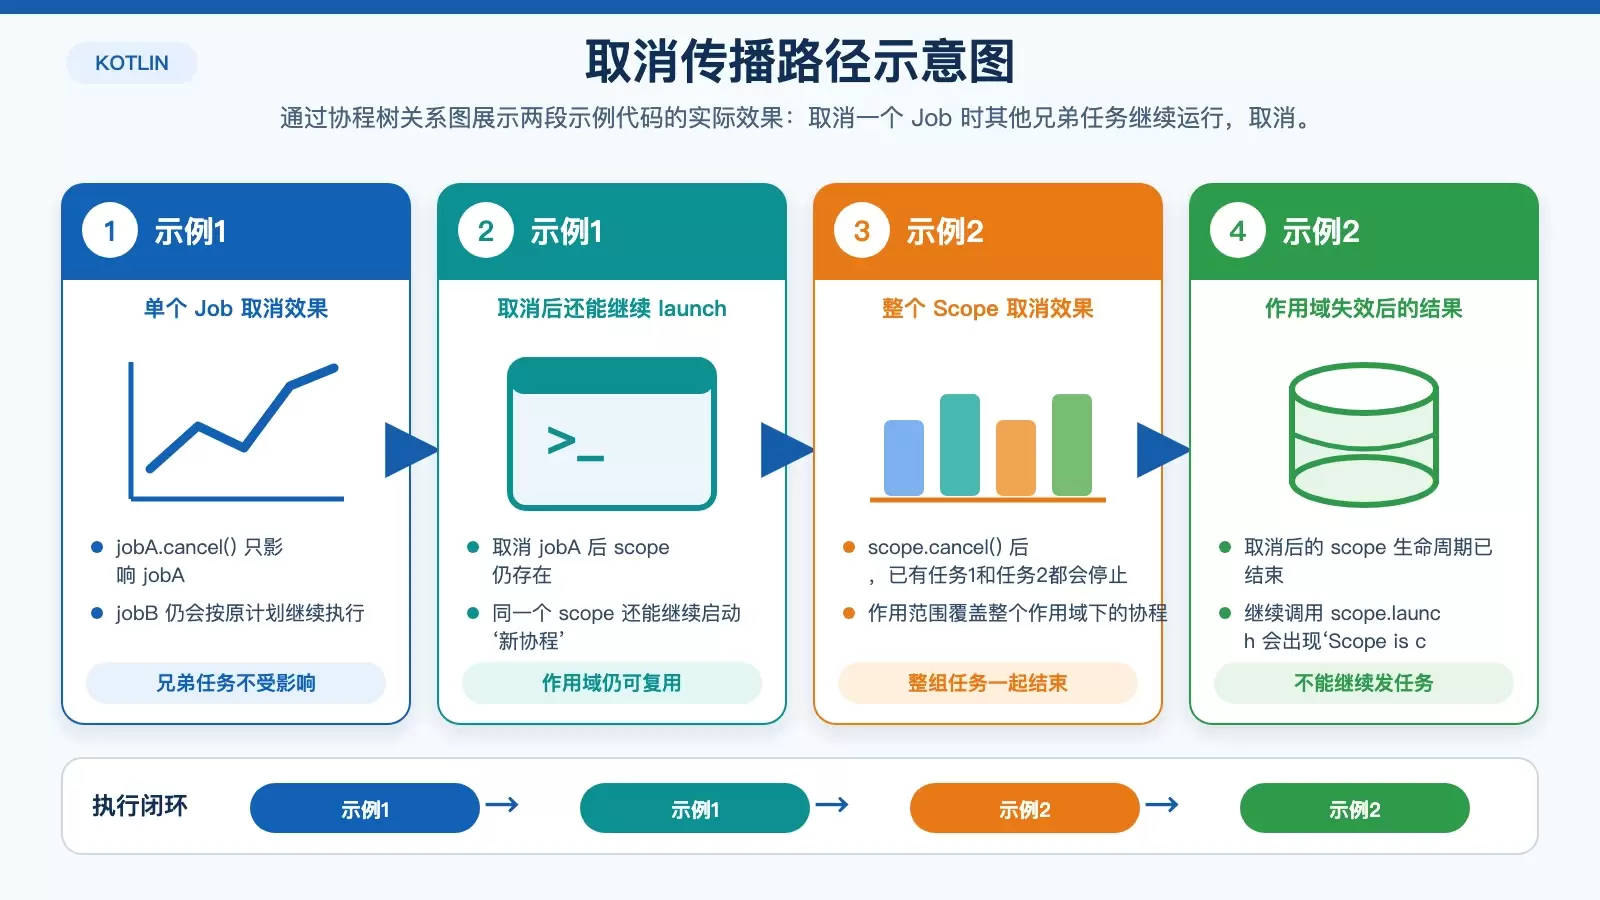
示例二:取消 scope 后,整个作用域失效
val scope = CoroutineScope(SupervisorJob())

scope.launch { /* 任务1 */ }
scope.launch { /* 任务2 */ }

// 取消整个作用域
scope.cancel()

// 这里会抛出异常:Scope is cancelled
scope.launch { println("这不会执行") }
这里的重点不只是“已有任务被停掉”,而是这个 scope 的生命周期已经结束。继续往这个作用域里发任务,预期上就不成立了。
为什么 Scope.cancel() 看起来像“更大范围的取消”
内部实现:本质上还是取消关联 Job
CoroutineScope 的 cancel() 并不是完全独立的一套机制,它实际会去拿出上下文里的 Job,再调用这个 Job 的取消逻辑:
// CoroutineScope 的 cancel() 实际上调用了关联 Job 的 cancel()
public fun CoroutineScope.cancel(cause: CancellationException = null) {
    val job = coroutineContext[Job]
        : error("Scope cannot be cancelled because it does not have a job")
    job.cancel(cause)
}
所以从实现上看,Scope.cancel() 并不是“另一种取消 API”,而是针对 Scope 挂载的根 Job 发起取消。区别在于,这个根 Job 往下挂着整个作用域中的协程树,因此影响面会更大。
结构化并发里,通常按作用域管理生命周期
在结构化并发中,更常见的做法是通过作用域统一管理任务生命周期,而不是零散地跟踪每一个 Job。典型例子包括:
- ViewModel 销毁时:
viewModelScope.cancel() - Activity 销毁时:
lifecycleScope.cancel()
这背后的思路很直接:当宿主对象结束生命周期时,相关协程也应该一起结束,避免继续占用资源,或者把结果回调到已经失效的界面上。
两种取消都可以携带原因
// Job.cancel() 可以指定原因
job.cancel("用户取消操作")

// Scope.cancel() 同样可以
scope.cancel(TimeoutCancellationException("超时"))
这一点说明两者在“取消原因”的表达能力上没有本质差别,真正要分辨的还是取消范围和生命周期语义。
实际开发怎么选:按任务粒度和生命周期来定
适合用 Job.cancel() 的场景
- 只想取消某一个后台任务
- 需要实现可取消的单次操作
- 不希望影响其他并行任务
例如搜索联想、分页请求、某个独立下载任务,都更适合保留外层作用域,只替换或终止其中一个 Job。
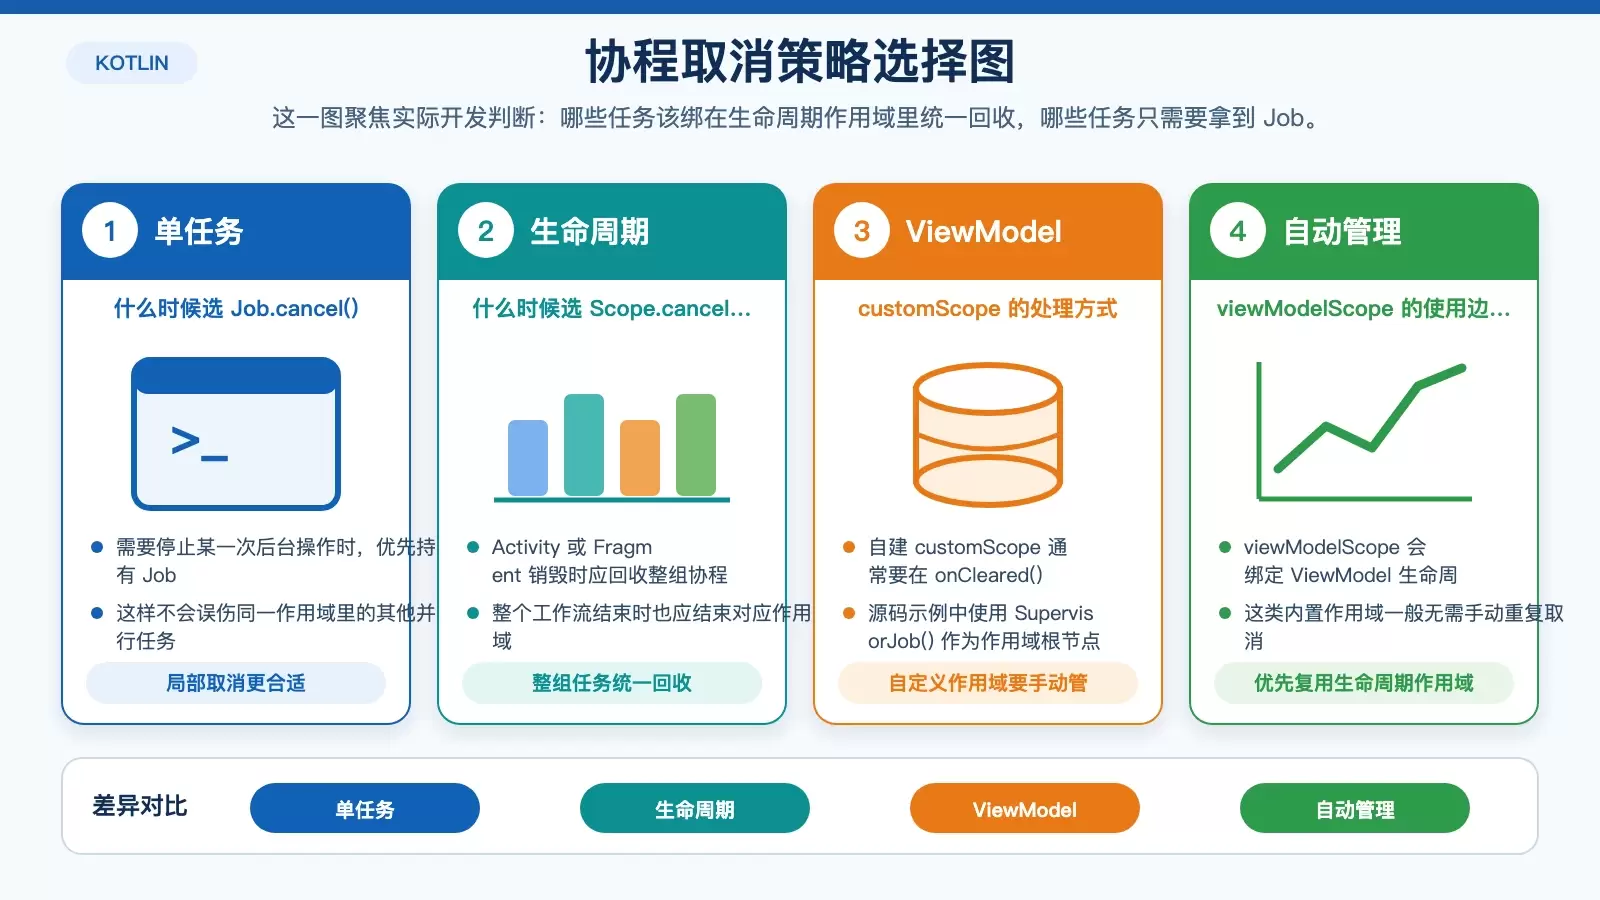
适合用 Scope.cancel() 的场景
- 组件(Activity/Fragment)销毁时清理资源
- 需要取消整个工作流的所有任务
- 要确保没有协程泄露
只要你的目标是“这批任务和它们的宿主一起结束”,就应该优先按 Scope 处理。
ViewModel 中的一个常见写法
class MyViewModel : ViewModel() {
    private val customScope = CoroutineScope(SupervisorJob())

    fun startWork() {
        customScope.launch { /* 工作 */ }
    }

    override fun onCleared() {
        customScope.cancel()  // 清理自定义作用域
        super.onCleared()
    }

    // viewModelScope 会自动管理,无需手动取消
    fun useViewModelScope() {
        viewModelScope.launch { /* 自动绑定生命周期 */ }
    }
}
这里有一个很实用的判断标准:
- 如果是自己创建的
customScope,通常需要在合适时机手动cancel() - 如果使用的是
viewModelScope这类已绑定生命周期的作用域,一般不需要额外手动管理
最后记住这条判断线
Job.cancel() 是“定点取消”,适合停止某一个具体任务;Scope.cancel() 是“整组回收”,适合结束整个作用域及其生命周期内的所有协程。
在结构化并发里,优先通过 Scope 管理生命周期,只有当你明确知道自己要保留作用域、只移除其中某一个任务时,再单独调用 Job.cancel()。这样代码语义更清晰,也更不容易留下协程泄露或错误的生命周期管理问题。









