Node.js 应用跑在 Debian 上时,最棘手的情况往往不是一次性内存峰值,而是进程内存在业务看似正常的情况下缓慢爬升,最后被 OOM 或被动重启。要把这类问题处理干净,关键不在于“先扩内存”,而是先确认是否真的发生泄漏,再用堆快照和代码检查把引用链找出来,最后配合运行时监控降低复发概率。本文就按这个顺序展开,帮助你判断该看哪些指标、该用哪些工具,以及不同泄漏类型分别怎么修。
先确认:Node.js 是否真的发生了内存泄漏
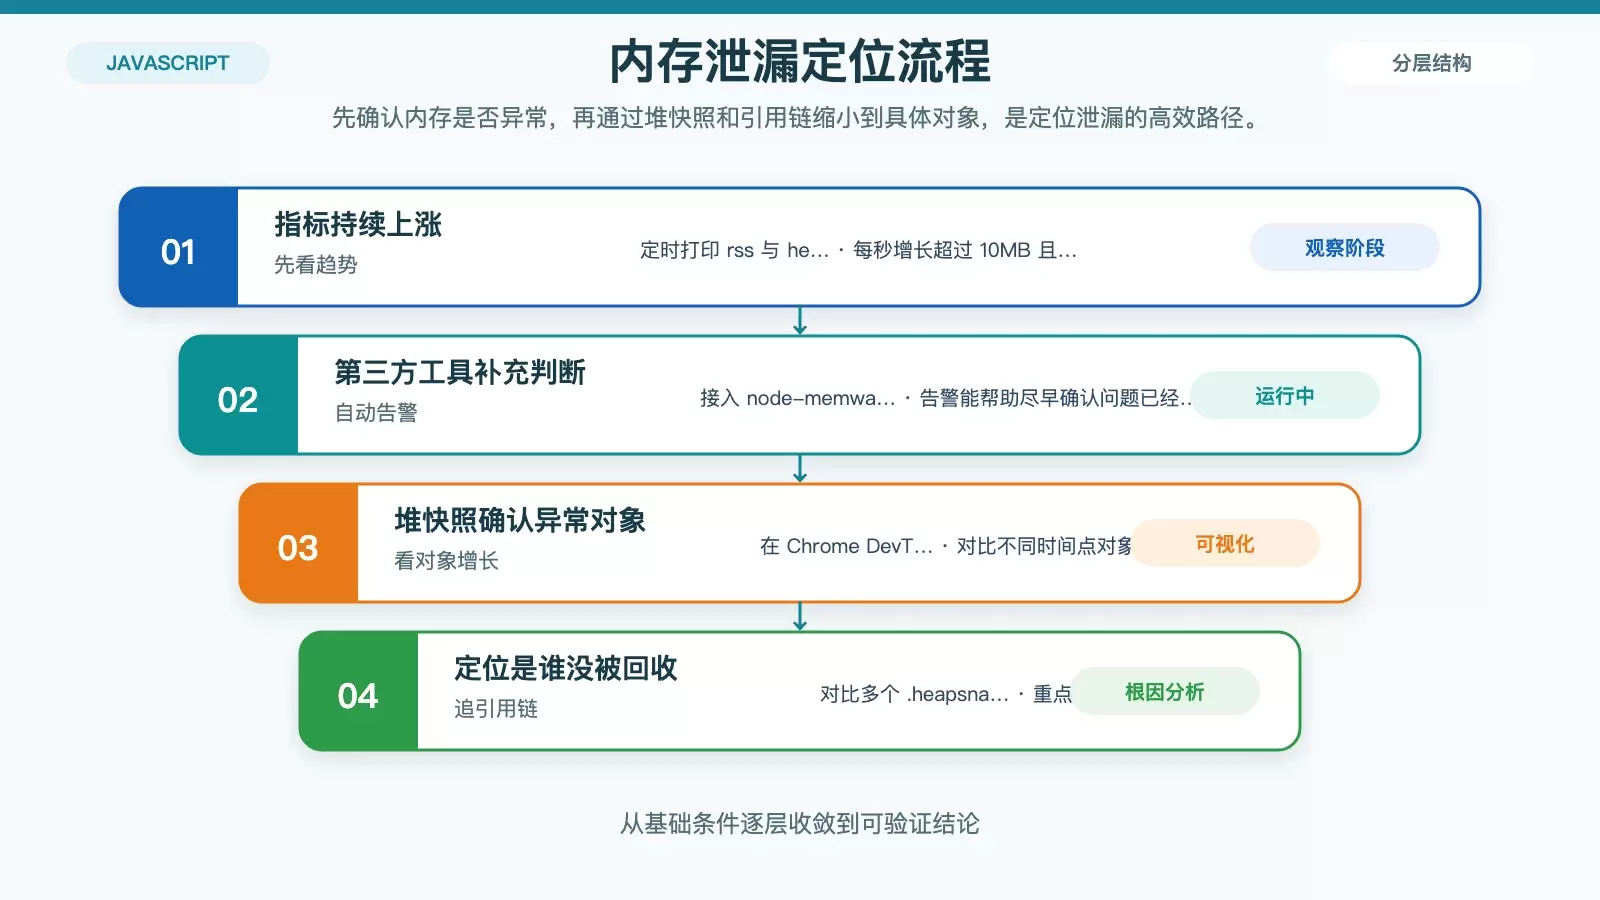
排查的第一步不是直接改代码,而是先判断内存上涨到底是正常波动,还是对象没有被正确回收。对于 Debian 上运行的 Node.js 服务,通常可以从三种方式入手。
用 process.memoryUsage() 观察内存走势
最直接的做法,是定时输出 rss(常驻内存集)和 heapUsed(堆内存使用量)等指标,观察它们是否持续增长且没有明显回落。原文给出的经验阈值是:如果每秒增长超过 10MB 且没有下降趋势,就值得重点怀疑。
setInterval(() => {
  const { rss, heapUsed } = process.memoryUsage();
  console.log(`RSS: ${(rss / 1024 / 1024).toFixed(2)}MB, HeapUsed: ${(heapUsed / 1024 / 1024).toFixed(2)}MB`);
}, 1000);
这类监控适合先做一轮粗筛:如果请求量稳定,但 heapUsed 还是持续抬高,就说明问题多半不只是瞬时缓存或短期对象堆积。
用 node-memwatch 做自动告警
如果你希望让应用在运行时主动提示风险,可以接入 node-memwatch 这类第三方工具。它的作用是检测疑似泄漏行为,并在命中时抛出告警信息。
const memwatch = require('node-memwatch');
memwatch.on('leak', (info) => console.error('Memory leak detected:', info));
这种方式不能代替后续分析,但能帮助你更早知道“问题已经发生”,尤其适合长时间运行的服务进程。
用 Chrome DevTools 的 Memory 面板看对象增长
如果日志只能说明“内存在涨”,那下一步就要用可视化手段确认“到底是谁在涨”。做法是通过 Chrome DevTools 的 Memory 面板生成堆快照,对比不同时间点的内存分配情况,重点看哪些对象类型在持续增加。
这一步的意义在于:你开始从“现象判断”过渡到“对象级证据”,后面的根因分析基本都要依赖它。
继续定位:找到泄漏对象和引用链
确认内存异常之后,真正决定修复效率的,是你能不能把泄漏对象背后的引用关系挖出来。常见做法有两类:一类靠堆快照对比,一类靠代码模式排查。
用 heapdump 导出堆快照并对比
heapdump 是排查 Node.js 内存泄漏时很常用的工具。它可以在进程运行过程中导出 .heapsnapshot 文件,再交给 Chrome DevTools 加载分析。
安装命令如下:
npm install heapdump在代码中触发快照生成:
const heapdump = require('heapdump');
heapdump.writeSnapshot('/tmp/snapshot_' + Date.now() + '.heapsnapshot');
拿到多个时间点的快照后,可以重点对比 Retainers,也就是对象的引用链。某些对象之所以一直留在堆里,不是因为它本身“很大”,而是因为仍然被上层变量、闭包、监听器或缓存结构引用着。
重点检查几类高发代码模式
很多泄漏问题,最终都能落到几种常见写法上。排查时建议优先看下面几类:
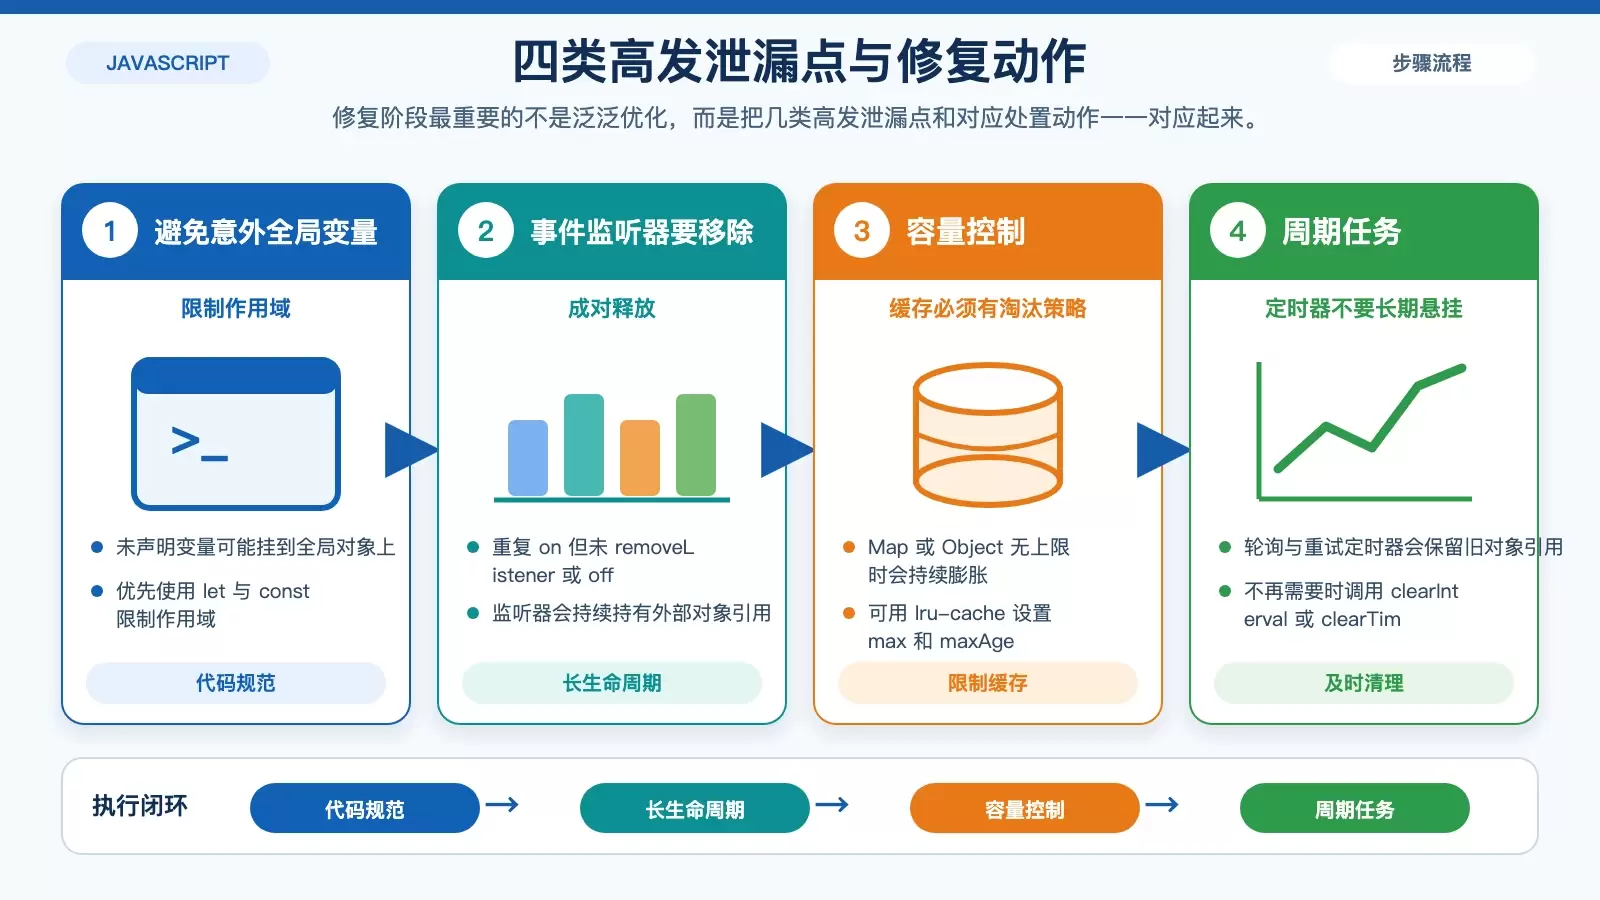
- 意外全局变量:没有使用
let/const/var声明的变量,可能会挂到全局对象上,生命周期被意外拉长。 - 闭包引用:回调函数或异步逻辑把大对象一直包在闭包里,导致这些对象即使业务上不再需要,也无法释放。
- 未移除的事件监听器:例如
EventEmitter里反复on,但没有对应的removeListener或off。 - 无限增长的缓存:直接使用
Map或Object做缓存,却没有容量上限或过期策略,最终把热点数据和冷数据一起留在内存里。
这类代码模式的共同点是:对象并不是“忘记删除”,而是仍然有引用关系存在,所以 V8 垃圾回收器没有办法回收它们。
针对类型修复:把常见泄漏点逐个清掉
定位到问题之后,修复思路就不该再停留在“加机器”或“调大限制”,而是要对应泄漏类型逐项处理。
避免把变量挂到全局作用域
最基础的一条,是始终使用 let 或 const 定义局部变量。这样做的目的不是代码风格统一,而是避免未声明变量意外成为全局对象属性,延长对象生命周期。
处理闭包中的大对象引用
如果某个大对象只在局部流程里短暂使用,就不要让它被长期存活的回调函数继续引用。原文给出的原则很直接:把大对象限制在局部作用域中,使用完成后在必要时置为 null,让垃圾回收器有机会回收。
事件监听器要成对注册和移除
事件监听器泄漏在长生命周期服务里很常见,尤其是模块初始化、连接管理、重复订阅这类场景。注册监听后,如果对象销毁或逻辑结束,就要及时移除。
const EventEmitter = require('events');
const emitter = new EventEmitter();
const callback = () => console.log('Event triggered');

emitter.on('event', callback);

// 不再需要时移除
emitter.removeListener('event', callback);
如果项目运行在较新的 Node.js 版本里,也可以根据现有代码风格使用 off,本质上解决的是同一个问题:不要让监听器持续持有外部引用。
给缓存设置上限和过期时间
缓存本身不是问题,失控的缓存才是问题。相比手写无限增长的 Map,更稳妥的做法是使用 lru-cache 这类库,明确限制最大条目数和过期时间。
const LRU = require('lru-cache');
const cache = new LRU({ max: 1000, maxAge: 1000 * 60 * 15 }); // 15分钟过期
cache.set('key', 'value');
这里的关键参数是 max 和 maxAge:前者限制容量,后者限制生命周期,两者结合才能避免缓存一路堆高。
别让定时器长期持有旧引用
定时器泄漏经常出现在轮询、重试和周期性任务中。只要回调里引用了外部对象,这个对象就可能随着定时器一起长期存活。对于已经不再需要的任务,应及时调用 clearInterval 或 clearTimeout。
上线后怎么监控和预防复发
内存泄漏往往不是一次修完就永远结束。要让问题不再反复出现,还需要把监控、压测和运行参数一起纳入日常维护流程。
用 PM2 设置内存阈值和自动重启
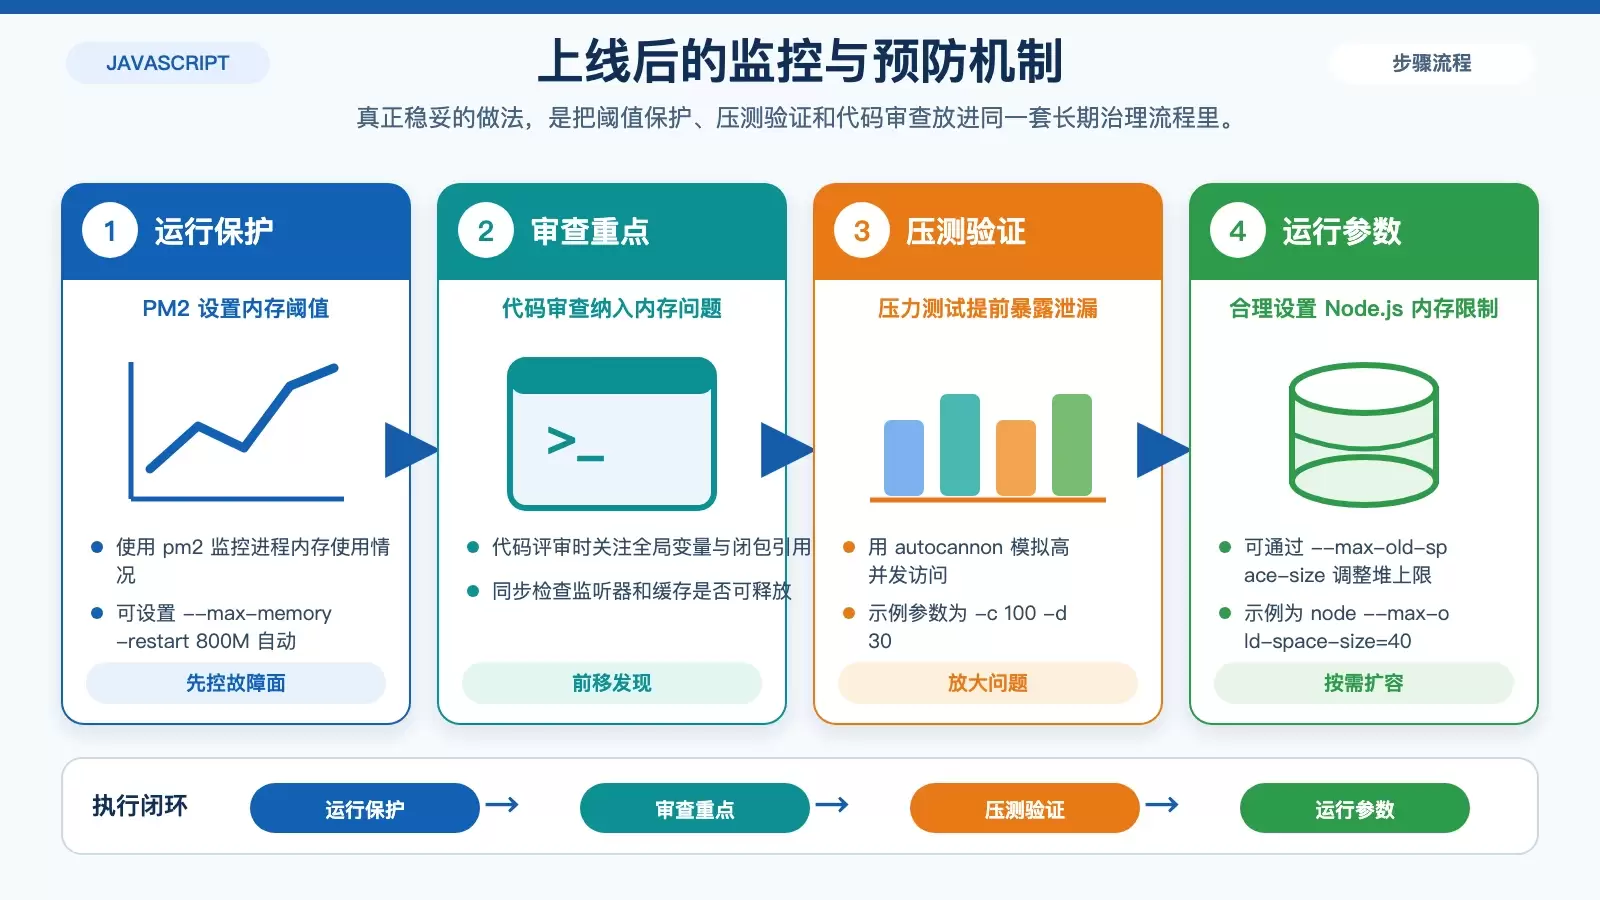
对于线上服务,pm2 可以作为最后一道保护。它能持续观察进程内存,并在超过阈值时自动重启,避免服务长期带病运行直至崩溃。
安装与启动命令如下:
npm install pm2 -g
pm2 start app.js --max-memory-restart 800M
这里的 --max-memory-restart 800M 是一个明确的保护线。它不能代替修复,但能在问题尚未彻底解决前先控制故障影响面。
把内存问题纳入代码审查
很多泄漏其实不是复杂 bug,而是开发阶段留下的习惯性问题。因此在代码审查中,可以重点检查是否存在全局变量、闭包保留大对象、事件监听器未释放、缓存无边界增长等模式。
用压力测试提早暴露问题
有些泄漏在低流量下不明显,但在高并发下会快速放大。这时可以用 autocannon 做压测,观察吞吐和内存曲线是否同步异常。
安装与使用命令如下:
npm install -g autocannon
autocannon -c 100 -d 30 http://localhost:3000/api/endpoint
如果压测期间请求量稳定,但进程内存持续上扬且压测结束后不回落,就需要重新回到前面的快照和代码分析环节。
按需调整 Node.js 内存上限
有些业务确实需要更大的堆空间,这时可以通过 --max-old-space-size 调整 Node.js 的内存限制,单位为 MB。
node --max-old-space-size=4096 app.js但这个参数的作用是“扩容缓冲区”,不是“消除泄漏”。如果根因仍在,内存只会在更大的空间里继续上涨,只是崩溃来得更晚。
实操建议:按顺序排查,别一开始就盲目加内存
在 Debian 上处理 Node.js 内存泄漏,比较稳妥的路径通常是:先用 process.memoryUsage()、node-memwatch 或 DevTools 确认现象,再用 heapdump 和堆快照锁定对象引用链,最后针对全局变量、闭包、监听器、缓存和定时器逐项修复。
如果服务已经在线上运行,则可以同时加上 pm2 的内存阈值保护、autocannon 的压测验证,以及 --max-old-space-size 的合理配置。这样做的价值在于,你不仅能把这次问题查清楚,也能为后续版本建立一套更稳定的内存治理流程。


