订单、流水号这类写入场景一上并发,很多团队第一反应是“先查一遍,再决定插入还是更新”。问题恰恰出在这里:高并发插入本身通常不是死锁源头,真正危险的是事务里先做 SELECT ... FOR UPDATE,再配上未命中索引的条件或额外的跨表操作。
这篇文章把判断顺序拆开说清楚:先看为什么 INSERT ... ON DUPLICATE KEY UPDATE 通常是首选,再看 SELECT FOR UPDATE 在插入场景下为什么容易把锁链拉复杂,最后给出必须使用它时的最低安全条件,方便你快速判断当前写法该保留还是该改。
为什么优先用 INSERT ... ON DUPLICATE KEY UPDATE
INSERT ... ON DUPLICATE KEY UPDATE 的核心优势,不是语法简洁,而是它把“存在则更新、不存在则插入”压缩成一条原子语句。整个过程不依赖应用层先查询再判断,也不需要显式加锁,更适合高并发写入。

前提是冲突字段必须建立唯一约束。例如 order_no 需要有 UNIQUE 或 PRIMARY KEY 索引。这样 InnoDB 才能借助意向插入锁与唯一约束检测,在并发冲突时直接走数据库内部的冲突处理流程,而不是在业务层拼接出一条容易形成死锁的锁等待链。
这种写法生效的前提
- 冲突字段如
order_no必须建有UNIQUE或PRIMARY KEY索引,否则ON DUPLICATE KEY UPDATE不会按预期工作。 - 不要在同一条语句里同时依赖多个唯一键处理冲突,MySQL 只会按第一个匹配到的唯一键触发
UPDATE。 - 如果业务需要知道这次到底是插入还是更新,可以用
ROW_COUNT()判断:返回1表示插入,返回2表示更新。
INSERT INTO orders (order_no, status)
VALUES ('ABC', 'NEW')
ON DUPLICATE KEY UPDATE
status = VALUES(status);
高并发插入的死锁,通常卡在先查后插
很多项目里真正的问题写法,不是直接插入,而是先做“插入前校验”:先查记录在不在,再决定后续逻辑。这种模式一旦和 SELECT ... FOR UPDATE 绑定,就很容易把简单写入变成复杂锁竞争。
尤其在记录不存在、条件没走索引、事务中还有后续插入或更新时,死锁往往不是偶发,而是并发一上来就反复出现。
SELECT FOR UPDATE 容易死锁的三个原因
- 当查询查不到记录时,例如
SELECT * FROM orders WHERE order_no = 'ABC' FOR UPDATE,InnoDB 可能锁住对应的间隙,也就是 gap lock。多个并发请求如果都卡在同一个间隙上,后续插入就会互相等待。 - 如果
WHERE条件字段没有索引,例如按status查询,MySQL 可能把锁范围放大,严重时等价于高并发下排队抢一把大锁。 - 事务里紧接着再执行
INSERT,插入意向锁与前面的间隙锁发生冲突,就可能形成 A 等 B、B 等 A 的闭环,最终触发死锁。
SELECT *
FROM orders
WHERE order_no = 'ABC'
FOR UPDATE;
必须用 SELECT FOR UPDATE 时,至少满足这三点
SELECT FOR UPDATE 不是完全不能用,但在插入场景里,只有满足明确约束时才算安全可用。少一个条件,风险都会明显上升。
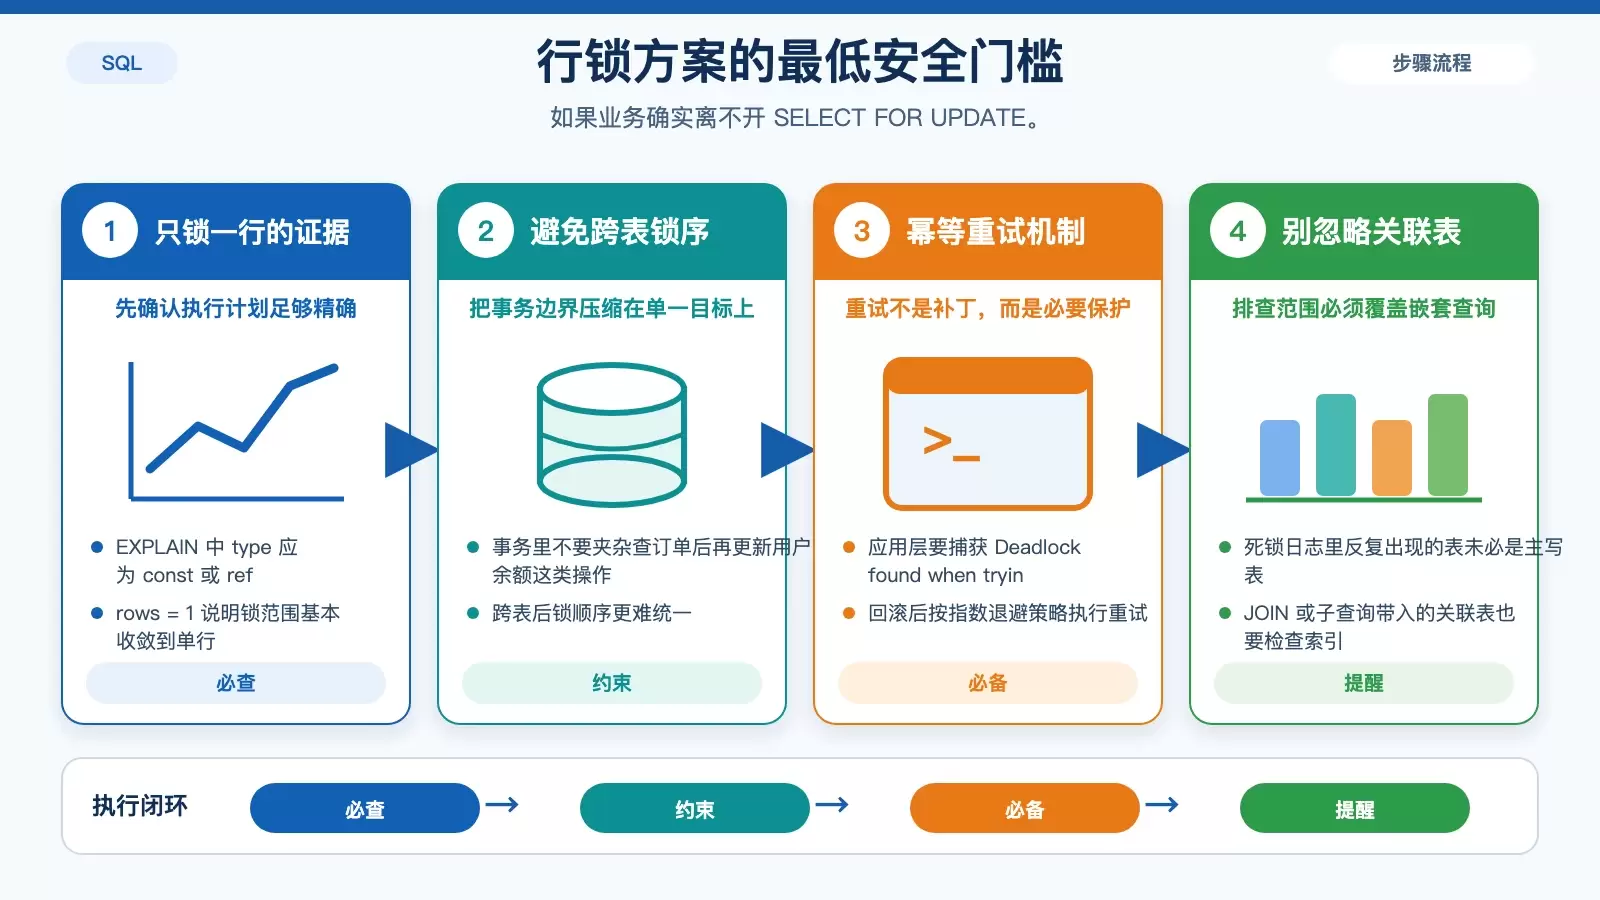
最低安全条件
- 先用
EXPLAIN验证执行计划,确认type是const或ref,并且rows = 1。这意味着查询命中唯一索引,锁范围基本可控在单行。 - 事务内不要夹杂其他表操作,例如查完订单又去更新用户余额。跨表之后,锁顺序更难统一,死锁概率会明显上升。
- 应用层必须实现幂等重试。遇到
Deadlock found when trying to get lock后,应回滚并重试,常见做法是指数退避,例如sleep(0.05 * 2^i)。
EXPLAIN SELECT *
FROM orders
WHERE order_no = 'ABC'
FOR UPDATE;
排查死锁时,别只盯着正在写入的主表
一个很容易被忽略的现象是:死锁日志里反复出现的表,未必就是你当前正在插入的那张表。很多时候,真正把锁链拉长的是被 JOIN、子查询或事务内额外语句带进来的关联表。
所以排查时不能只优化主 SQL。更有效的做法,是把所有嵌套查询和关联表都过一遍,确认它们是否都走了索引、是否扩大了锁范围、是否改变了原本简单的锁顺序。实践里,这一步往往比单纯调整插入语句更关键。
实战结论:按这个顺序做判断
如果业务本质上只是“有则更新、无则插入”,优先改成 INSERT ... ON DUPLICATE KEY UPDATE,并确保冲突字段上有 UNIQUE 或 PRIMARY KEY 索引。这通常是高并发写入里最省事、也最稳的方案。
如果确实必须保留 SELECT FOR UPDATE,就先检查三件事:是否命中唯一索引、事务里是否混入其他表操作、应用层是否具备幂等重试能力。只要这三项里有一项做不到,就应该优先回头重构“先查后插”的流程,而不是继续在死锁参数上做小修小补。









