
在 C 程序里,很多系统调用和标准库函数失败时,不会直接告诉你完整原因,而是把线索留在 errno 里。这也是为什么不少初学者明明判断到了失败,却还是很难继续定位问题。
这篇文章就围绕 errno 到底记录了什么、什么时候该看它,再把常见错误码按场景归类,最后结合 strerror、perror 和自定义处理代码,整理出一套更实用的排错方法。
什么是 errno,它解决了什么问题
errno。它的类型通常是 int,用于保存系统调用或库函数最近一次失败时对应的错误代码。
可以把 errno 理解成“失败原因编号”。当某个操作执行失败后,程序往往先通过返回值告诉你“这次没成功”,再通过 errno 告诉你“为什么失败”。例如文件不存在、权限不足、参数无效、内存不足,都可能对应不同的错误码。
先判断失败,再读取 errno
使用 errno 时有一个关键前提:先看函数是否真的失败。只有当返回值已经表明调用失败时,再去检查 errno 才有意义。

为了使用它,需要包含头文件
// www.ja vascriptcn.com code example #include#include #include int main() { FILE *file = fopen("nonexistent_file.txt", "r"); if (file == NULL) { perror("Error opening file"); printf("Error code: %dn", errno); printf("Error message: %sn", strerror(errno)); } else { // 正常处理 fclose(file); } return 0; }
这段代码里,fopen 试图打开不存在的 nonexistent_file.txt。如果打开失败,返回值是 NULL,此时 errno 很可能会被设置为 ENOENT,表示文件或目录不存在。
错误码的取值由系统决定
errno 的具体错误码并不是完全由 C 语言本身统一规定,而是会受到操作系统实现影响。以 Linux 为例,常见值包括:
EACCES:权限不够。EBADF:文件描述符无效。EINVAL:无效参数。ENOENT:文件或目录不存在。ENOMEM:内存不足。
这也意味着,同样是“调用失败”,只有结合具体错误码,才能知道后续该重试、提示用户、修正参数,还是直接退出。
开发中常见的 errno 错误码
单独记忆错误码意义不大,按场景来理解更实用。下面把原文提到的常见错误码分成几类,便于在排查问题时快速定位。
文件操作相关
EACCES:没有权限访问文件或目录。EBADF:文件描述符无效。ENOENT:文件或目录不存在。ENOTDIR:路径中的某个部分不是目录。EISDIR:试图对目录进行文件操作。EROFS:只读文件系统。
这一组最常见,通常出现在 fopen、open、read、write 一类文件操作中。只看“打开失败”并不足够,像“文件不存在”和“权限不足”虽然结果都是失败,但修复方式完全不同。
网络相关
ECONNREFUSED:连接被拒绝。ETIMEDOUT:连接超时。EHOSTUNREACH:主机不可达。ENETDOWN:网络未就绪。
网络错误更适合结合上下文处理。例如连接被拒绝,可能说明服务端没有监听;超时则更可能是链路不稳定、目标端响应过慢,或者超时参数设置太短。
线程相关
EDEADLK:检测到死锁。EINVAL:无效参数。ENOMEM:内存不足。
这类错误一般出现在多线程同步、锁操作或线程创建相关接口中。它们往往不是偶发故障,而是代码逻辑本身存在设计问题,需要回到并发控制流程里排查。
系统资源相关
ENOMEM:内存不足。EMFILE:进程打开的文件描述符太多。ENFILE:系统打开的文件描述符太多。
这一类错误通常说明程序已经碰到资源上限。相比单纯打印错误信息,更重要的是确认资源是否及时释放,以及当前负载是否超出系统设计范围。
什么时候用 strerror
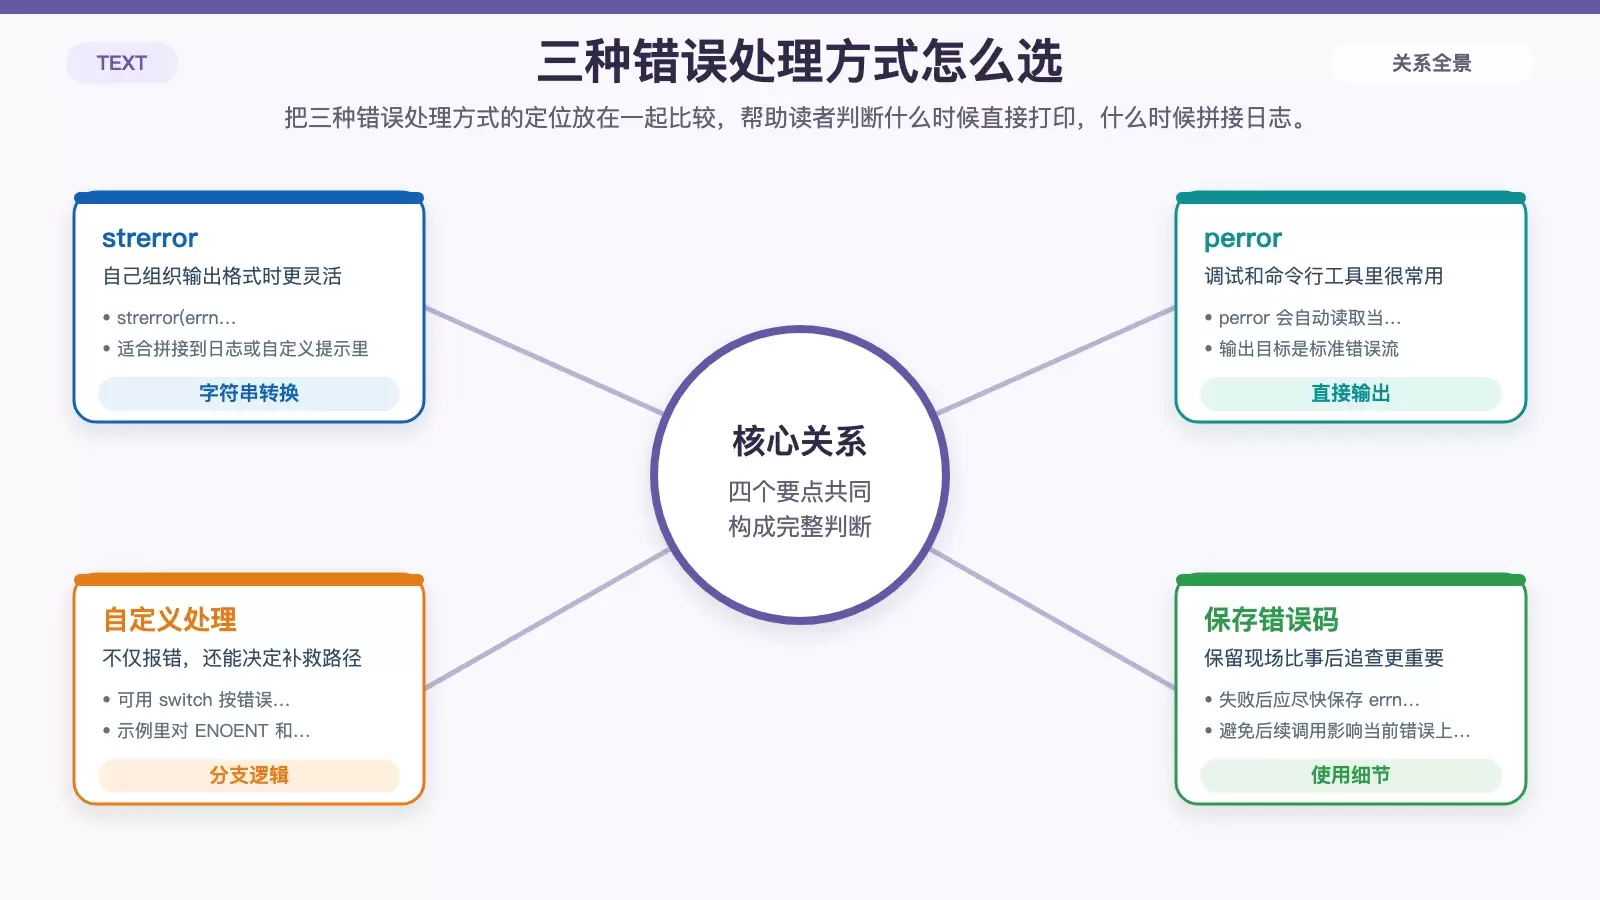
strerror 的作用,是把整数形式的错误码转换成可读的错误消息字符串。它适合用在你已经拿到了 errno,并希望把信息拼接进自己的日志、报错输出或提示文案时。
// www.ja vascriptcn.com code example #include#include #include int main() { FILE *file = fopen("nonexistent_file.txt", "r"); if (file == NULL) { fprintf(stderr, "Error opening file: %sn", strerror(errno)); } return 0; }
这个例子中,strerror(errno) 会返回与当前错误码对应的文本说明,再由 fprintf 输出到标准错误流。
它的优势是灵活:你可以把错误消息和文件名、参数值、调用阶段等业务上下文拼在一起,形成更完整的诊断信息。
什么时候用 perror
如果你只是想快速把最近一次错误打印出来,perror 会更省事。它会自动读取当前的 errno,转换为对应消息,并输出到标准错误流。
// www.ja vascriptcn.com code example #include#include #include int main() { FILE *file = fopen("nonexistent_file.txt", "r"); if (file == NULL) { perror("Error opening file"); } return 0; }
这里的 perror("Error opening file") 会在你给出的前缀后面,附加系统生成的错误说明。它非常适合做调试期输出,或者在命令行工具里快速报告失败原因。
简单理解,两者的区别是:
strerror适合你自己组织输出格式。perror适合快速直接打印当前错误。
如何按错误码做自定义处理
真正实用的错误处理,通常不止是“打印一下”。很多时候,你需要根据不同错误码决定下一步动作,比如提示用户检查路径、提示权限问题,或者走不同的补救流程。
// www.ja vascriptcn.com code example #include#include #include void handle_error(int error_code) { switch (error_code) { case ENOENT: printf("文件不存在。n"); break; case EACCES: printf("没有权限访问文件。n"); break; default: printf("未知错误: %dn", error_code); break; } } int main() { FILE *file = fopen("nonexistent_file.txt", "r"); if (file == NULL) { int err = errno; perror("Error opening file"); handle_error(err); } return 0; }
这个写法的重点,不只是 switch 分支本身,还在于先把当前错误码保存到局部变量 err。这样做可以避免后续其他函数调用影响你要处理的错误上下文。
一套更稳妥的使用思路
- 先检查函数返回值,确认调用确实失败。
- 失败后立即读取或保存
errno。 - 根据场景选择
perror、strerror或分支处理。 - 把错误码和调用上下文一起记录,避免只留下模糊的“执行失败”。
这样做的结果是,程序不仅能报错,还能给出足够明确的排查方向。
总结
errno”这个基本原则,并根据场景选用 strerror、perror 或自定义分支,C 程序的错误处理就会清晰很多。


