Node.js 应用在 Ubuntu 上跑着跑着内存飙升,常见结果就是进程崩溃、响应变慢,最后直接退出。处理这类问题,关键不在于只会调大堆内存,而是先区分“短时内存不够”还是“持续性泄漏”,再按应急、定位、优化和监控几个层次逐步处理。看完这篇,你可以快速判断该先改启动参数,还是该直接进入快照分析和代码修复。
先做应急:临时提高 Node.js 内存上限
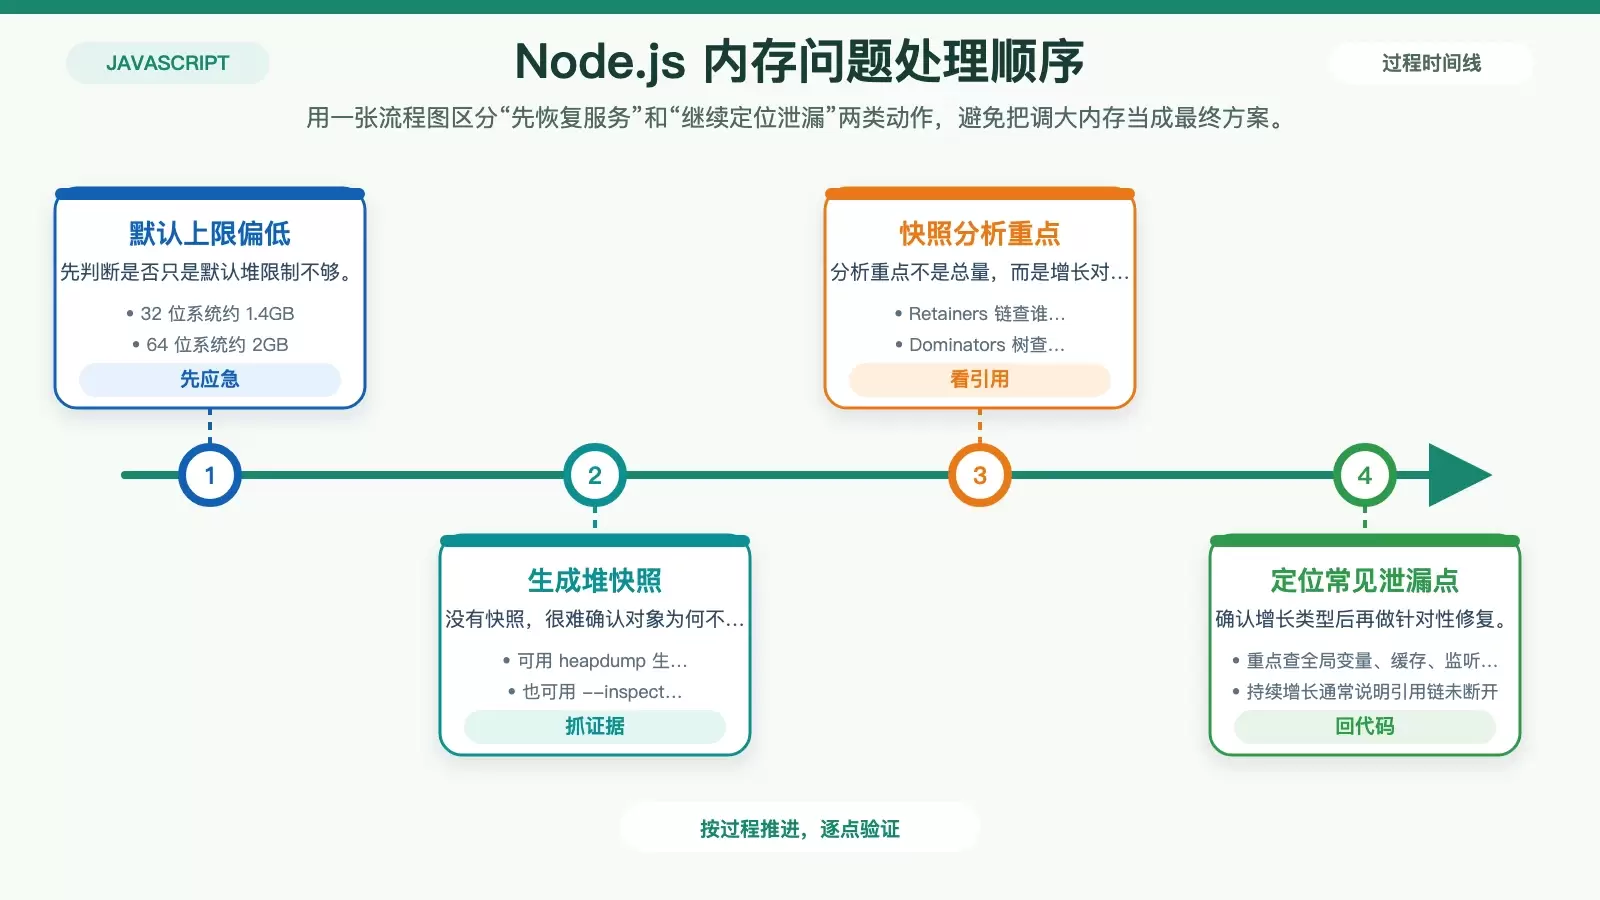
Node.js 使用的 V8 引擎默认有堆内存限制:32 位系统约 1.4GB,64 位系统约 2GB。应用体量较大,或者一次处理的数据较多时,这个默认值很容易成为瓶颈。
如果当前目标是先把服务拉起来,可以直接调整 --max-old-space-size 参数,把老生代堆内存上限调高。
直接在命令行启动
node --max-old-space-size=4096 your-app.js这里的 4096 表示将可用堆上限提升到 4GB。这种方式适合临时验证问题是否与默认内存上限有关。
在 package.json 中长期生效
如果你希望通过 npm scripts 统一启动参数,可以把配置写进 package.json:
"scripts": {"start": "NODE_OPTIONS='--max-old-space-size=4096' node app.js","dev": "cross-env NODE_OPTIONS='--max-old-space-size=4096' nodemon app.js"}其中 cross-env 用来处理不同平台的环境变量差异,安装命令如下:
npm install -g cross-env需要注意的是,调大内存只能缓解症状。如果进程占用会持续增长,问题大概率不在默认限制,而在代码中的泄漏点。
真正要解决:定位并修复内存泄漏
如果服务不是偶发触顶,而是内存一路上涨直到崩溃,那更应该优先排查内存泄漏。常见诱因包括闭包没有释放、全局变量不断堆积、缓存缺少清理机制,以及事件监听器反复注册后不移除。
先生成堆快照
排查泄漏的第一步,是把某个时刻的内存状态保存下来。可以通过 heapdump 在关键入口、定时任务或异常前后生成快照:
const heapdump = require('heapdump');
// 在关键位置(如接口入口、定时任务)生成快照
heapdump.writeSnapshot(`/tmp/heap-${Date.now()}.heapsnapshot`);
另一种方式是使用 --inspect 启动应用,再到 Chrome DevTools 的 Memory 面板里抓取快照。相比日志观察,这种方式更直观,适合对比不同时间点的对象增长情况。
分析快照时重点看什么
拿到多个时间点的堆快照后,不要只看总内存大小,更要关注对象为什么没有被回收。通常重点看两类视图:
- Retainers 链:查看对象仍然被谁引用,常见来源包括全局变量和闭包中的外层变量。
- Dominators 树:查看哪些对象占用了最多内存,典型目标包括大数组、缓存对象和长期驻留的数据结构。
如果某类对象在多份快照之间持续增加,而且引用链稳定不释放,基本就可以确认泄漏范围。
几类常见泄漏场景
- 全局变量滥用:不要随手往
global上挂对象,例如global.cache = {}。这类引用生命周期太长,容易把本应释放的数据一直留在内存里。 - 缓存没有淘汰策略:缓存命中率高不等于可以无限增长。建议设置过期时间,例如使用
node-cache时配置ttl,或者安排定时清理。 - 事件监听器持续累积:如果请求结束、组件销毁或任务完成后没有执行
emitter.removeListener,监听器数量就会不断增加,连带把闭包中的上下文也一并保留。 - 闭包捕获大对象:异步回调里应避免无意中引用大型数据结构,例如:
setTimeout(() => { /* 避免引用大对象 */ }, 1000)这类代码看起来简单,但如果外层作用域里挂着大对象,实际保留链条会比想象中更长。
不只修泄漏:顺手把内存占用降下来
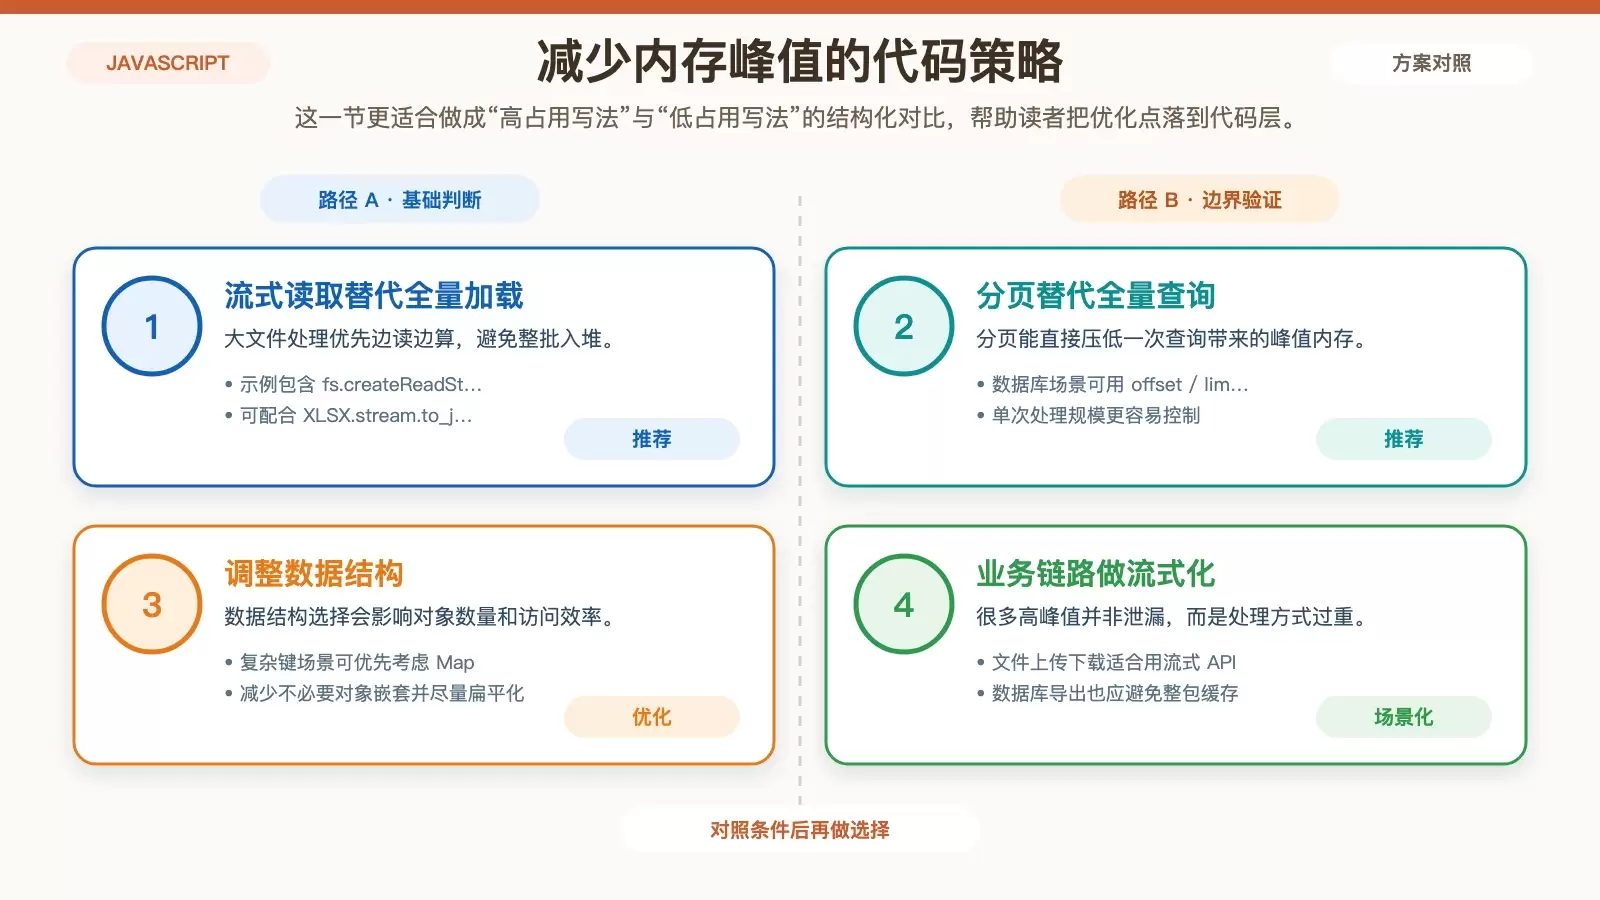
即使没有严格意义上的泄漏,代码层面的数据处理方式不合理,也会显著抬高内存峰值。特别是导入大文件、批量计算或长列表查询时,更容易把堆顶满。
大数据不要一次性全量加载
处理大文件或海量记录时,优先考虑流式读取和分页处理,避免整批数据一次进内存。例如:
// 流式读取Excel文件
const stream = fs.createReadStream('large.xlsx');
const workbook = XLSX.stream.to_json(stream);
workbook.on('data', (row) => { /* 处理单行数据 */ });
workbook.on('end', () => { console.log('处理完成'); });
数据库场景里,也可以使用类似 Sequelize 的 offset / limit 分页查询,控制单次处理的数据规模。
文件和查询尽量使用流式 API
文件上传、下载、日志处理、数据库导出这类操作,优先选择流式 API。这样可以边读边处理,而不是把完整内容先堆在内存里再开始业务逻辑。
数据结构也会影响内存效率
如果键是复杂类型,通常 Map 会比 Object 更合适。除此之外,还要尽量减少不必要的对象嵌套,让结构更扁平,降低对象管理和遍历带来的额外开销。
把监控补上,避免问题拖到崩溃才发现
对于线上服务来说,内存问题最怕“已经持续增长,但没人看见”。因此除了修代码,进程管理和监控也应该同步补齐。
用 PM2 设置自动重启阈值
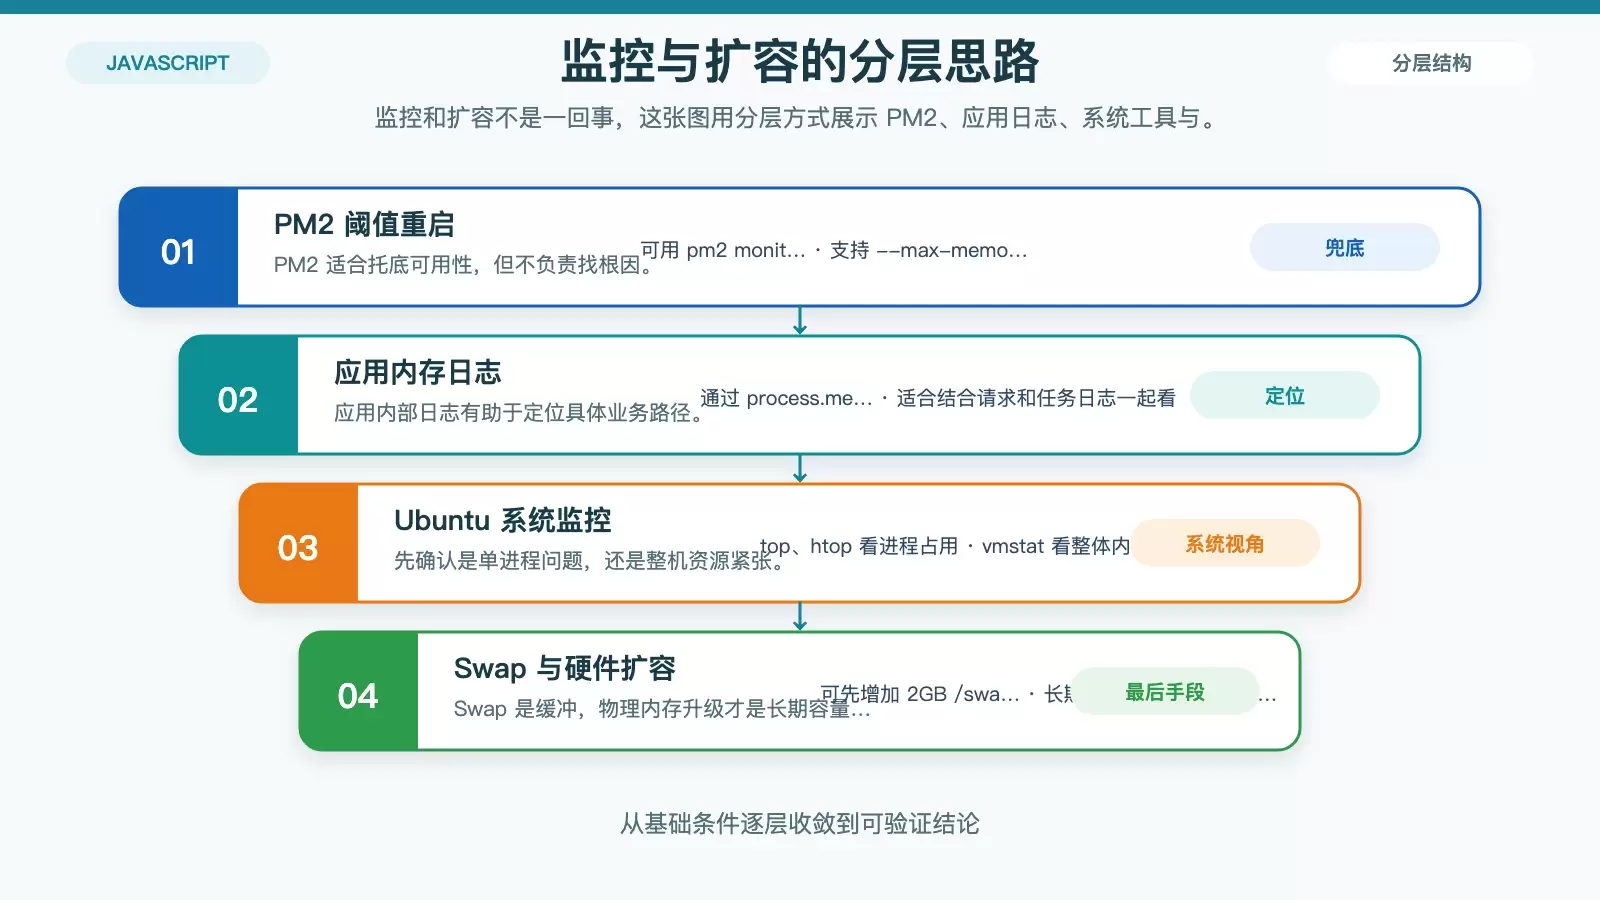
PM2 既能托管 Node.js 进程,也能直接观察资源使用情况。你可以先通过 pm2 monit 查看内存变化,再设置重启阈值:
pm2 start app.js --max-memory-restart 4G
# 内存超过4GB时自动重启
它不能修复泄漏,但能在问题彻底拖垮服务前先兜底。
在应用内部记录内存使用
如果你使用的是 Express,可以增加一个简单中间件,按请求输出内存使用情况:
app.use((req, res, next) => {
  const memory = process.memoryUsage();
  console.log(`[${new Date().toISOString()}] RSS: ${(memory.rss / 1024 / 1024).toFixed(2)}MB`);
  next();
});
这类日志适合和接口访问量、批处理任务、定时任务一起对照,看内存峰值出现在哪个业务路径上。
Ubuntu 系统层面别忽略
应用日志之外,系统工具也很有价值。top、htop 可以直接观察进程内存占用,vmstat 适合看系统整体内存和交换区趋势。Node.js 进程是否真的是“单点爆掉”,还是整台机器资源已经吃紧,这一步能帮你区分清楚。
最后再考虑系统扩容
如果应用本身业务规模就决定了高内存需求,而代码和运行参数已经优化过,那么系统层面的扩容才是最后一步。
先加 Swap 作为缓冲
当物理内存不足时,可以先增加交换空间,给系统留出一定缓冲:
sudo fallocate -l 2G /swapfile  # 创建2GB交换文件
sudo chmod 600 /swapfile        # 设置权限
sudo mkswap /swapfile           # 格式化为交换空间
sudo swapon /swapfile           # 启用交换空间
echo '/swapfile swap swap defaults 0 0' | sudo tee -a /etc/fstab  # 开机自动启用
这能缓解物理内存不足的压力,但因为 Swap 基于磁盘,性能不能等同于真实内存,更适合作为兜底,而不是长期主方案。
长期高负载就直接升级物理内存
如果服务长期稳定需要更高内存,例如从 8GB 持续打满到接近极限,那么把服务器升级到 16GB 或更高,往往比反复微调更实际。前提是你已经确认,问题不是泄漏造成的异常增长。
实操建议:按这个顺序处理更省时间
遇到 Ubuntu 下 Node.js 内存溢出时,建议先看它是偶发峰值,还是持续上涨。偶发峰值可以先通过 --max-old-space-size 和 PM2 阈值重启顶住;持续上涨则优先抓堆快照,分析 Retainers 链和 Dominators 树,再回到代码里处理全局变量、缓存、监听器和闭包问题。只有在应用本身确实需要更多资源时,再去补 Swap 或升级物理内存。









