Node.js 服务跑在 Debian 上后,日志的价值通常集中在三件事:还原事件经过、缩小问题范围、观察系统是否正在逼近瓶颈。真正有用的日志,不是简单打印一句报错,而是让你在看见一条记录时,立刻知道它发生在什么时候、来自哪台机器、影响了哪个请求,以及当时系统处在什么状态。
如果要判断一套日志是否够用,可以从五类信息入手:基础元数据、日志级别、消息体、上下文信息和性能指标。下面按这条思路逐项拆开,看清楚 Node.js 在 Debian 环境下通常应该记录哪些内容,以及这些字段分别解决什么问题。
日志的目标:追踪事件、排查故障、监控状态
在 Debian 上部署 Node.js 应用后,日志首先承担的是可观测性职责。无论是服务异常退出、接口偶发超时,还是资源使用率持续升高,最后都要回到日志里找线索。
从用途上看,日志通常服务于三个方向:
- 事件追踪:把一段时间内发生过什么按顺序串起来。
- 问题排查:定位错误来自哪台主机、哪个进程、哪次请求。
- 系统监控:通过持续记录的状态和指标,提前发现负载或性能异常。
因此,日志内容不能只关注错误本身,还要覆盖事件背景和运行状态。
基础元数据:先解决“这条日志是谁写的”
元数据是日志分析的起点。没有这部分信息,后面的错误内容再详细,也很难放回真实的运行场景里。
时间戳用于还原事件时间线
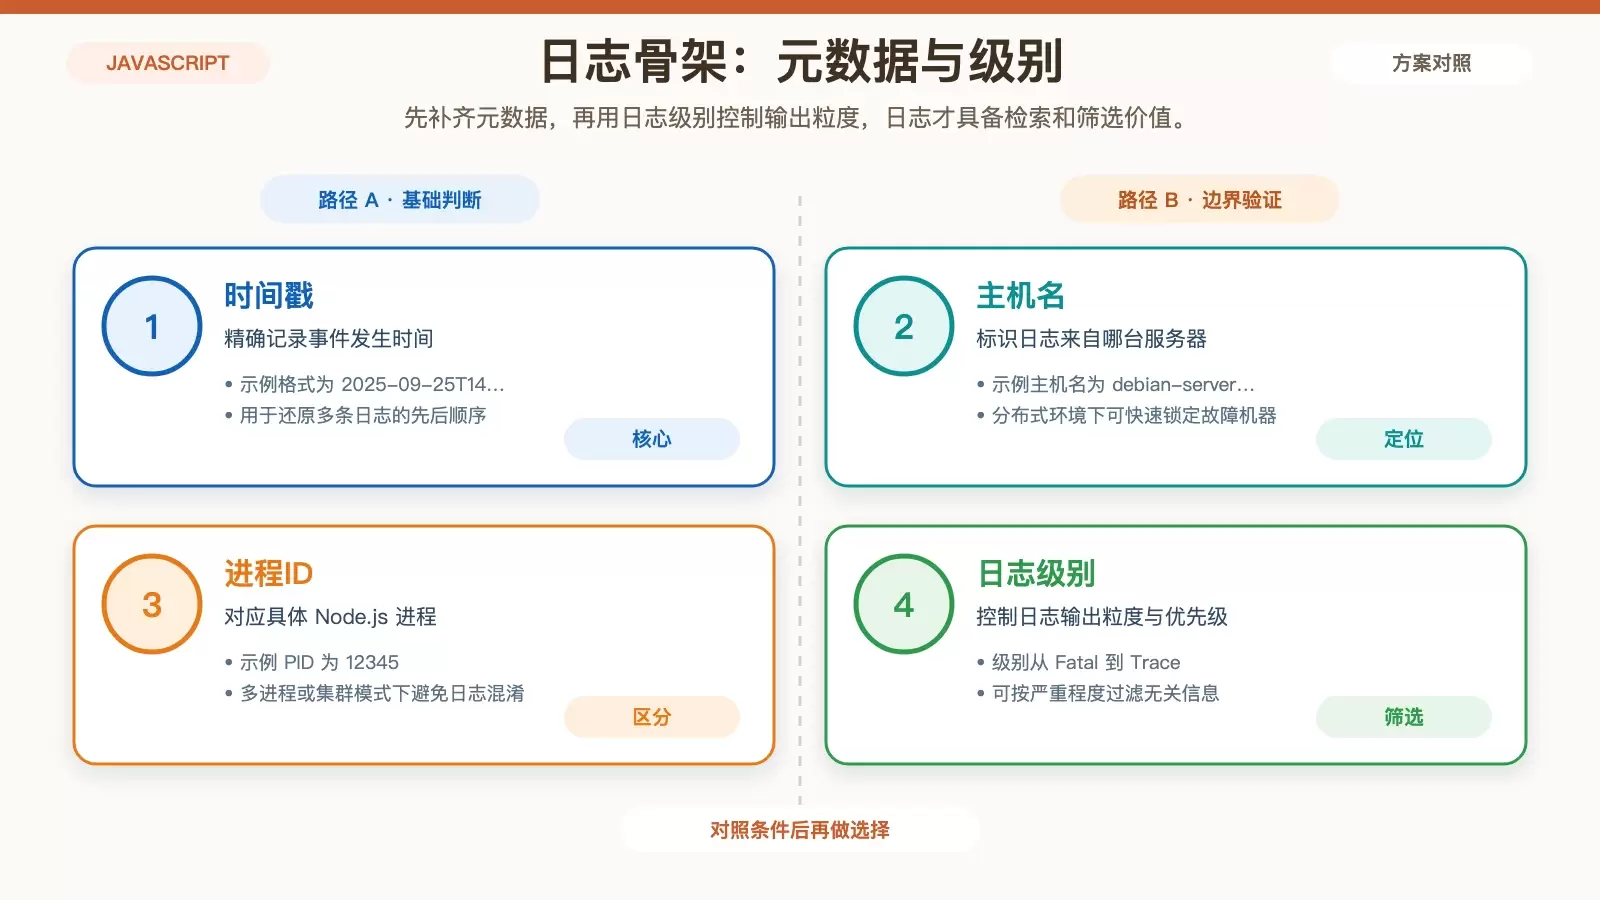
时间戳(Timestamp)记录的是日志事件发生的精确时间,例如 2025-09-25T14:30:00.123Z。排查问题时,它的作用不是单纯“记一下时间”,而是帮助你把多条日志按先后顺序拼接起来,判断异常是在请求进入前、处理中,还是收尾阶段发生的。
主机名用于定位具体服务器
主机名(Hostname)用于标识日志来自哪台机器,例如 debian-server-01。如果服务跑在多台 Debian 服务器上,这个字段能让你迅速确认故障是否只出现在单机,还是已经扩散到整个集群。
PID用于区分不同 Node.js 进程
进程ID(PID)表示具体由哪个 Node.js 进程输出日志,例如 12345。在多进程、cluster 模式或进程守护场景里,PID 是区分实例行为的重要标识,能避免把不同进程的日志混在一起误判。
这三类字段构成了日志的基础骨架,让每条记录先拥有可定位、可排序、可关联的上下文。
日志级别:用分级机制控制信息密度
日志级别的作用,是让系统在不同场景下输出不同密度的信息,也让运维和开发能按严重程度快速筛选重点内容。
- Fatal(致命):表示系统已经崩溃或无法继续运行,例如数据库连接完全中断,需要立即处理。
- Error(错误):表示某个操作失败,但系统整体仍可继续运行,例如接口调用超时、文件读取失败。
- Warn(警告):表示潜在问题或异常情况,例如内存使用率超过阈值、收到无效用户输入。
- Info(信息):记录常规运行事件,例如服务启动、服务停止、用户登录成功。
- Debug(调试):记录更细的诊断信息,例如请求参数、中间件执行流程,常用于开发或测试阶段排查 bug。
- Trace(追踪):记录非常细粒度的执行细节,例如函数调用栈、数据库查询 SQL,适合深入定位复杂问题或分析性能。
级别设计得当,日志系统就能同时满足两种需求:线上环境保留关键信号,开发排查时再放大细节。这样既能减少噪音,也不会在真正出问题时缺少必要信息。
消息体:把“发生了什么”说明白
如果说元数据解决的是“谁在什么时候写下了这条日志”,那消息体解决的就是“到底发生了什么”。这部分决定了日志是否真的可读、可查、可复盘。
错误详情决定排障效率
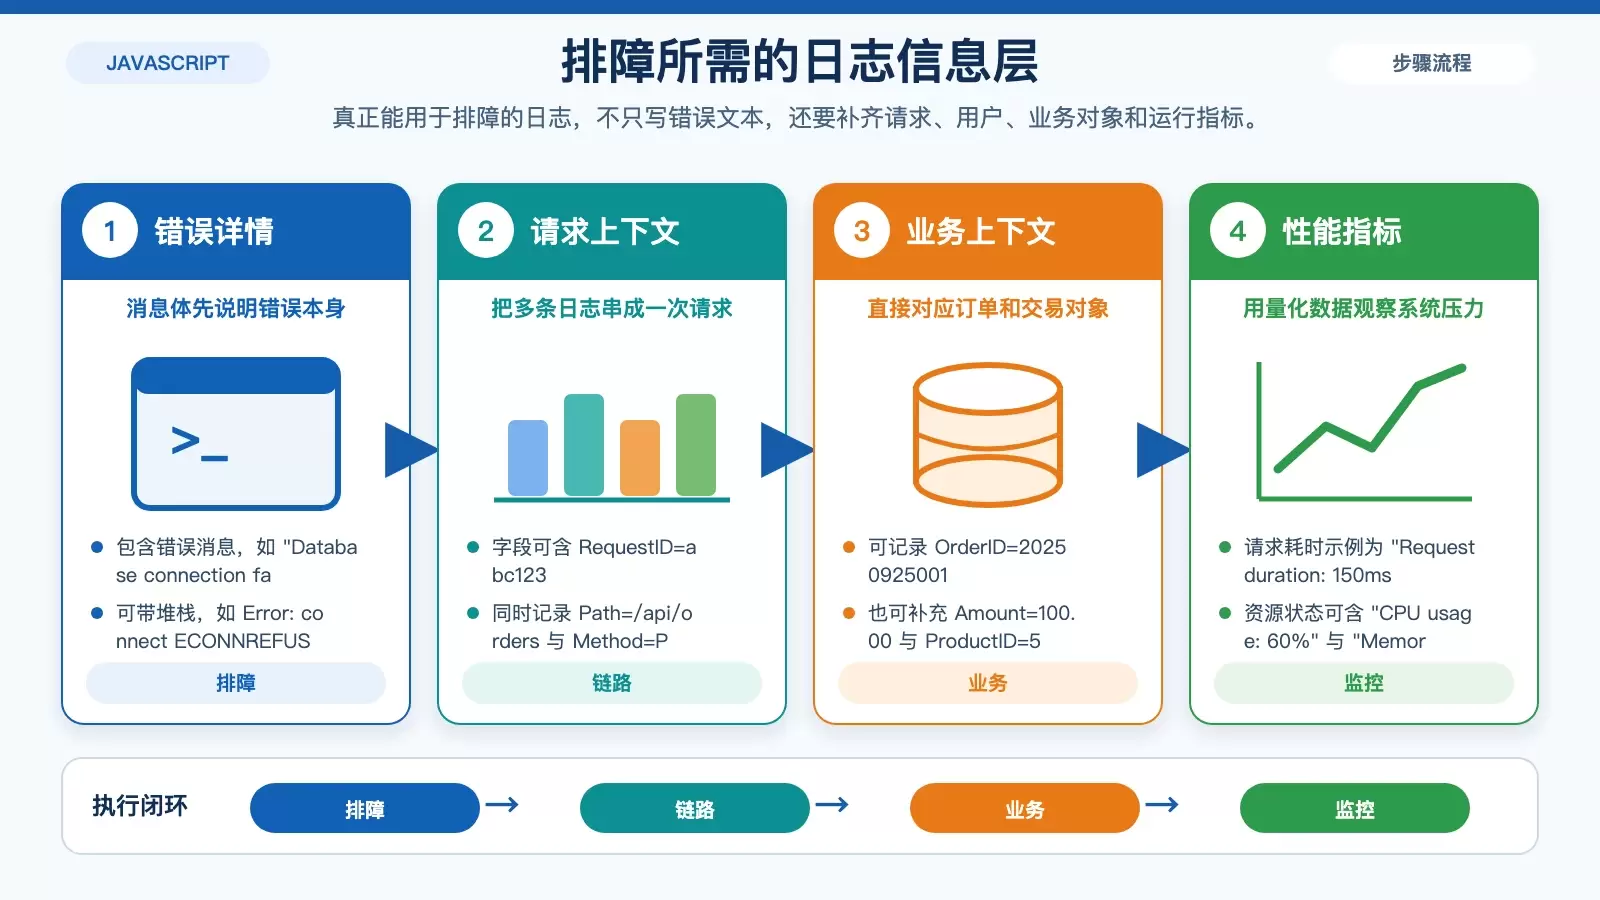
错误类日志至少应包含明确的错误消息,以及必要时的堆栈跟踪。例如 "Database connection failed",以及 Error: connect ECONNREFUSED 127.0.0.1:3306。前者说明失败类型,后者提供更接近根因的技术细节。
操作记录用于审计和业务追踪
日志也应该记录用户或系统执行了哪些关键动作,例如 "User logged in: UserID=1001"、"Order created: OrderID=20250925001"。这类记录适合用来回放业务流程,确认问题发生前后用户到底做过什么。
系统状态反映服务是否健康
一些消息体并不是为了报错,而是为了呈现运行状态,例如 "Server started on port 3000"、"Memory usage: 75%"。这些信息能帮助你判断服务是否正常启动、是否正在接近资源边界。
这里还有一个关键点:消息体的细节深度通常要跟日志级别匹配。比如 Info 更适合记录关键动作,Debug 才适合展开更完整的过程细节。
上下文信息:让日志能关联到请求、用户和业务对象
很多问题不是看一条日志就能定位,而是要把多条记录串起来。上下文信息的作用,就是把一条日志挂到某个用户、某次请求或某个业务实体上。
用户字段帮助定位受影响对象
常见的用户上下文字段包括用户 ID 和角色,例如 UserID=1001、Role=admin。当问题只影响特定用户群体时,这类信息能帮助你快速缩小范围。
请求字段用于串联完整调用链
请求相关信息通常包括请求 ID、请求路径和请求方法,例如 RequestID=abc123、Path=/api/orders、Method=POST。当系统采用 Trace ID 或类似链路追踪机制时,这些字段尤其关键,能把网关、应用和下游服务的记录串成一条完整链路。
业务字段直接对应业务问题
业务上下文通常按场景定制,例如 OrderID=20250925001、Amount=100.00、ProductID=5001。它们最大的价值在于,日志不再只是技术人员才能读懂的系统输出,而是能直接对上订单、交易和商品等业务对象。
上下文信息越完整,日志越接近“可检索的事实记录”,尤其适合分布式系统、接口聚合层和复杂业务流程排查。
性能指标:把运行压力写进日志
在生产环境里,日志除了记录事件,还应该承担一部分监控职责。尤其当没有把所有指标都接入独立监控平台时,性能类日志能提供很直接的现场信息。
- 请求持续时间:例如
"Request duration: 150ms",适合用来识别慢请求;如果请求超过200ms,通常就值得持续关注。 - 活动请求数:例如
"Active requests: 10",可以反映当前服务负载是否正在升高。 - 资源使用率:例如
"CPU usage: 60%"、"Memory usage: 75%",用于识别 CPU 或内存是否接近瓶颈。
这些指标不会直接告诉你“哪里坏了”,但能回答另一个关键问题:问题出现时,系统是否正处在高负载或资源紧张状态。很多偶发故障,最终都要结合这类数据才能解释清楚。
一条有用的 Node.js 日志,至少应包含什么
综合来看,Debian 上的 Node.js 日志如果要真正服务排障和监控,至少应覆盖五类内容:能定位来源的元数据、能区分紧急程度的级别、能说明事件本身的消息体、能串起链路的上下文,以及能反映运行压力的性能指标。
再往前走一步,开发者还可以继续完善日志格式和输出目标,例如写入文件、接入系统日志或发送到第三方日志服务。但在此之前,先把“记录什么”定义清楚,日志体系才有分析价值。


