很多触发器在测试环境里看起来“能跑”,一上线遇到批量插入、批量更新,问题就开始出现:漏数据、误更新、性能骤降,甚至递归触发把自己打爆。根子通常不是业务太复杂,而是把 inserted、deleted 当成单行记录在处理。
这篇文章按几个最容易踩坑的场景展开,先说明为什么标量变量会天然漏数据,再给出基于 FROM inserted 的集合写法,并补上分支逻辑和 INSTEAD OF 触发器的边界。看完你可以快速判断:哪些写法只是“碰巧可用”,哪些才适合真实批量场景。
为什么用标量变量接 inserted 一定会漏数据
在 SQL Server 触发器里,inserted 和 deleted 都是表,不是单条记录。只要写成标量变量赋值,就已经把多行场景处理坏了。
典型问题写法如下:
SELECT @id = id FROM inserted多行插入或更新时,这条语句只会保留最后一行的值,其余行都会被丢掉。这不是偶发行为,而是 SQL Server 对标量变量赋值的确定性结果:不报错,但逻辑已经失效。
这类问题为什么在测试时不容易暴露
- 单行操作时看起来一切正常,但一到批量场景,比如
INSERT INTO t VALUES (1),(2),(3),触发器就只处理其中一行。 - 如果后续拿
@id去调用存储过程,或更新关联表,其他行会被直接跳过。 @@ROWCOUNT也不能补救,因为它返回的是上一条语句影响的行数,不是inserted里的实际数据集。
因此,这类触发器最危险的地方就在于:它经常不是“立刻报错”,而是悄悄漏业务数据。

正确思路:直接基于 FROM inserted 做集合操作
触发器里最基本的原则,就是把 inserted 当成普通表来处理。凡是能用集合更新完成的事情,都不要退回到单行变量或子查询思路。
为什么子查询经常写出问题
常见误区是把触发器当成存储过程来写,例如:
UPDATE t SET col = (SELECT val FROM inserted)如果 inserted 返回多行,这种写法会直接报错:“子查询返回多行”。真正稳妥的方式,是使用 JOIN 或 FROM inserted 做集合更新。
几种更稳妥的写法
更新主表自身时,可以这样写:
UPDATE p SET p.updated_at = GETDATE() FROM products p INNER JOIN inserted i ON p.id = i.id写日志表时,可以直接从 inserted 批量落表:
INSERT INTO audit_log (table_name, row_id, op) SELECT 'orders', i.id, 'INSERT' FROM inserted i还有一种常见但不推荐的写法,是再回头查一次原表:
SELECT * FROM orders WHERE id IN (SELECT id FROM inserted)这会带来两个问题:
- 它会二次读取原表,增加不必要的访问成本。
- 在不合适的隔离级别或缺少索引时,可能读到未提交数据,甚至触发表扫描。
所以,能直接从 inserted 取数据,就不要绕回原表再查一遍。
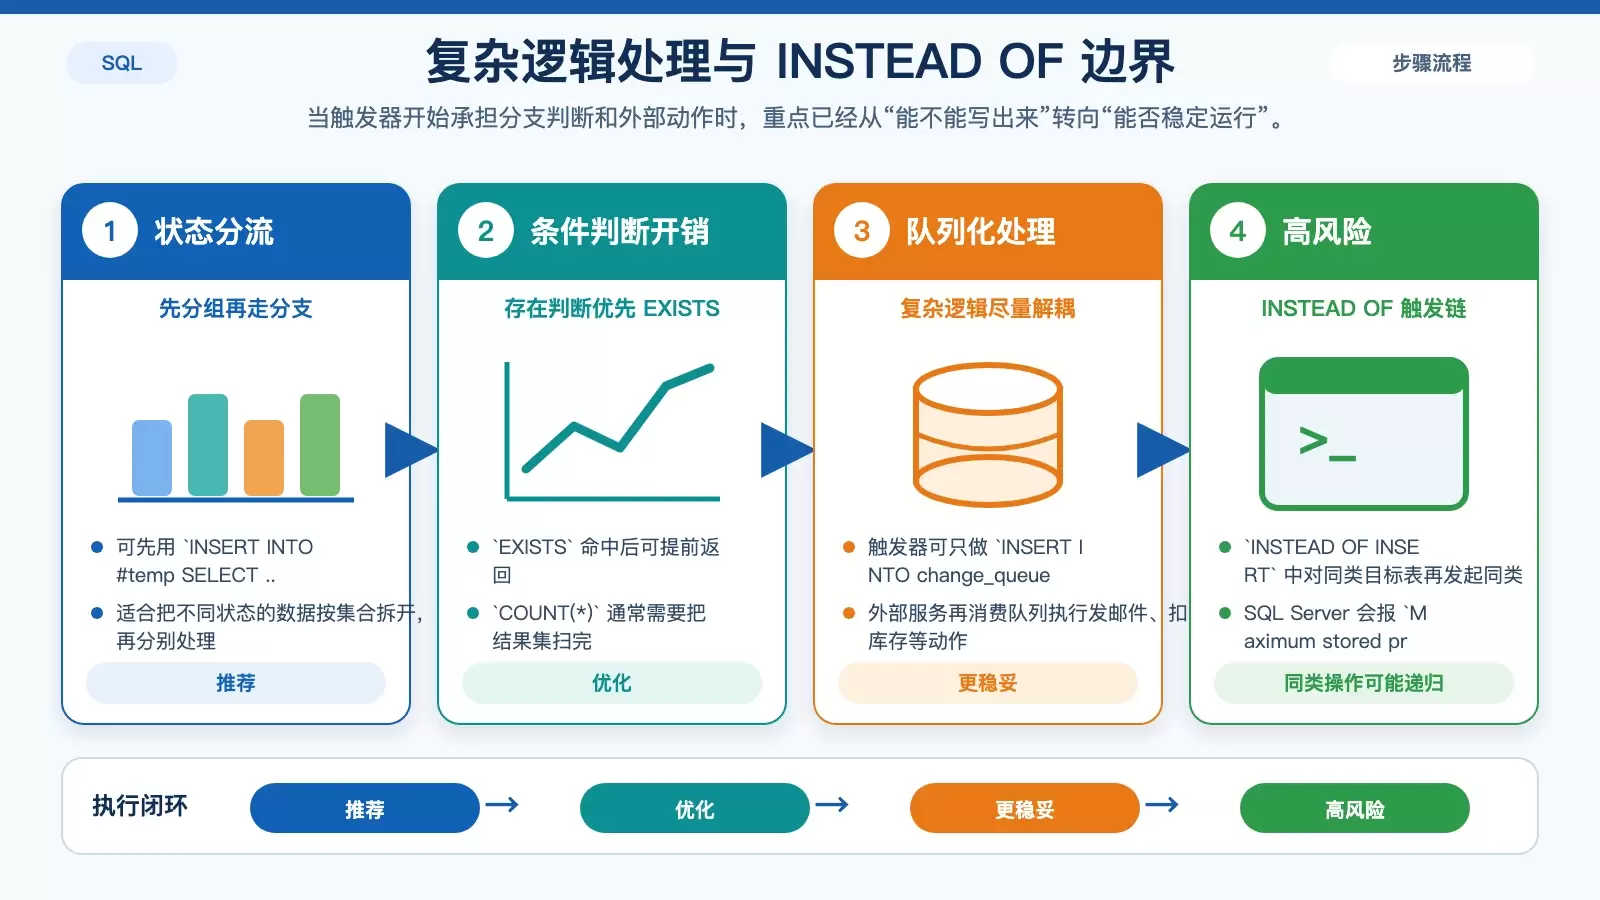
需要按条件分支时,先分组再处理
有些触发器会根据字段值走不同流程,比如 status=1 发邮件、status=2 扣库存。这里最容易出现的误区,是觉得“既然要逐条判断,那就上游标或 WHILE 循环”。
问题在于,循环式触发器在批量场景下性能会明显下滑,也更容易造成锁竞争和死锁。
更适合触发器的写法
如果确实要区分不同数据集,应该先把它们按条件拆开,再分别处理。例如:
INSERT INTO #temp SELECT ... FROM inserted WHERE status = 1这样做的核心不是“引入临时表”,而是先按集合切分,再决定后续动作,而不是在触发器里一行一行循环判断。
判断是否存在某类数据时,也优先使用:
EXISTS而不是:
IF (SELECT COUNT(*) FROM inserted WHERE ...)原因很直接:EXISTS 可以短路,一旦命中就返回;COUNT(*) 往往要把结果集扫完。
更推荐的做法:把复杂逻辑从触发器里拆出去
如果分支逻辑已经涉及发消息、扣库存、调用外部服务这类重操作,更稳妥的方案通常不是把逻辑硬塞进触发器,而是彻底解耦:
INSERT INTO change_queue (...) SELECT ... FROM inserted让触发器只负责把变更写入队列,再由外部服务消费队列并执行具体逻辑。这样更容易控制性能、失败重试和业务隔离,也能减少触发器对事务时间的拉长。
为什么 INSTEAD OF 触发器尤其要防递归
INSTEAD OF 触发器的意思不是“在原操作前再补点逻辑”,而是“用你自己的逻辑替代这次操作”。这类触发器如果写错,最典型的问题就是递归触发自身。
例如,在 INSTEAD OF INSERT 中对同一目标表再次执行同类操作,就可能不断触发自己,直到 SQL Server 报错:
Maximum stored procedure, function, trigger, or view nesting level exceededINSTEAD OF 的边界要点
INSTEAD OF的本意是替代原操作,所以你必须明确决定:这次数据是否要真正落库,以及用什么方式落库。- 如果确实要写入目标表,应直接使用类似
INSERT INTO target_table SELECT ... FROM inserted的集合写法,不要再额外对同类表做UPDATE或DELETE式联动。 - 含级联外键的表本身就不允许创建
INSTEAD OF DELETE,这类限制在 DDL 层就会被拦下,不值得继续往运行时问题上排查。
这部分最关键的判断标准只有一个:你写的是“替代原操作的最终执行逻辑”,还是“对原表再次发起同类动作”。一旦是后者,就要警惕递归链条。
写触发器时,先接受一个前提:inserted 永远是表
真正难的不是把触发器写到“能执行”,而是始终坚持集合思维。哪怕这次业务表面上只改一行,inserted 和 deleted 也仍然是表结构,不应该按单行变量去处理。
可以把判断标准简化成三条:
- 凡是
SELECT @var = ... FROM inserted这类写法,都应默认存在漏数据风险。 - 凡是能直接从
inserted完成的更新、插入、记录动作,都优先写成集合操作。 - 凡是复杂分支、外部调用、长耗时任务,都尽量从触发器中拆出,用队列或外部服务承接。
只要先把这个前提立住,触发器的大部分线上事故,其实都能在设计阶段提前避开。









