

排查线上问题时,最怕的不是报错本身,而是日志里没有一条能把整次请求串起来。尤其在并发高、服务多的系统里,如果没有统一的请求标识和自动化日志记录,开发、测试和运维都会陷入“先找日志、再拼链路”的低效状态。
这篇文章把 Spring Boot 中一套实用的落地方案拆开讲:先用 MDC 和 Filter 给每个请求挂上 TraceId,再用 AOP 统一记录接口入参、出参和耗时,最后补上敏感信息脱敏与生产环境最佳实践。看完后,你可以判断这套方案适合什么场景、哪些细节必须补齐,以及上线前要重点检查什么。
为什么要做全局日志和链路追踪
很多团队最早都是在业务代码里手写 log.info(...)。这种方式在单体、低并发场景下还勉强够用,但一旦接口增多、调用链变长,问题会迅速暴露出来。
- 没有唯一标识时,并发请求混在一起,想从日志里找出某个用户那一次调用,几乎只能靠人工筛选。
- 服务一旦跨机器、跨进程,日志会分散在不同节点上,没有统一请求 ID 就很难把链路重新拼起来。
- 如果每个接口都手写入参、出参和耗时日志,代码会越来越重复,漏打和乱打日志也很常见。
要解决这些问题,至少需要两项能力:
- 链路追踪(TraceId):为每次请求生成唯一 ID,并让它贯穿整个处理流程。
- 全局日志:自动记录接口的入参、出参、耗时,减少业务层重复编码。
MDC 如何承载 TraceId
MDC(Mapped Diagnostic Context)是 Slf4j 提供的上下文机制,本质上可以理解为一个线程级别的 ThreadLocal。把 traceId 放进去之后,Logback 就能通过 %X{traceId} 自动取出并写入日志。
它的价值在于:日志输出不需要每次手工拼接 TraceId,而是天然绑定当前线程上下文。同一请求内的日志,只要运行在线程上下文中,就会带上相同的标识。
先写一个 TraceId 工具类
这个工具类的职责很简单,就是围绕 MDC 做 get、put 和 remove。其中 remove 不能省,这是避免线程池复用导致脏数据污染的关键。
public class TraceIdUtil {

    private static final String TRACE_ID_KEY = "traceId";

    /**
     * 获取当前线程的 TraceId
     */
    public static String getTraceId() {
        String traceId = MDC.get(TRACE_ID_KEY);
        return StringUtils.isEmpty(traceId)  "" : traceId;
    }

    /**
     * 设置 TraceId
     */
    public static void setTraceId(String traceId) {
        MDC.put(TRACE_ID_KEY, traceId);
    }

    /**
     * 清除 TraceId (非常重要,防止线程池复用导致数据污染)
     */
    public static void removeTraceId() {
        MDC.remove(TRACE_ID_KEY);
    }
}
用 Filter 在请求入口注入 TraceId
真正的入口通常不是 Controller,而是更靠前的过滤器。这里的常见做法是:
- 先尝试从请求头
X-Trace-Id读取上游传下来的 TraceId。 - 如果上游没有传,就在当前服务本地生成一个 UUID。
- 把生成或获取到的 TraceId 放进 MDC。
- 请求处理完成后,在
finally中清理 MDC。
这样做的好处是,不管后续 Controller、Service 还是 DAO 打了什么日志,只要走的是同一个线程上下文,都能自动带上相同的 traceId。
@Slf4j
@Component
@Order(Ordered.HIGHEST_PRECEDENCE) // 确保最先执行
public class TraceIdFilter implements Filter {

    @Override
    public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) throws IOException, ServletException {
        HttpServletRequest httpRequest = (HttpServletRequest) request;

        try {
            // 尝试从请求头获取 TraceId(适用于网关传递过来的场景)
            String traceId = httpRequest.getHeader("X-Trace-Id");
            if (StringUtils.isEmpty(traceId)) {
                traceId = UUID.randomUUID().toString().replace("-", "");
            }
            TraceIdUtil.setTraceId(traceId);

            chain.doFilter(request, response);
        } finally {
            // 务必清理,防止内存泄漏或线程池复用导致的脏数据
            TraceIdUtil.removeTraceId();
        }
    }
}
在 Logback 里输出 TraceId
接下来只需要在日志格式中加入 %X{traceId},TraceId 就会跟着每条日志一起输出。
${LOG_PATTERN}
配置完成后,日志会变成类似这样:
2023-10-01 12:00:00.001 [http-nio-8080-exec-1] [a1b2c3d4e5f6...] INFO c.e.controller.UserController - User created successfully
这时候再按订单号、用户 ID 或错误时间去查日志,至少可以很快锁定同一请求链路上的所有记录,而不是在并发日志里来回翻。
AOP 怎样统一记录接口日志
有了 TraceId,只解决了“能串起来”的问题;但如果每个接口的入参、出参、耗时还要手写,那这套方案依旧不够省心。AOP 的作用,就是把这些重复日志从业务代码中抽出来,统一记录。
先确认 AOP 依赖和开关
这里需要确保项目已经引入 spring-boot-starter-aop,并启用切面能力。原文提到在启动类或配置类上加 @EnableAspectJAutoProxy,而 Spring Boot 在很多场景下会自动配置,但项目里仍然应该确认这一点。
切面里重点记录哪些内容
比较常见的切入点是拦截 Controller 层 public 方法。一次完整的接口日志,通常至少要包含:
- 当前请求的
traceId - HTTP 方法、URL、客户端 IP
- 执行的方法名
- 过滤后的请求参数
- 返回结果
- 接口耗时
下面这段代码就是一个可直接理解的实现方式:
@Slf4j
@Aspect
@Component
public class ControllerLogAspect {

    // 定义切点:拦截 Controller 包下的所有方法
    @Pointcut("execution(public * com.example..controller..*.*(..))")
    public void controllerLog() {}

    @Around("controllerLog()")
    public Object doAround(ProceedingJoinPoint joinPoint) throws Throwable {
        long startTime = System.currentTimeMillis();

        // 获取请求信息
        ServletRequestAttributes attributes = (ServletRequestAttributes) RequestContextHolder.getRequestAttributes();
        HttpServletRequest request = attributes.getRequest();

        // 构建日志对象
        LogInfo logInfo = new LogInfo();
        logInfo.setTraceId(TraceIdUtil.getTraceId());
        logInfo.setMethod(request.getMethod());
        logInfo.setUrl(request.getRequestURI());
        logInfo.setIp(request.getRemoteAddr());
        logInfo.setClassMethod(joinPoint.getSignature().getDeclaringTypeName() + "." + joinPoint.getSignature().getName());

        // 获取入参,过滤掉 HttpServletRequest、HttpServletResponse 等无法序列化的参数
        Object[] args = joinPoint.getArgs();
        Object[] logArgs = Arrays.stream(args)
                .filter(arg -> !(arg instanceof HttpServletRequest) && !(arg instanceof HttpServletResponse))
                .toArray();
        logInfo.setArgs(logArgs);

        // 打印入参日志
        log.info("Request Info: {}", JSON.toJSONString(logInfo));

        Object result;
        try {
            result = joinPoint.proceed();
        } catch (Exception e) {
            // 记录异常日志(通常由全局异常处理器处理,这里也可以记录一份用于审计)
            log.error("Controller Exception: ", e);
            throw e;
        }

        // 计算耗时
        long costTime = System.currentTimeMillis() - startTime;
        logInfo.setCostTime(costTime);
        logInfo.setResult(result);

        // 打印出参日志
        log.info("Response Info ({}ms): {}", costTime, JSON.toJSONString(logInfo));

        return result;
    }

    @Data
    public static class LogInfo {
        private String traceId;
        private String method;
        private String url;
        private String ip;
        private String classMethod;
        private Object[] args;
        private Object result;
        private Long costTime;
    }
}
这段切面代码的几个关键点
这套实现的核心不只是“能打日志”,而是尽量避免副作用:
- 统一取 TraceId:通过
TraceIdUtil.getTraceId()直接拿当前线程上下文,保持日志链路一致。 - 过滤不可序列化参数:像
HttpServletRequest、HttpServletResponse这类对象不适合直接转 JSON,需要提前剔除。 - 异常日志单独记录:即便全局异常处理器还会处理一遍,这里保留错误日志也更利于审计与排查。
- 耗时计算放在环绕通知中:这样可以准确覆盖整个方法调用周期。
敏感信息为什么必须先脱敏再落日志
全局日志一旦打通,另一个问题就会马上出现:你记录得越完整,越容易把手机号、身份证号、密码等敏感信息一起写进日志。开发阶段图省事,生产环境往往就会留下合规和安全风险。
原文给出的方案是通过 Jackson 自定义序列化器,在对象序列化为 JSON 时对敏感字段做脱敏处理。这个思路的好处是粒度明确,字段控制也更直观。
自定义敏感字段序列化器
public class SensitiveDataSerializer extends JsonSerializer {
    @Override
    public void serialize(String value, JsonGenerator gen, SerializerProvider serializers) throws IOException {
        if (StringUtils.isEmpty(value)) {
            gen.writeNull();
            return;
        }
        // 简单的脱敏逻辑:保留前 3 后 4,中间星号
        if (value.length() > 8) {
            gen.writeString(value.substring(0, 3) + "****" + value.substring(value.length() - 4));
        } else {
            gen.writeString("****");
        }
    }
}
在 DTO 字段上直接标注使用
public class UserDTO {

    @JsonSerialize(using = SensitiveDataSerializer.class)
    private String phone;

    // ...
}
这种方式适合字段规则比较明确的项目。如果项目里日志输出非常集中,也可以像原文提到的那样,在 AOP 中先把对象转成 JSON,再通过正则统一替换敏感内容。不过这种方式更依赖规则维护,适合对输出结构比较可控的场景。
生产环境还要补上哪些细节
把 TraceId、AOP 和脱敏接起来后,基础能力基本具备了。但要真正用于生产,还需要补上下面这些细节。
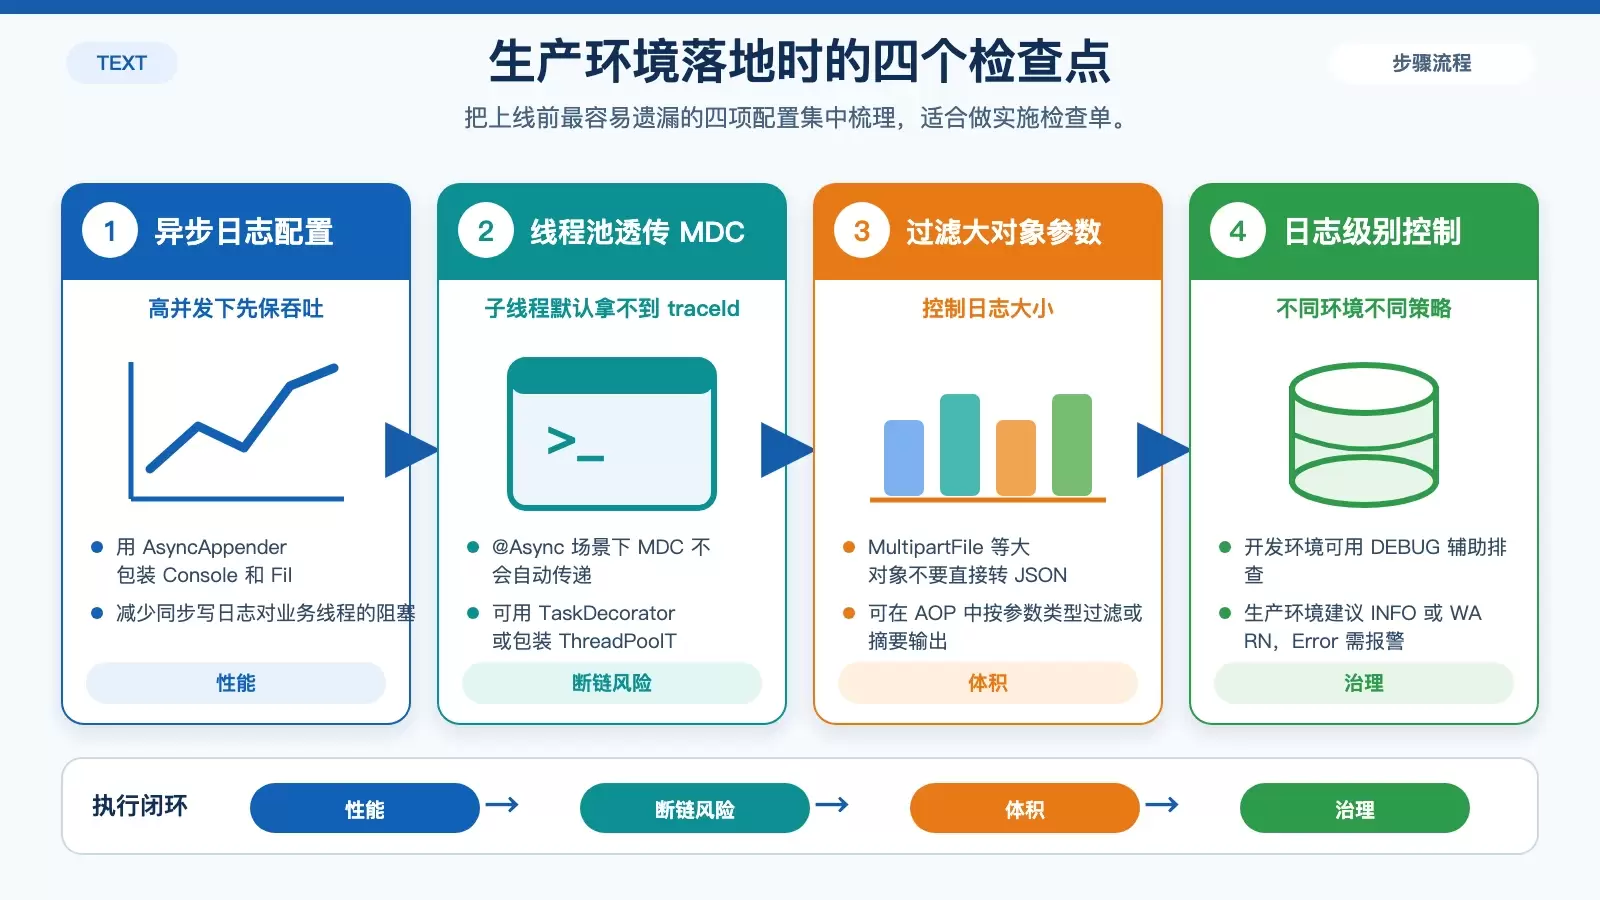
1. 异步日志要尽早启用
生产环境日志量大时,同步写日志会直接阻塞业务线程。原文建议在 Logback 中使用 AsyncAppender 包装 Console 和 File Appender,这一点很实用。否则高峰期接口耗时抖动,日志本身就可能成为性能瓶颈。
2. 线程池里的 MDC 不会自动透传
这是很多人第一次接入链路追踪时最容易踩的坑。MDC 绑定的是当前线程,因此用了 @Async 或自定义线程池后,子线程默认拿不到父线程里的 traceId。
原文给出的建议是实现 TaskDecorator,或者包装 ThreadPoolTaskExecutor,在提交任务时复制 MDC 上下文,任务结束后再恢复。这个动作不补,异步任务日志就会断链。
3. 大对象和文件流不能直接打印
如果接口参数里带有 MultipartFile、大列表或其他重量级对象,直接序列化输出会快速放大日志体积,甚至把日志文件撑爆。比较稳妥的做法是在 AOP 参数过滤时增加类型判断,把这类对象排除掉,或者只保留必要摘要信息。
4. 日志级别要按环境控制
并不是所有日志都应该落到 INFO。开发环境可以适当打开 DEBUG,便于排查细节;生产环境通常更适合 INFO 或 WARN,而 Error 级别日志则应该接入报警系统。否则日志再完整,也会因为噪音太大而失去可读性。
这套方案最终解决了什么
用 MDC + Filter + AOP 这组组合,Spring Boot 项目通常可以一次性解决三件事:
- 全链路追踪:每个请求都有唯一的 TraceId,日志不再是零散片段。
- 自动接口审计:入参、出参、耗时统一记录,减少业务代码中的重复日志。
- 日志安全治理:敏感字段先脱敏再输出,降低数据泄露和合规风险。
如果你的系统已经开始出现“日志很多,但问题还是难查”的情况,这套方案基本就是第一步该补的基础设施。真正上线前,建议优先检查三件事:TraceId 是否稳定透传、异步线程是否不断链、敏感信息是否已经在日志出口完成脱敏。