Excel 数据透视表的优势,在于能把零散数据迅速整理成可读报表;但一旦面对几十个文件、多个工作表,手工拖拽就会变成重复劳动。用 pandas 的 pivot_table,可以把 Excel 里“行、列、值、汇总”的操作写成可复用代码,再进一步扩展到批量读取、统一汇总和自动导出。
这篇文章先从最基础的透视写法讲起,再逐步补到多级索引、多种统计方式,以及几种常见的批量处理场景。看完后,你可以判断自己更适合直接用 pandas 生成结果文件,还是在需要保留 Excel 工作簿交互时引入 xlwings。
先把 Excel 透视表翻译成 pandas 参数
如果你平时习惯在 Excel 里拖拽字段,那么理解 pivot_table 最快的方法,就是把它和 Excel 透视表的区域一一对应起来。

import pandas as pd

df = pd.read_excel("销售数据.xlsx")

pivot = pd.pivot_table(
    df,
    values="销售额",
    index="城市",
    columns="品类",
    aggfunc="sum",
    fill_value=0,
    margins=True,
    margins_name="合计"
)
这段代码完成的事情和 Excel 里的透视操作基本一致:
values="销售额":指定要汇总的数值列。index="城市":把“城市”放到行标签。columns="品类":把“品类”放到列标签。aggfunc="sum":按求和方式聚合。fill_value=0:把空值补成 0,避免结果里出现缺口。margins=True与margins_name="合计":自动补出总计行和总计列。
如果只是把单个 Excel 表里的数据按某个维度汇总,这一段已经覆盖了大多数入门场景。
参数和 Excel 透视区域怎么对应
| Excel 透视表区域 | pandas pivot_table 参数 |
说明 |
|---|---|---|
| 行 | index |
作为行标签的列,可以是单列或多列。 |
| 列 | columns |
作为列标签的列。 |
| 值 | values |
需要进行聚合计算的数值列。 |
| 计算方式 | aggfunc |
聚合函数,如 'sum'、'mean'、'count'。 |
| 总计 | margins |
True 或 False,决定是否显示总计行/列。 |
| 总计名称 | margins_name |
自定义总计行/列的标签,默认为 'All'。 |
| 空值填充 | fill_value |
将透视表中的空值替换为指定值。 |
需要更细维度时,怎么做多级透视和多统计值
实际业务很少只看一层汇总。你可能既要按城市看销售额,也要继续拆到销售员;或者既想看总和,又想看平均值和计数。这些都可以继续放在 pivot_table 里完成。
多级透视:一张表里展开更多维度
当行标签不止一列时,把 index 改成列表即可。
pivot = pd.pivot_table(
    df,
    values="销售额",
    index=["城市", "销售员"],
    columns="季度",
    aggfunc=["sum", "mean"]
)
这里的结果会出现层级索引:
- 行索引先按“城市”,再按“销售员”细分。
- 列索引按“季度”展开。
aggfunc=["sum", "mean"]会同时生成求和和平均值两组结果。
这种结构特别适合做进一步分析,比如看同一城市不同销售员在各季度的表现差异。
多个统计值:一次输出总和、均值、计数和最大值
如果你只想按城市汇总,但希望一次看到多个统计指标,可以把 aggfunc 写成字典。
pivot = pd.pivot_table(
    df,
    values="销售额",
    index="城市",
    aggfunc={"销售额": ["sum", "mean", "count", "max"]}
)
这类写法适合“同一维度下看多种结果”的场景。输出表里,每个城市对应一行,而“销售额”下面会自动展开 sum、mean、count 和 max 四个子列。
原文还提到一个实用细节:这里的 values 参数实际上可以省略,因为 aggfunc 字典的键已经明确指定了计算列。
批量处理前,环境和基础库要准备什么
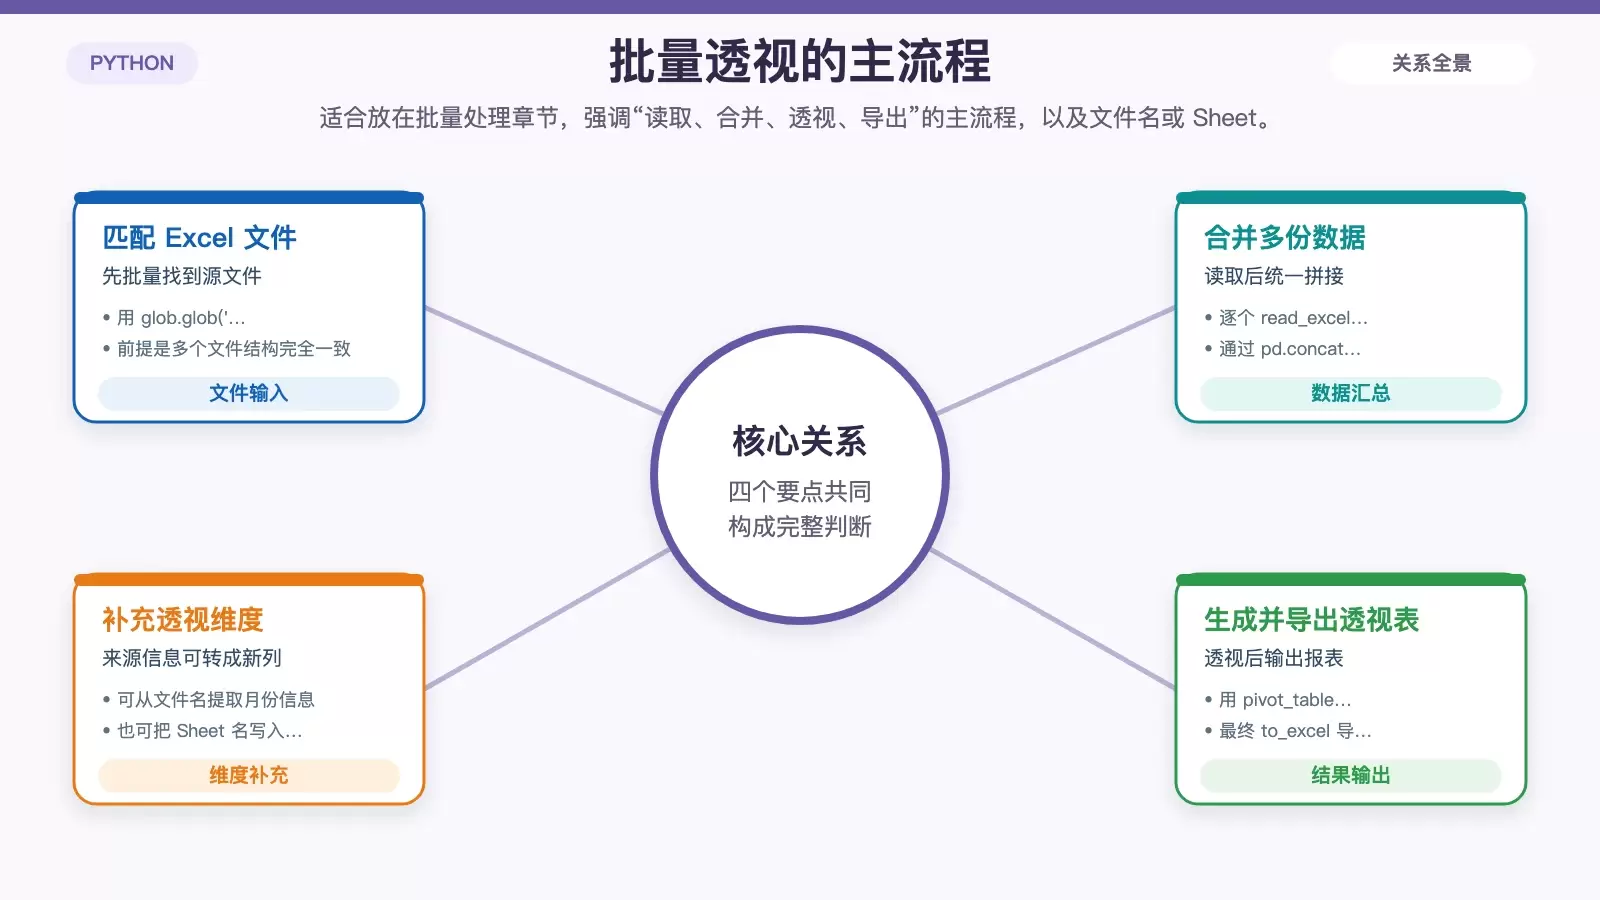
当你开始处理多个工作簿或多个 Sheet 时,核心思路就不只是“透视”,而是“读取 → 合并 → 透视 → 导出”。这一步先把依赖装好。
确保环境中已经安装 pandas 和 openpyxl:
pip install pandas openpyxl
常见导入方式如下,后面的文件批量匹配和路径处理会用到 glob 与 os:
import pandas as pd
import glob
import os
如果你的目标只是批量算结果并导出成新的 .xlsx 文件,这套组合通常就够用了。
四类常见批量场景,分别怎么写
下面几种场景,基本覆盖了用 pandas 批量替代 Excel 手工透视时最常见的需求。
场景一:合并多个 Excel 文件后统一生成透视表
如果数据分散在多个以“销售数据_”开头的文件里,而且结构完全一致,最直接的方式就是先用 glob 找文件,再逐个读取后拼接,最后对合并后的总表做一次透视。
import pandas as pd
import glob
# 1. 获取所有Excel文件路径
file_paths = glob.glob('销售数据_*.xlsx')  # 假设所有文件都以"销售数据_"开头
# 2. 读取并合并所有文件
all_data = pd.DataFrame()
for file in file_paths:
    df = pd.read_excel(file)
    all_data = pd.concat([all_data, df], ignore_index=True)
# (可选) 如果文件名包含月份信息,可以提取出来作为新列
# all_data['月份'] = all_data['文件名'].apply(lambda x: x.split('_')[1])
# 3. 生成数据透视表
pivot_table = pd.pivot_table(all_data,
                             values='销售额',
                             index='地区',
                             columns='产品',
                             aggfunc='sum',
                             margins=True,
                             margins_name='总计',
                             fill_value=0)
# 4. 导出结果
pivot_table.to_excel('汇总透视表.xlsx')
print("透视表已生成!")
这类做法的重点有两个:一是所有源文件字段结构必须一致;二是如果文件名本身携带月份、门店等信息,可以额外提取成新列,后面就能直接加入透视维度。
场景二:把一个工作簿里的多个 Sheet 合并后再透视
另一种常见情况,是一年 12 个月的数据都放在同一个 Excel 工作簿里,只是分散在不同 Sheet。这里可以用 sheet_name=None 一次性读入全部工作表。
import pandas as pd
# 1. 读取所有Sheet,sheet_name=None会返回一个字典
all_sheets = pd.read_excel('全年销售数据.xlsx', sheet_name=None)
# 2. 合并所有Sheet,并添加来源Sheet名作为新列
all_data = pd.DataFrame()
for sheet_name, df in all_sheets.items():
    df['月份'] = sheet_name  # 新增一列标记数据来源
    all_data = pd.concat([all_data, df], ignore_index=True)
# 3. 生成透视表(按月份和地区汇总)
pivot_table = pd.pivot_table(all_data,
                             values='销售额',
                             index=['月份', '地区'],
                             columns='产品',
                             aggfunc='sum',
                             fill_value=0,
                             margins=True,
                             margins_name='总计')
# 4. 导出结果
pivot_table.to_excel('月度销售透视表.xlsx')
这里 pd.read_excel(..., sheet_name=None) 返回的是一个字典,键是 Sheet 名,值是对应的 DataFrame。把 Sheet 名顺手写入新列“月份”后,后续透视时就能直接按月份、地区一起汇总。
场景三:从同一份源数据生成多个透视表并写入一个 Excel
如果你的需求不是做一张透视表,而是想同时得到“按地区汇总”“按产品汇总”“地区 × 产品交叉汇总”,可以用 pd.ExcelWriter 把多个结果写到同一个工作簿的不同 Sheet 中。
import pandas as pd
df = pd.read_excel('源数据.xlsx')
with pd.ExcelWriter('多维度透视报告.xlsx', engine='openpyxl') as writer:
    # 1. 按地区汇总
    pivot1 = pd.pivot_table(df, values='销售额', index='地区',
                            aggfunc='sum', margins=True, margins_name='合计')
    pivot1.to_excel(writer, sheet_name='地区汇总')
    # 2. 按产品汇总
    pivot2 = pd.pivot_table(df, values='销售额', index='产品',
                            aggfunc='sum', margins=True, margins_name='合计')
    pivot2.to_excel(writer, sheet_name='产品汇总')
    # 3. 地区 × 产品 交叉透视
    pivot3 = pd.pivot_table(df, values='销售额', index='地区', columns='产品',
                            aggfunc='sum', fill_value=0, margins=True, margins_name='合计')
    pivot3.to_excel(writer, sheet_name='地区_产品交叉')
这种方式的优点很明确:一次运行,直接得到多张报表,适合定期生成对比分析文件。
场景四:在原有 Excel 工作簿里回写透视结果
有些团队并不满足于“生成一个新结果文件”,而是希望直接打开现有工作簿、遍历其中所有 Sheet,再把每个 Sheet 的透视结果写回同一个工作簿。这时可以考虑 xlwings。
需要注意,原文明确说明这种方式依赖本地安装 Excel,运行时也会调用本机 Excel 应用程序。
import pandas as pd
import xlwings as xw
def batch_pivot_in_workbook(input_xlsx, index_col, value_col, columns_col=None, aggfunc='sum'):
    """遍历Excel中的所有工作表,生成透视表并写入新sheet"""
    app = xw.App(visible=False)
    wb = app.books.open(input_xlsx)
    summary_sheet = wb.sheets.add('透视汇总')
    row_offset = 0
    for sheet in wb.sheets:
        if sheet.name == '透视汇总':
            continue
        # 读取数据
        data_range = sheet.range('A1').expand('table')
        df = data_range.options(pd.DataFrame, header=1).value
        # 清洗数值列(去除货币符号等)
        df[value_col] = df[value_col].astype(str).str.replace(r'[¥$,]', '', regex=True)
        df[value_col] = pd.to_numeric(df[value_col], errors='coerce').fillna(0)
        # 生成透视表
        pivot = pd.pivot_table(df,
                               index=index_col,
                               columns=columns_col if columns_col else None,
                               values=value_col,
                               aggfunc=aggfunc,
                               fill_value=0,
                               margins=True,
                               margins_name='总计')
        # 将透视表写入汇总sheet
        summary_sheet.range(row_offset + 1, 1).value = f'--- {sheet.name} 的透视结果 ---'
        summary_sheet.range(row_offset + 2, 1).value = pivot
        row_offset += len(pivot) + 4  # 为下一个透视表留出空行
    wb.sa ve()
    wb.close()
    app.quit()
    print(f"批量透视完成,结果已写入 '透视汇总' sheet。")
# 调用函数
batch_pivot_in_workbook('数据文件.xlsx', index_col='地区', value_col='销售额', columns_col='产品')
这段代码的核心价值,不是单纯做汇总,而是把“读取原表、清洗数值、生成透视、写回工作簿”连成一个完整流程。对于仍然强依赖 Excel 交互环境的团队,这会比单独导出结果文件更贴近现有习惯。
什么时候只用 pandas,什么时候再加 xlwings
从本文几个示例可以看出,pivot_table 始终是中心能力,真正的差别在于数据从哪里来、结果要写到哪里去。
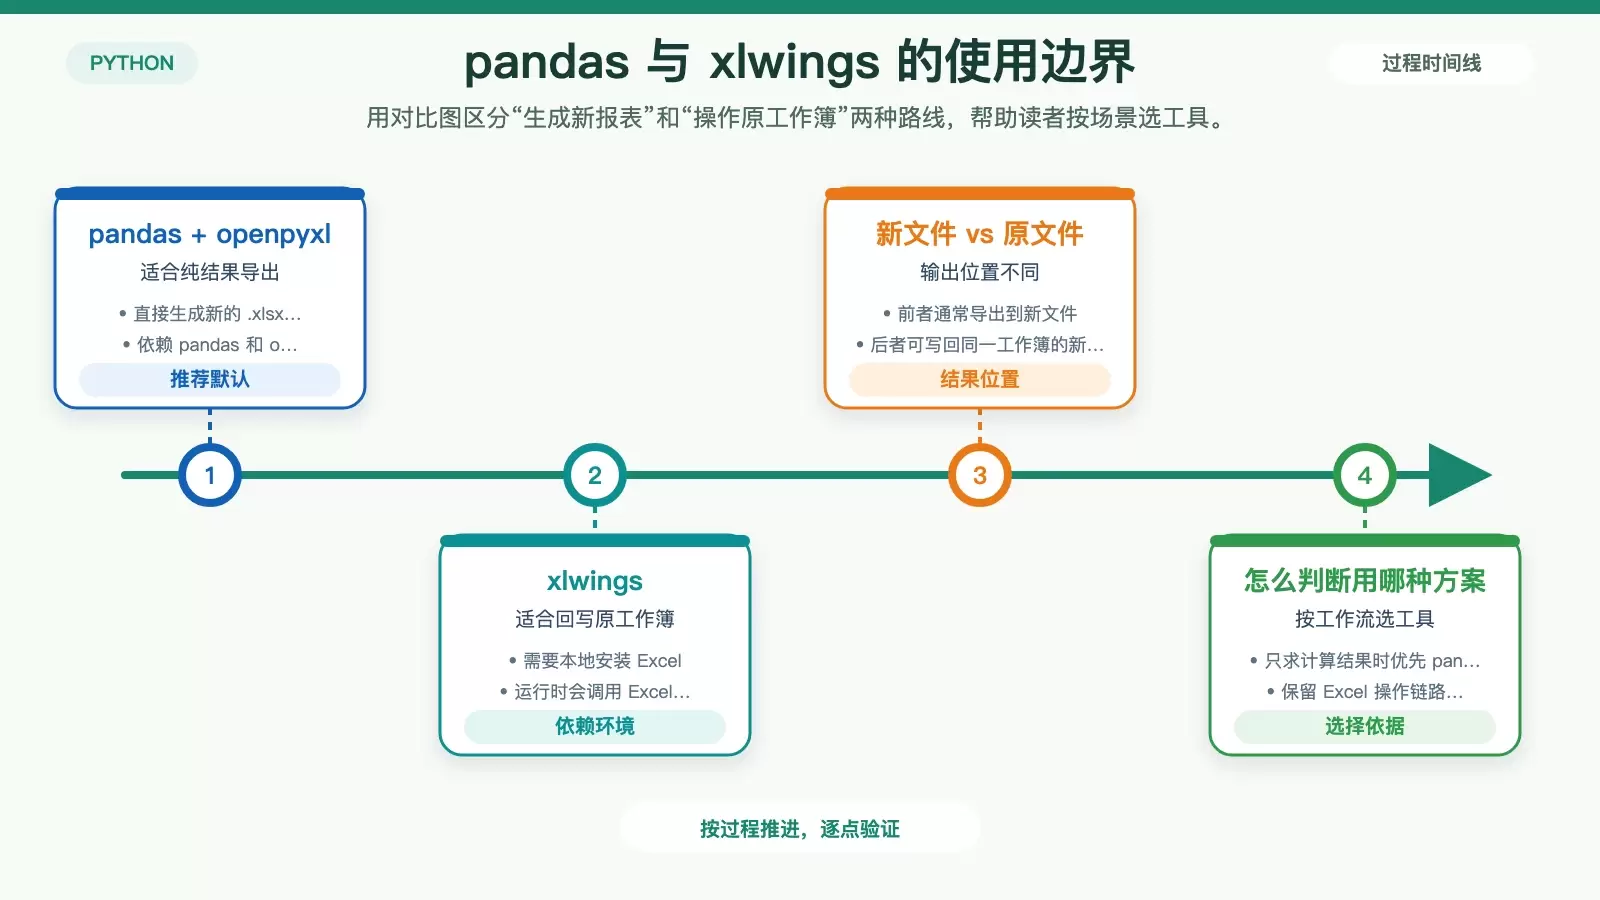
- 如果只是读取数据、计算结果、导出新的
.xlsx报表,用pandas+openpyxl通常已经足够。 - 如果需要直接操作现有 Excel 工作簿,并把结果回写到原文件中,可以考虑
xlwings。
可以把这类批量任务概括成一个固定套路:先读取,再合并,再透视,最后导出。只要源数据字段结构稳定,很多原本需要反复手工点选的 Excel 工作,最后都能收敛成一段可以重复执行的 Python 脚本。