Node.js 项目跑在 Ubuntu 上,性能问题通常不是单点造成的:有时是文件描述符不够,有时是同步 I/O 卡住事件循环,也可能是数据库、缓存或多核利用方式出了问题。下面按“系统环境、代码路径、并发管理、数据访问、监控验证”几条主线拆开讲,既保留能直接落地的命令和代码,也方便你判断每一类优化适合先做哪一步。
Ubuntu 系统层先补齐基础容量
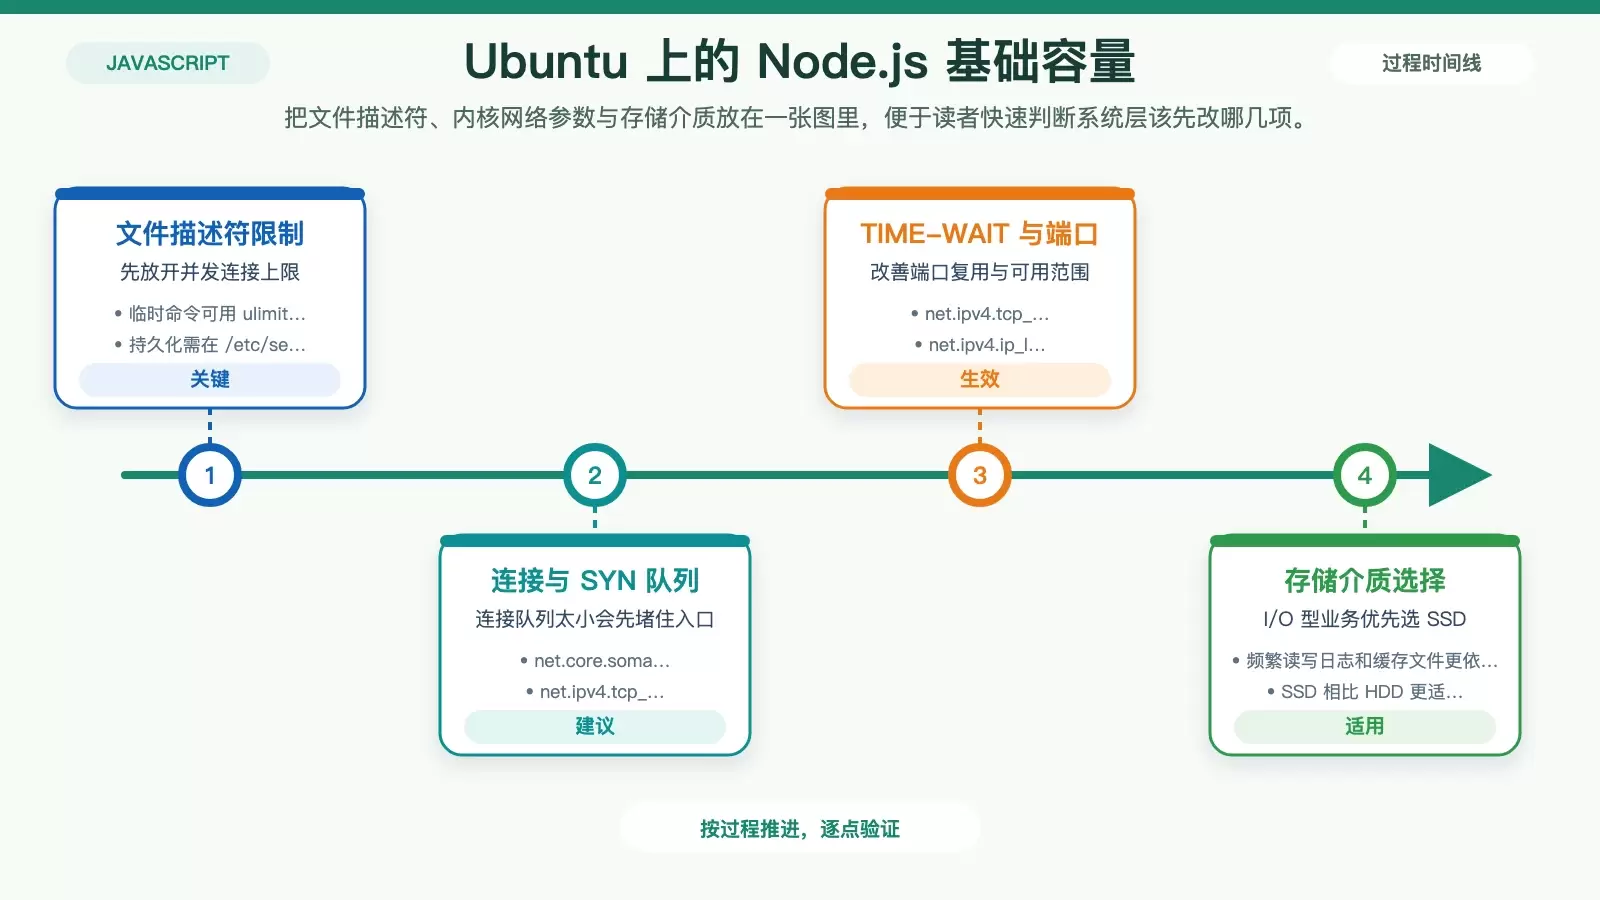
如果底层系统承载能力不足,Node.js 应用即使代码写得规整,也会在高并发下先撞上系统瓶颈。Ubuntu 上至少要先看文件描述符、内核网络参数和存储介质。
先提高文件描述符限制
Node.js 在高并发场景下需要同时打开大量文件和网络连接,文件描述符不够时,应用很容易直接报错或挂掉。
临时调整可以使用:
ulimit -n 65535如果希望重启后仍然生效,更适合直接修改 /etc/security/limits.conf,加入下面两行:
* soft nofile 65535
* hard nofile 65535
这一项本质上是在给应用留出并发连接的空间,属于高负载服务最基础的容量设置。
再调整内核网络参数
仅仅放开文件描述符还不够,内核默认网络队列和端口范围也可能过小。编辑 /etc/sysctl.conf,加入以下配置:
net.core.somaxconn = 4096
net.ipv4.tcp_max_syn_backlog = 4096
net.ipv4.tcp_tw_reuse = 1
net.ipv4.ip_local_port_range = 1024 65535
其中:
net.core.somaxconn = 4096:提高最大连接队列长度。net.ipv4.tcp_max_syn_backlog = 4096:提高 SYN 队列长度。net.ipv4.tcp_tw_reuse = 1:允许复用 TIME-WAIT 连接。net.ipv4.ip_local_port_range = 1024 65535:扩大可用端口范围。
修改完成后,执行下面的命令立即生效:
sudo sysctl -pI/O 密集型业务优先用 SSD
如果项目会频繁读写日志、缓存文件或其他本地数据,存储介质对响应时间影响非常直接。相比传统 HDD,SSD 的随机读写性能更高,更适合 I/O 密集型 Node.js 服务。
代码层优化,重点是别阻塞事件循环
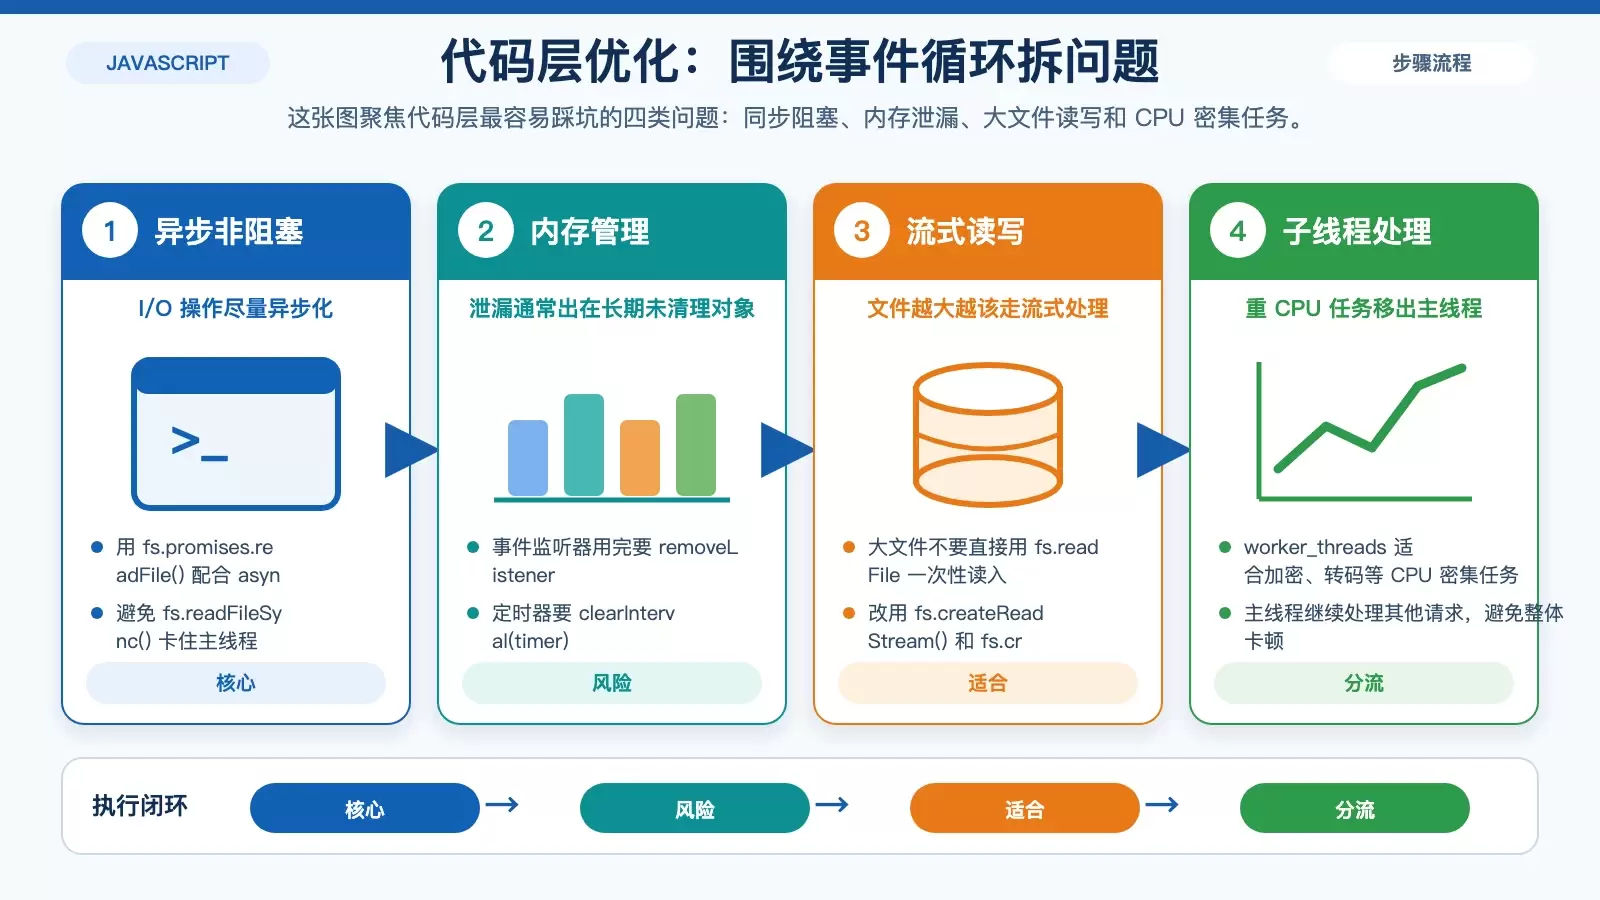
系统容量补齐之后,真正决定 Node.js 表现的,还是代码是否遵守异步非阻塞的运行方式,以及是否控制住内存与大文件处理成本。
所有 I/O 尽量改成异步接口
Node.js 的核心优势就是异步非阻塞。数据库查询、文件读写这类 I/O 操作,应优先使用异步接口。
例如,用 fs.promises.readFile() 配合 async/await,替代 fs.readFileSync()。同步调用一旦阻塞主线程,整个应用都会停下来,高并发时影响会被放大。
内存泄漏问题要提前堵住
很多 Node.js 服务不是瞬间崩,而是跑一段时间后越来越慢,最后被内存占满。常见风险点主要有几类:
- 事件监听器用完后要及时移除,例如
emitter.removeListener('event', handler)。 - 定时器执行完要清理,
clearInterval(timer)不能遗漏。 - 全局变量要慎用,优先使用
let/const替代var。
此外,数据结构也会影响内存占用和查找效率。快速查找场景更适合 Map,去重场景更适合 Set,通常比数组或普通对象更省资源。
大文件处理不要一次性读入内存
处理日志、视频等大文件时,直接用 fs.readFile 一次性加载到内存,往往会把进程内存迅速顶高。更稳妥的方式是使用流式处理:
fs.createReadStream()
fs.createWriteStream()
流式读写按块处理数据,内存占用更可控,也更符合 Node.js 的运行模型。
CPU 密集型任务交给 worker_threads
Node.js 擅长 I/O,但不适合把长时间占用 CPU 的任务压在主线程上。像大文件加密、视频转码这类任务,会直接阻塞事件循环。更合适的做法是使用 worker_threads:
const { Worker } = require('worker_threads');
const worker = new Worker('./cpu-intensive-task.js');
worker.on('message', (result) => console.log('Task result:', result));
这样主线程还能继续接收和处理请求,不会因为单个重任务把整体吞吐拖慢。
想吃满多核,进程管理不能缺
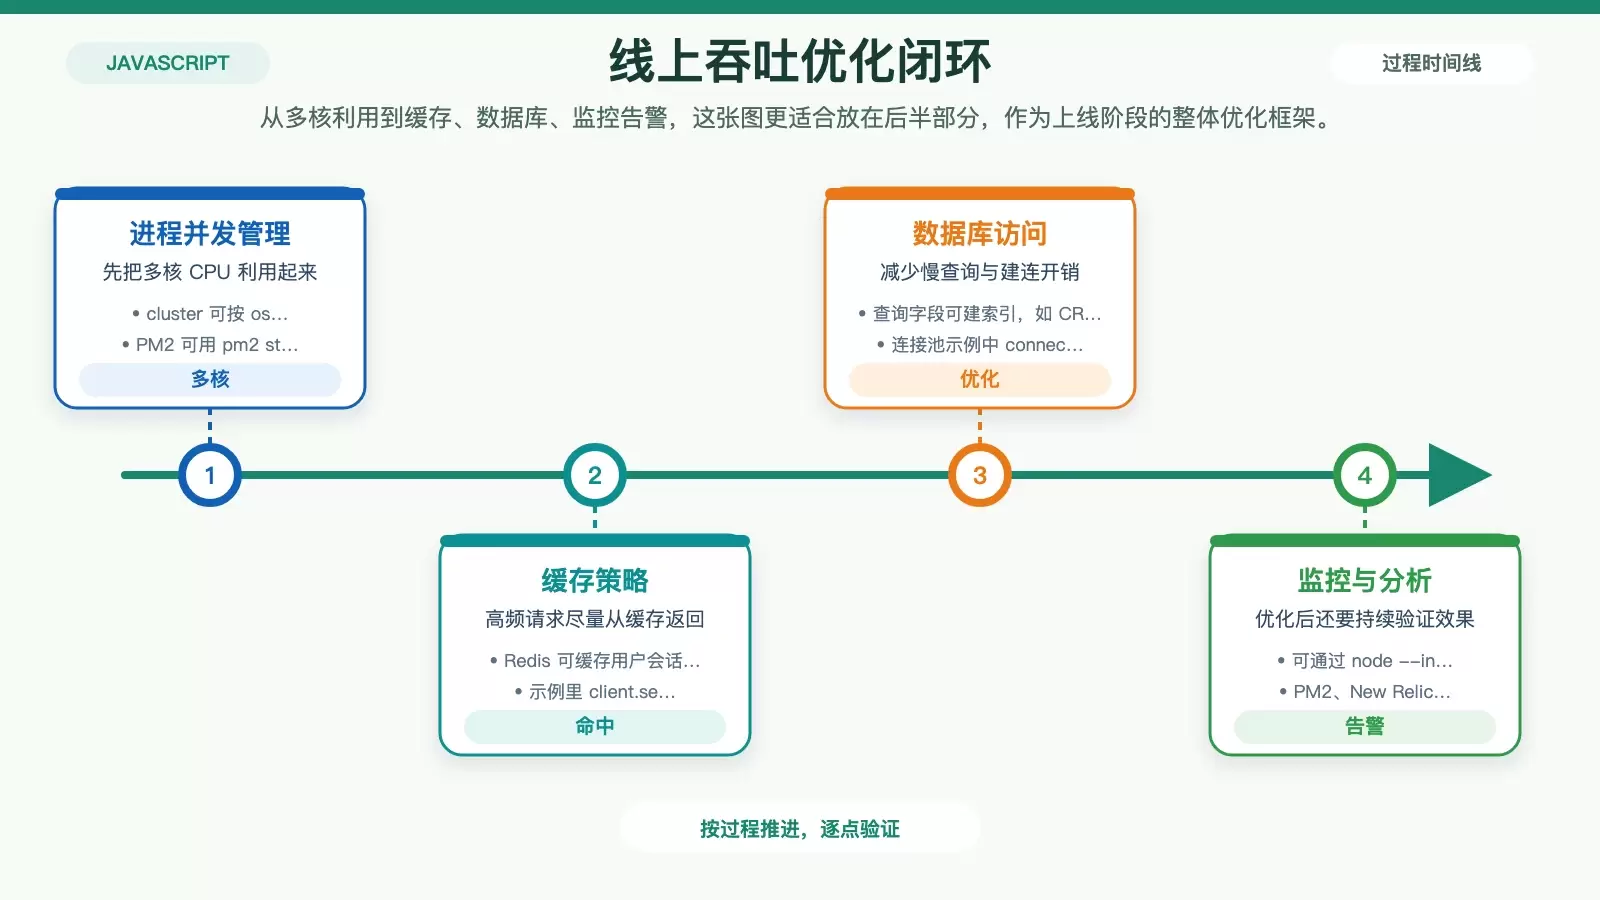
Node.js 本身是单线程事件循环模型,但线上服务器通常是多核 CPU。想把硬件资源真正利用起来,需要在进程层面做扩展。
用 cluster 把工作进程铺到多核上
cluster 模块可以按 CPU 核心数创建多个工作进程,并共享同一个端口,从而提升并发处理能力。示例代码如下:
const cluster = require('cluster');
const os = require('os');
if (cluster.isMaster) {
  for (let i = 0; i < os.cpus().length; i++) cluster.fork();
  cluster.on('exit', (worker) => console.log(`Worker ${worker.process.pid} died`));
} else {
  require('./app.js'); // 启动应用
}
这类方式适合需要直接利用多核、并且部署结构相对可控的服务。
生产环境更常见的是 PM2
如果希望同时解决进程守护、日志管理和负载均衡,PM2 更适合作为生产环境入口。它可以在进程崩溃后自动重启,也能按 CPU 核心数拉起多个实例。
常见启动方式:
pm2 start app.js -i max其中 -i max 会自动根据 CPU 核心数启动对应数量的进程,部署上比手写管理逻辑更省事。
缓存和数据库访问,往往决定实际吞吐
很多线上项目的慢,不在 Node.js 本身,而在于后端数据访问链路过长。缓存命中率、SQL 写法和连接复用方式,通常比单纯调语言参数更影响整体性能。
高频数据适合交给 Redis 或 Memcached
用户会话、热点内容、查询结果这类高频访问数据,适合放到 Redis 或 Memcached 中,避免每次都打到数据库。以 Redis 缓存用户信息为例:
const redis = require('redis');
const client = redis.createClient();
app.get('/user/:id', async (req, res) => {
  const userId = req.params.id;
  const cachedUser = await client.get(`user:${userId}`);
  if (cachedUser) return res.json(JSON.parse(cachedUser));
  const user = await db.getUserById(userId);
  client.setex(`user:${userId}`, 3600, JSON.stringify(user)); // 缓存1小时
  res.json(user);
});
这里的关键不是“用了缓存”这么简单,而是把最常见、最重复的请求从数据库路径上移开。
静态资源记得启用浏览器缓存
HTML、CSS、JS、图片等静态资源,可以通过设置 Cache-Control: max-age=3600 或 Expires 让浏览器直接缓存。这样既能减少服务器压力,也能缩短页面重复访问时的加载时间。
数据库查询要优先做索引和批量操作
数据库是最常见的性能瓶颈之一。对于高频查询字段,应当建立索引,例如:
CREATE INDEX idx_user_email ON users(email)写入场景则尽量使用批量操作,像 INSERT INTO table VALUES (, ), (, ) 这种方式,通常会比多次单条插入更有效,能显著减少数据库交互次数。
连接池能减少反复建连的开销
数据库连接创建和销毁成本都不低。使用连接池可以复用已有连接,降低请求处理时的额外消耗。示例:
const mysql = require('mysql2/promise');
const pool = mysql.createPool({ host: 'localhost', user: 'root', database: 'test', waitForConnections: true, connectionLimit: 10, queueLimit: 0 });
app.get('/data', async (req, res) => {
  const [rows] = await pool.query('SELECT * FROM users');
  res.json(rows);
});
在请求量上来之后,连接池通常是数据库访问层的基础配置,而不是可选项。
响应压缩可以直接减少网络传输时间
如果项目基于 Express,可以启用 compression 中间件,通过 app.use(compression()) 对响应数据进行 Gzip 或 Brotli 压缩。对页面和接口返回内容较大的项目来说,这项优化往往能直接改善加载速度。
最后要靠分析与监控验证优化是否有效
性能优化不能只靠经验判断。改完配置和代码之后,还需要工具来确认瓶颈是否真的被解决,以及是否引入了新的问题。
用 Chrome DevTools 看 CPU、内存和事件循环
可以通过 --inspect 启动应用:
node --inspect app.js然后在 Chrome 打开 chrome://inspect,用 DevTools 的 Performance 面板记录 profile,检查 CPU 使用率、内存占用和事件循环延迟,定位慢点到底出现在主线程、I/O 还是脚本执行上。
用堆快照排查内存泄漏
如果怀疑服务存在内存泄漏,可以安装 heapdump:
npm install heapdump然后在代码中生成堆快照:
heapdump.writeSnapshot('./heapdump.heapsnapshot')再通过 Chrome DevTools 的 Memory 面板分析对象引用关系,排查未移除的事件监听器、未清理的缓存等问题。
线上监控要能看到趋势和告警
日常运行中,至少可以先使用 PM2 自带的监控能力:
pm2 monit它可以实时查看 CPU、内存和进程状态。对于更复杂的项目,则可以接入 New Relic、Datadog 这类 APM 工具,建立全链路监控和告警规则,例如 CPU 使用率超过 80% 时自动通知。
落地时建议按瓶颈顺序推进
如果你手里的 Ubuntu Node.js 项目已经出现响应慢、CPU 打满、内存持续上涨或数据库压力过高,处理顺序通常可以从系统容量和同步阻塞问题开始,再进入多进程、缓存和数据库层优化。只有把监控和性能分析工具接进来,后续每一轮优化才有可验证的依据,而不是停留在经验判断上。









