处理 Python 字典时,很多需求其实都集中在同几类操作上:按值排序、按条件筛选、批量改写键或值,以及把分散数据快速聚合。lambda 之所以常被拿来和字典一起使用,原因就在于它能把这些“只用一次的小逻辑”直接写在调用位置,让 sorted()、filter()、map()、max()、reduce() 这类函数更顺手。
但 lambda 也不是越多越好。本文会按实际问题拆开说明:先看它适合解决什么,再看典型代码怎么写,最后给出项目场景和可读性边界,帮助你判断什么时候该用一行表达式,什么时候应该老老实实写成 def。
先搞清楚:lambda 适合解决什么问题
lambda 是 Python 中创建匿名函数的方式,适合定义体积很小、只在当前上下文使用一次的函数。它的基本语法只有一行:
lambda arguments: expression
例如:
square = lambda x: x ** 2
print(square(5))  # 输出: 25
和普通的 def 相比,lambda 的优势不是“功能更强”,而是“就地表达”。当你需要把一个简单规则传给高阶函数时,比如告诉 sorted() 按哪一列排、告诉 filter() 什么数据该保留,lambda 会更紧凑。
不过它也有明显限制:lambda 只能写一个表达式,不能放多行语句,也不适合承载复杂判断。这个边界后面会直接影响代码是否还好读。
为什么字典键值对特别适合配合 lambda
字典本身就是一组键值对数据,因此很多处理动作都会围绕 .items() 展开。先看一个基础示例:
student_scores = {
    "Alice": 88,
    "Bob": 92,
    "Charlie": 76,
    "Diana": 95
}
常见基础操作包括:
- 添加或修改:
student_scores["Eve"] = 85 - 读取值:
print(student_scores["Alice"]) - 遍历键值对:
for name, score in student_scores.items()
这些写法本身没有问题,但一旦需求变成“按值排序”“只保留一部分数据”“统一改写结果”,循环里通常就会塞进额外逻辑。lambda 的作用,就是把这种临时规则直接附着在操作上,减少样板代码。
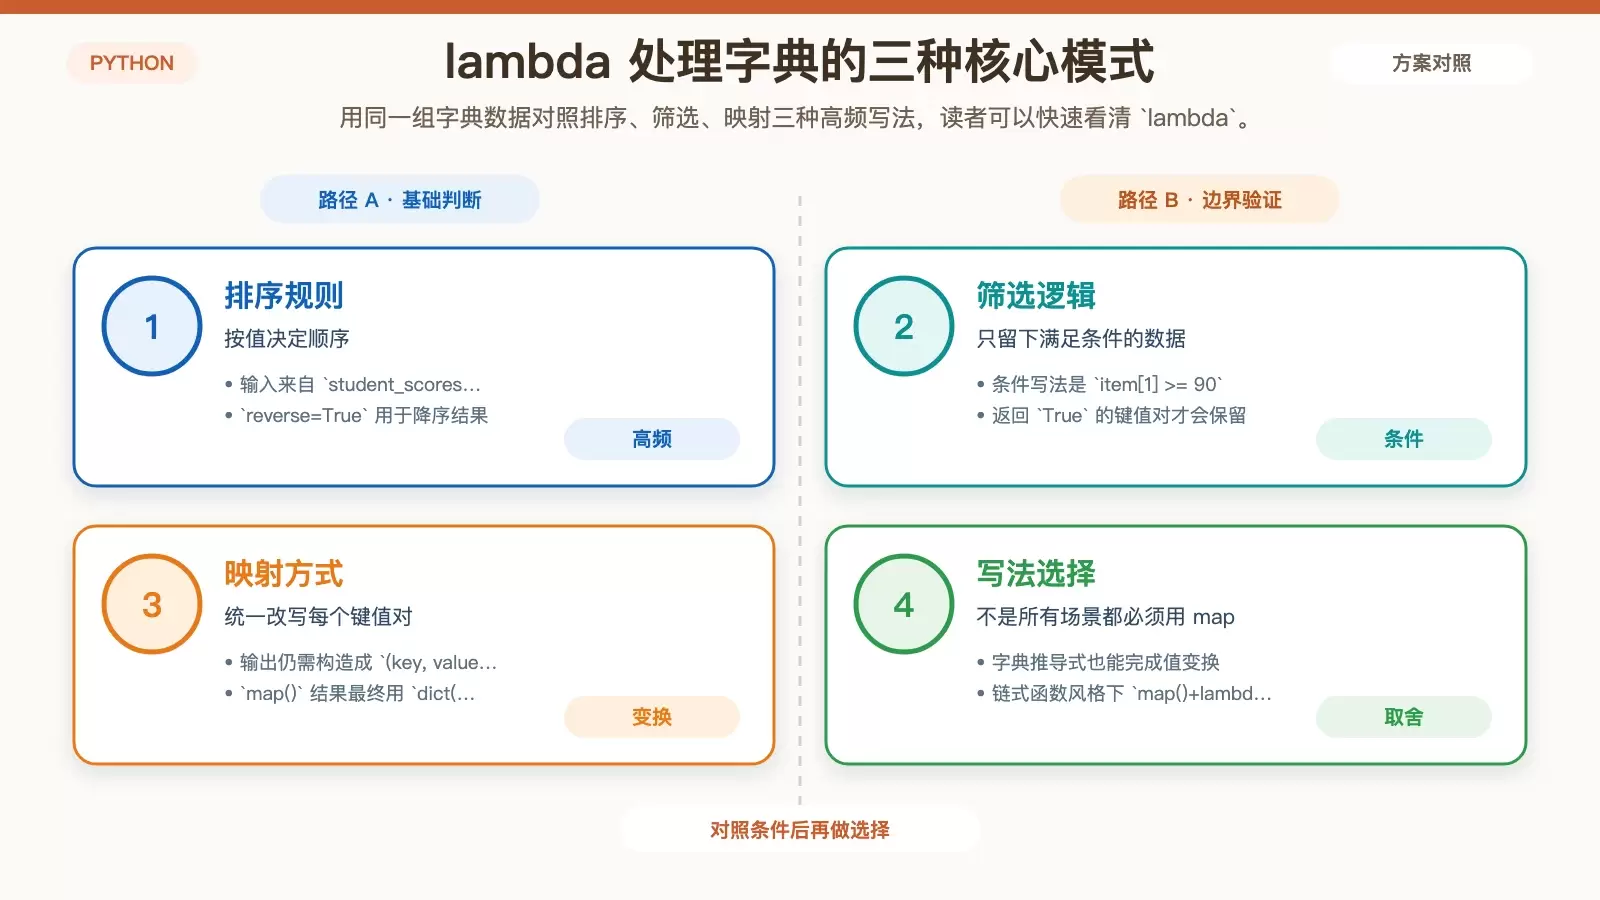
三类最常见写法:排序、筛选、映射
按值排序:最常见也最实用
如果要把学生成绩按分数从高到低排列,可以直接把排序关键字写进 sorted():
student_scores = {
    "Alice": 88,
    "Bob": 92,
    "Charlie": 76,
    "Diana": 95
}

# 使用 lambda 排序:以值为关键字
sorted_by_score = dict(sorted(student_scores.items(), key=lambda item: item[1], reverse=True))
print(sorted_by_score)
# 输出: {'Diana': 95, 'Bob': 92, 'Alice': 88, 'Charlie': 76}
这里最关键的是:
student_scores.items()会得到形如(key, value)的元组序列key=lambda item: item[1]表示按值排序reverse=True表示降序
这类写法几乎可以看作“按字典值排序”的标准模板。
按条件筛选:保留你关心的键值对
如果只想保留成绩大于等于 90 的学生,可以把筛选条件交给 filter():
high_performers = dict(filter(lambda item: item[1] >= 90, student_scores.items()))
print(high_performers)
# 输出: {'Bob': 92, 'Diana': 95}
这里的逻辑也很直接:
filter()接收“判断函数 + 可迭代对象”lambda item: item[1] >= 90用来判断当前键值对是否保留- 返回值为
True的项会留下来
这种写法适合快速表达“保留满足条件的数据”,尤其在规则很短的时候可读性不错。
批量变换:统一改写值或键
如果要把所有分数都加 5,最常见的写法其实是字典推导式:
adjusted_scores = {name: (score + 5) for name, score in student_scores.items()}
print(adjusted_scores)
# 输出: {'Alice': 93, 'Bob': 97, 'Charlie': 81, 'Diana': 100}
但如果你想用函数式写法,也可以用 map() 加 lambda:
# 用 map + lambda 改造
mapped_scores = dict(map(lambda item: (item[0], item[1] + 5), student_scores.items()))
print(mapped_scores)
# 输出: {'Alice': 93, 'Bob': 97, 'Charlie': 81, 'Diana': 100}
这里需要注意两点:
map()返回的是迭代器,所以最后要用dict()转回字典lambda item: (item[0], item[1] + 5)表示输出一个新的(key, value)元组
如果你只是单次简单变换,字典推导通常更直观;如果你在一整套函数式链路里操作,map()+lambda 会更统一。
和内置函数配合时,lambda 常见怎么用
用 map() 只改键,不改值
比如下面这个用户角色字典,希望把所有用户名转成大写:
users = {
    "alice": "admin",
    "bob": "user",
    "charlie": "moderator"
}

uppercase_users = dict(map(lambda item: (item[0].upper(), item[1]), users.items()))
print(uppercase_users)
# 输出: {'ALICE': 'admin', 'BOB': 'user', 'CHARLIE': 'moderator'}
这个例子说明 lambda 不只是改值,也可以只改键,甚至同时改两者。
用 filter() 做动态过滤
如果要找出权限为 "admin" 的用户:
admins = dict(filter(lambda item: item[1] == "admin", users.items()))
print(admins)
# 输出: {'alice': 'admin'}
这种写法在配置筛选、权限过滤、接口返回结果裁剪中都很常见。
用 reduce() 做聚合统计
除了排序和筛选,lambda 也常用于累计结果。比如汇总所有学生分数:
from functools import reduce

total_score = reduce(lambda acc, item: acc + item[1], student_scores.items(), 0)
print(total_score)  # 输出: 351
reduce() 会不断把累计值 acc 和当前项 item 送入表达式中,最终得到一个总结果。对于求和、拼接、累积统计这类需求,它很适合写成一条表达式。
进阶用法:多条件排序与字典方法配合
多条件排序:先按值,再按键
实际项目里,经常不止一个排序条件。比如先按分数降序,再按姓名升序:
student_scores = {
    "Alice": 88,
    "Bob": 92,
    "Charlie": 88,
    "Diana": 95
}

# 先按分数降序,再按姓名升序
sorted_students = dict(sorted(student_scores.items(), key=lambda item: (-item[1], item[0])))
print(sorted_students)
# 输出: {'Diana': 95, 'Bob': 92, 'Alice': 88, 'Charlie': 88}
这里的重点在于,key 可以返回元组:
-item[1]表示分数按降序处理item[0]表示姓名按升序处理- 元组会按位置依次比较,实现多重排序
这比手写复杂比较函数更短,也更符合 Python 常见习惯。
和 get() 配合时要注意调用方式
原文里还给出一个“默认值 + lambda”的例子:
data = {"a": 1, "b": 2}

# 如果键不存在,返回 0;否则返回当前值的两倍
result = data.get("c", lambda: 0)()
print(result)  # 输出: 0
这段代码要特别看清一点:默认值传入的是函数对象,所以后面又补了一个 () 才真正执行。它能工作,但对于简单默认值场景并不算最自然的写法。
因此,这类模式更适合“默认值本身需要延迟执行逻辑”的情况;如果只是想取不到时返回 0,直接写普通默认值通常更清楚。
项目示例:日志分析里怎样串起这些写法
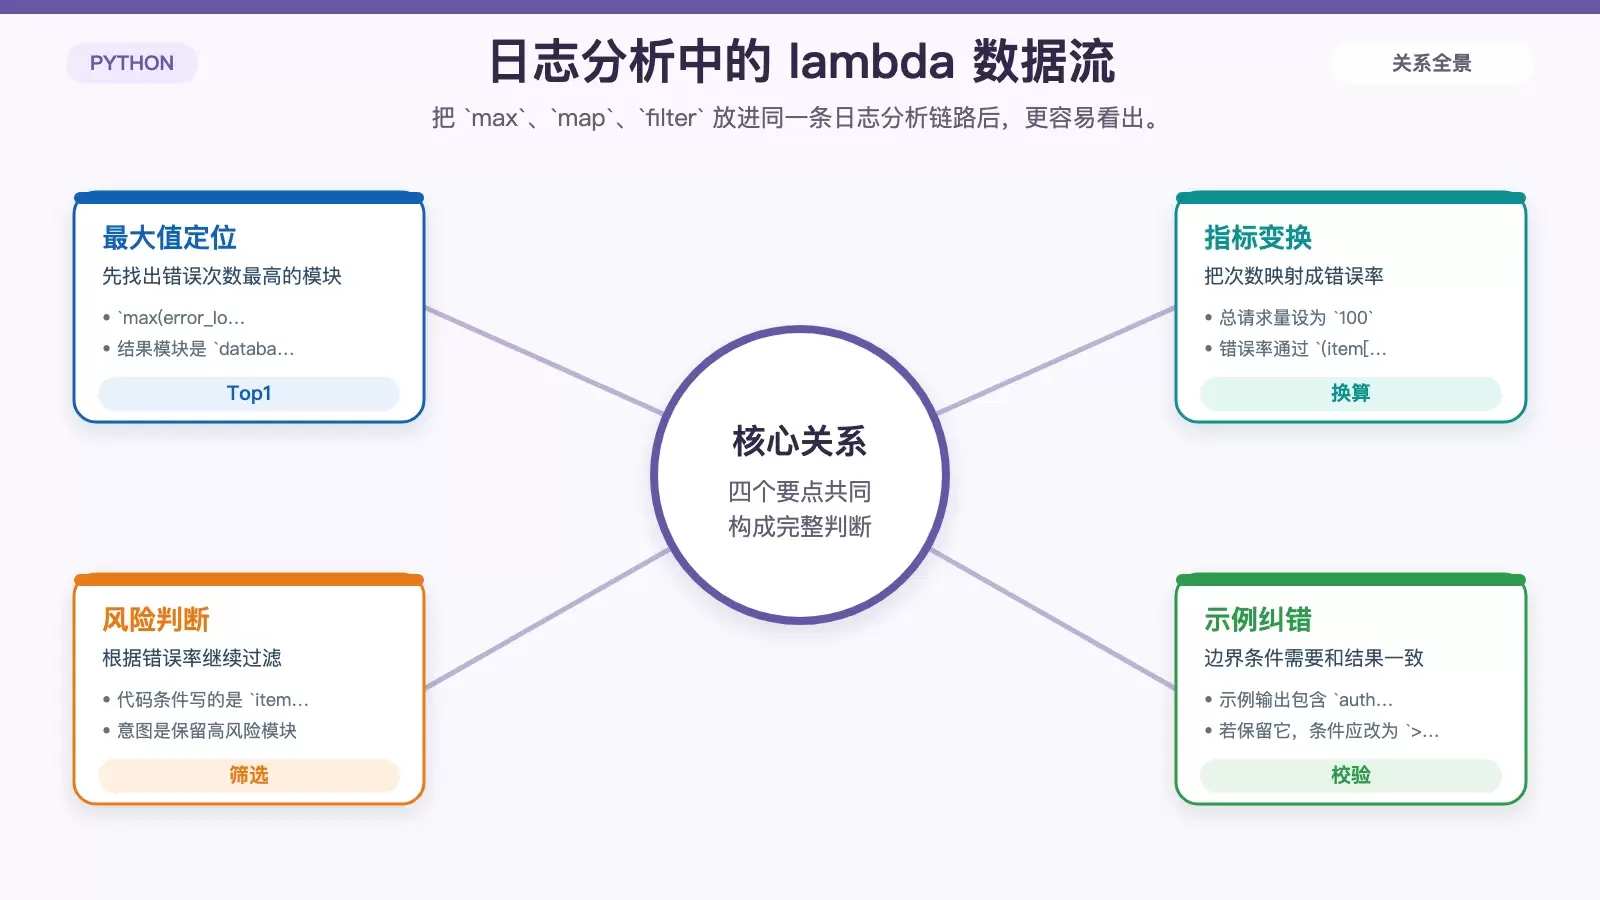
把这些零散技巧放进一个更接近实际业务的场景,会更容易判断它们的价值。假设你在开发一个日志分析系统,字典里保存的是各模块错误次数:
error_logs = {
    "auth": 5,
    "database": 12,
    "cache": 3,
    "api": 8
}
1. 找出错误最多的模块
most_errors = max(error_logs.items(), key=lambda item: item[1])
print(f"最频繁出错模块: {most_errors[0]} ({most_errors[1]} 次)")
# 输出: 最频繁出错模块: database (12 次)
这里和排序思路一样,仍然是通过 key=lambda item: item[1] 指定“比较的是值”。
2. 把错误次数换算成错误率
total_requests = 100
error_rates = dict(map(lambda item: (item[0], (item[1] / total_requests) * 100), error_logs.items()))
print(error_rates)
# 输出: {'auth': 5.0, 'database': 12.0, 'cache': 3.0, 'api': 8.0}
这一步本质是把原始值整体映射成新指标,适合用 map()+lambda 或字典推导式完成。
3. 筛出高风险模块
high_risk = dict(filter(lambda item: item[1] > 5, error_rates.items()))
print(high_risk)
# 输出: {'auth': 5.0, 'database': 12.0, 'api': 8.0}
按照代码里的条件 item[1] > 5,理论上会保留错误率大于 5 的模块;但给出的输出里包含了 'auth': 5.0。如果严格按这段代码执行,5.0 并不会满足 > 5,这里存在示例结果与条件不一致的问题。
更合理的两种写法是二选一:
- 如果要保留
5.0,条件应写成item[1] >= 5 - 如果坚持
> 5,输出里就不应包含auth
这也提醒了一点:lambda 虽然短,但条件边界更需要写清楚,否则一眼扫过去很容易忽略细节。
什么时候该用 lambda,什么时候该换成 def
可读性是第一条边界
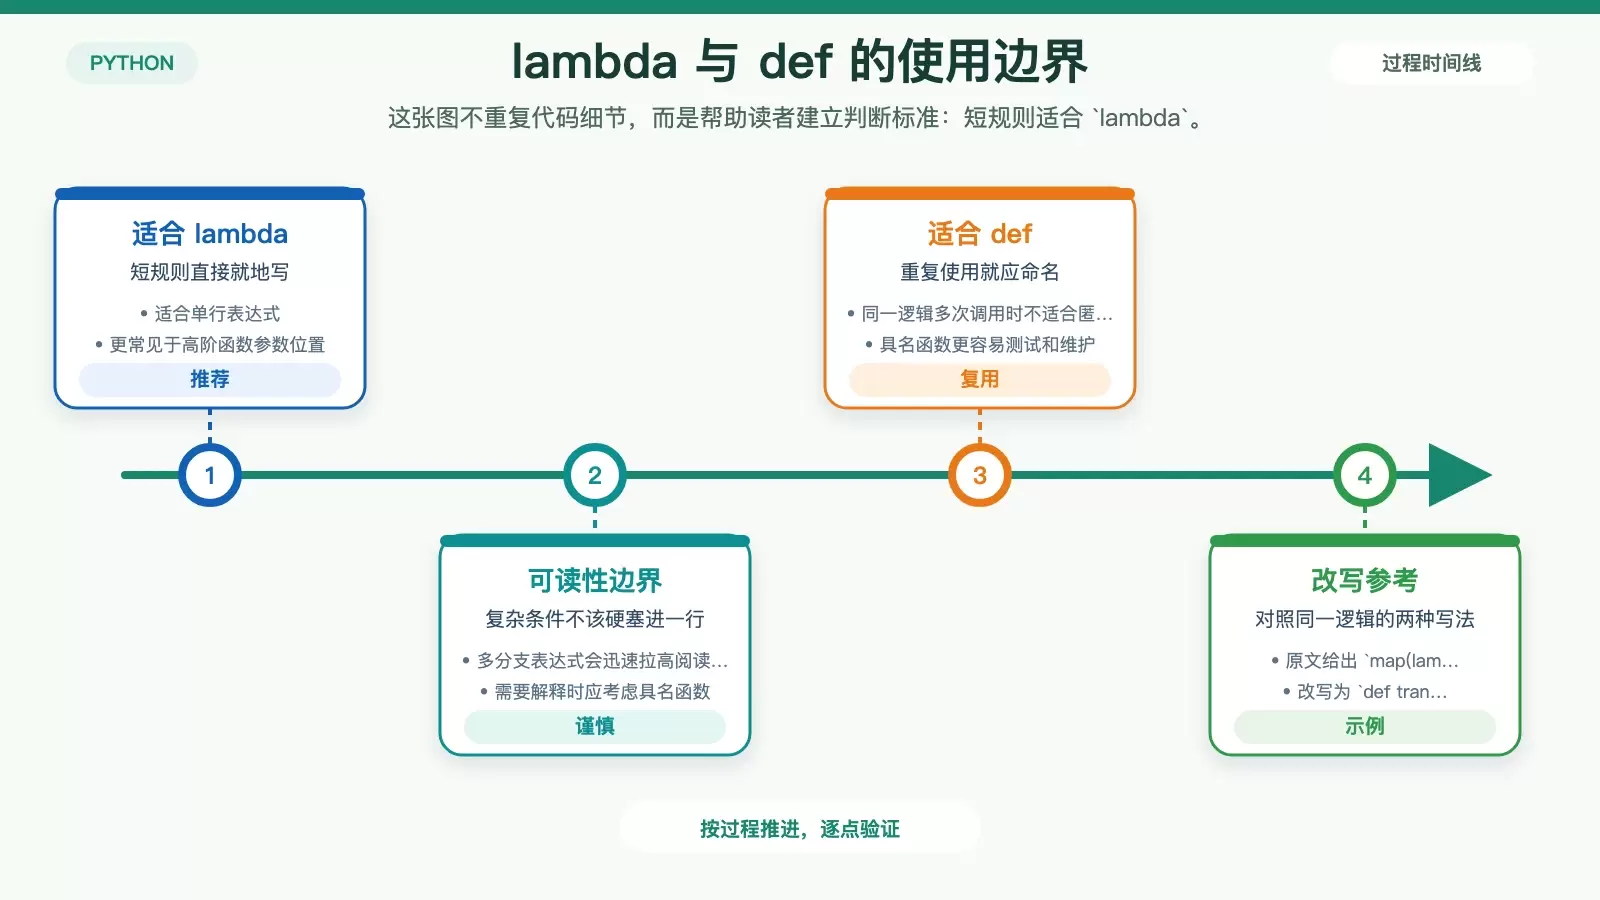
lambda 最容易出现的问题,不是写不出来,而是写得太满。比如下面这种表达式虽然合法,但阅读成本已经明显上升:
#  避免这种写法
result = list(map(lambda x: x*2 if x % 2 == 0 else x+1, [1,2,3,4]))

#  更清晰的方式
def transform(x):
    return x * 2 if x % 2 == 0 else x + 1
result = list(map(transform, [1,2,3,4]))
当逻辑需要解释、会被复用、或者已经包含明显分支时,把它提成具名函数通常更稳妥。
一个实用判断标准
| 场景 | 更适合的写法 |
|---|---|
| 单行表达式 | 用 lambda |
| 多行逻辑 | 用 def |
| 会重复使用 | 用 def |
| 只调用一次 | 用 lambda |
换句话说,lambda 的价值在于“短、就地、只用一次”;一旦超出这三个条件,收益通常就会下降。
练手代码:用一组商品数据把三种操作跑一遍
如果你想快速验证本文提到的模式,可以直接运行下面这段代码:
products = {
    "laptop": 1200,
    "mouse": 25,
    "keyboard": 80,
    "monitor": 400
}

# 1. 找出价格 > 100 的商品
expensive = dict(filter(lambda item: item[1] > 100, products.items()))
print("高价商品:", expensive)

# 2. 给所有商品加税 10%
with_tax = dict(map(lambda item: (item[0], item[1] * 1.1), products.items()))
print("含税价格:", with_tax)

# 3. 按价格排序(降序)
sorted_products = dict(sorted(products.items(), key=lambda item: item[1], reverse=True))
print("按价格排序:", sorted_products)
这段示例把过滤、映射、排序放在同一组数据上,最适合用来建立直觉。你也可以把其中的 lambda 全部替换成 def,直接比较两种风格在长度和可读性上的差别。
结论:把 lambda 用在短规则上,字典处理会顺很多
回到开头的问题,lambda 在字典处理中的核心价值,并不是“能替代所有循环”,而是把那些一次性的判断、取值和变换规则,贴近数据操作本身写出来。
在本文这些场景里,你可以把它概括成几条高频模式:
- 排序:
key=lambda item: item[1] - 过滤:
filter(lambda item: ...) - 映射:
map(lambda item: ...) - 聚合:
reduce(lambda acc, item: ...) - 多条件排序:
key=lambda item: (-item[1], item[0])
真正实用的判断标准只有一个:当 lambda 让意图更直接时就用它;当它开始隐藏逻辑时,就改写成具名函数。