很多团队在做订单、库存、账单这类表设计时,第一反应都是用触发器把主表和明细表“自动同步”起来。问题在于,这种写法只在低频、单点、几乎没有并发的场景里看起来有效,一旦进入真实业务流量,触发器的限制、隔离语义和执行时机都会把问题放大。
这篇文章把几个最容易踩坑的点拆开说明:先看 MySQL 5.7+ 对触发器能做什么、不能做什么,再看跨表同步为什么容易失真,最后给出两类能落地的一致性方案,方便你判断当前业务到底该用应用层事务,还是改成异步队列。
为什么不能靠触发器保证主从表一致
先说结论:不能靠触发器保证主表与明细表数据一致。它最多只能在单点、低频、无并发写入的情况下,表现出“好像能自动同步”的效果;一旦写入路径变多、请求量上来,问题就会集中暴露。
原因并不复杂。触发器不是一致性协调者,它没有能力替代完整的业务事务设计。所谓把同步逻辑塞进数据库,本质上只是把风险从应用层挪到了数据库层,并没有消除风险。
MySQL 5.7+ 下,安全写法只剩 BEFORE UPDATE 修改 NEW
MySQL 5.7+ 明确限制:在触发器内部,禁止对触发它的那张表再次执行 UPDATE、INSERT 或 DELETE。因此,很多看上去“顺手”的写法,实际上会直接报错。

例如,你在 orders 表上建了一个 AFTER UPDATE 触发器,里面再写:
UPDATE orders SET status = 'done'这会直接触发 ERROR 1442。
哪些操作是合法的
真正安全、合规的写法,通常只有一种:在 BEFORE UPDATE 里修改即将写入的当前行字段,也就是给 NEW 赋值,例如:
- 给
NEW.status赋值 - 给
NEW.updated_at赋值
这种方式影响的是“即将写入的那一行”,不属于再次操作原表,因此是允许的。
哪些写法一定不要用
下面这种写法即便加了条件,也仍然是非法的:
UPDATE orders SET counter = counter + 1 WHERE id = NEW.id问题不在于有没有 WHERE,而在于你仍然试图在触发器里再次修改 orders 本身。
同理,如果你想在触发器里统计明细金额,再回写主表:
-- 例如查 order_items 汇总后写回 orders.total_amount这种思路也不适合放进触发器。它会把主表写入链路拖慢,而且在高并发下,统计结果并不可靠。
为什么 AFTER INSERT/UPDATE 跨表同步特别容易出错
很多项目会在 AFTER INSERT 或 AFTER UPDATE 触发器中做跨表同步,比如:

INSERT INTO order_summary
SELECT ... FROM order_items WHERE order_id = NEW.order_id
看上去这很像“写一处,自动同步一处”,但这类逻辑很容易在生产环境里出问题。
1. 子查询和索引问题会直接拖垮写入
如果 order_items 上索引没配好,那么每插入一行数据,都可能触发一次大范围扫描。QPS 一旦上百,主写链路就会明显卡顿。
2. 触发器读到的未必是你以为的最新数据
当明细表存在延迟、并发提交或其他事务尚未完成时,触发器里读到的可能只是旧快照。结果就是:同步逻辑执行了,但生成的汇总数据并不准确。
3. 批量写入会让触发器方案直接失效
像下面这种批量插入:
INSERT INTO orders VALUES (), ()在原文给出的场景里,这类批量写法会默认跳过所有触发器。也就是说,你以为数据库会自动同步,实际生产里它可能根本没有执行。
类似风险还包括 INSERT IGNORE、REPLACE INTO、ORM 的 bulk_create。这些路径一旦进入系统,依赖触发器的同步逻辑就会出现大面积漏执行。
4. 多路径写入时很容易互相覆盖
如果 order_summary 不只是由触发器更新,还会被后台统计任务、管理后台修正脚本或其他业务流程写入,那么触发器更新就可能与这些路径冲突,最终出现覆盖、回滚错位或结果不一致。
真正能落地的两种一致性方案
如果目标是把“主表 + 明细表”这件事做稳,实际可落地的方案只有两类,对应两种业务要求。
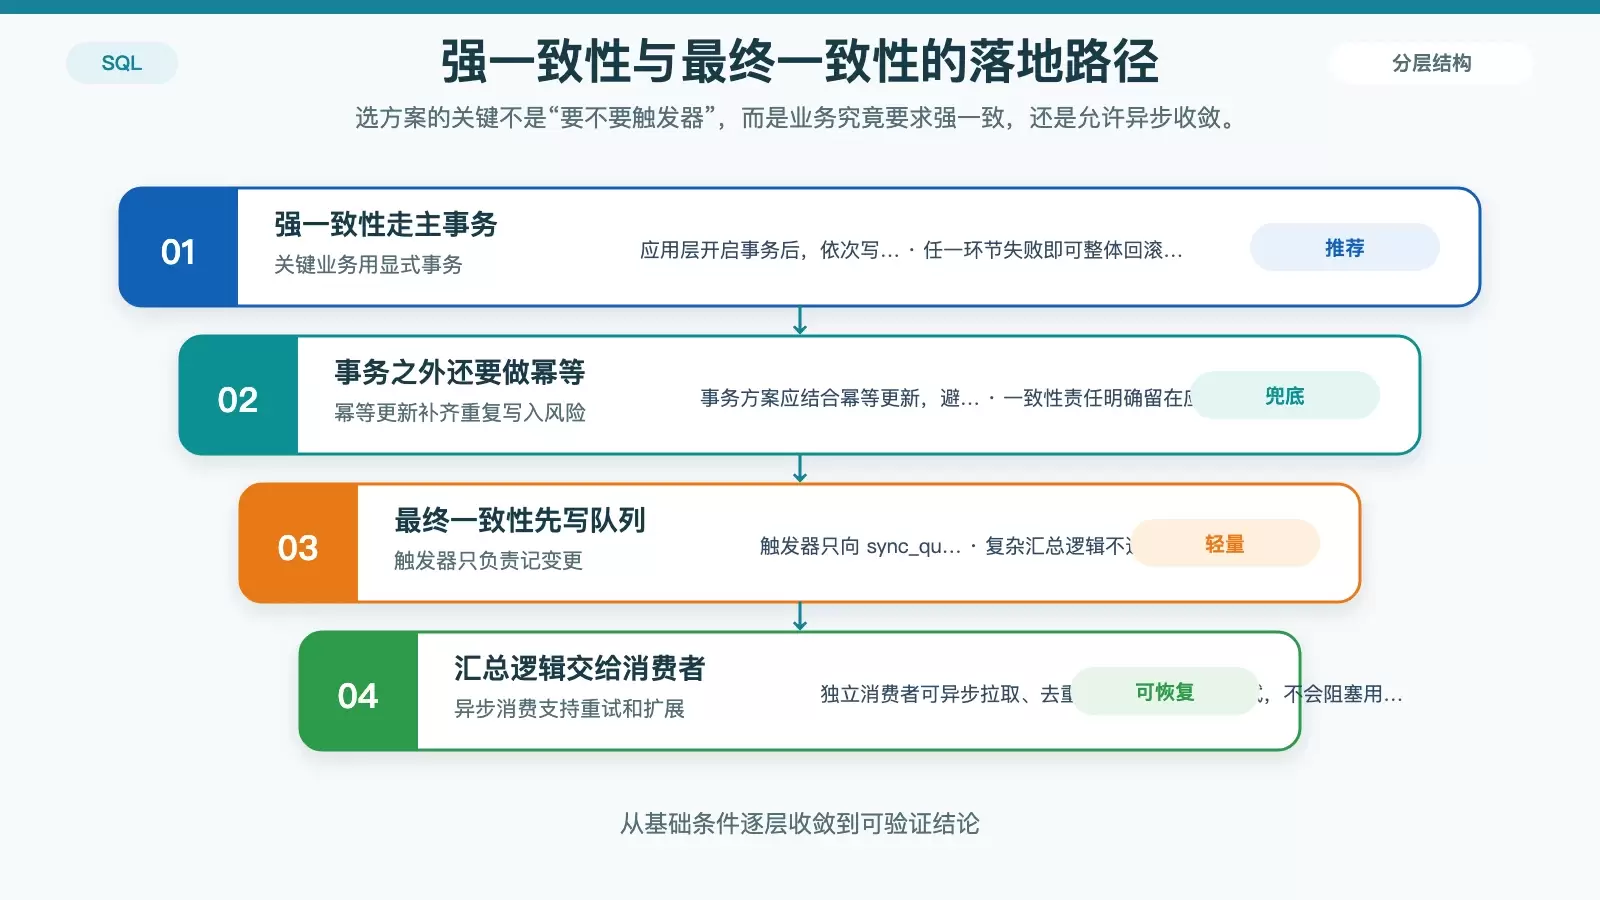
强一致性:应用层显式事务处理主表与明细表
适用于支付订单、扣库存、账务流水这类必须严格一致的场景。做法是把关键步骤都放进同一个业务事务里:
- 应用层开启事务
- 插入
orders - 插入多条
order_items - 更新
orders.total_amount - 统一提交
只要其中任一环节失败,就全部回滚。这样的一致性是显式、可控、可排查的,也更容易配合幂等更新来避免重复写入问题。
最终一致性:触发器只写队列,汇总交给异步消费者
适用于报表汇总、统计看板、非实时分析等场景。这里可以保留触发器,但它只做一件很轻的事:往 sync_queue 表插入变更记录。
后续由独立消费者进程异步拉取这些记录,再完成去重、聚合和写入 order_summary。这样做有几个直接好处:
- 主链路更轻,不会因为统计逻辑阻塞核心写入
- 失败后可以重试
- 同步逻辑可以独立扩容和排错
这才是数据库触发器比较适合承担的角色:记录变更,而不是承担复杂一致性协调。
一个经常被忽略的触发器细节
原文最后提到一个容易被忽视的点:触发器函数返回 NULL 会跳过后续操作,返回 OLD 或 NEW 才会生效;而 MySQL 默认返回 NULL,如果不显式写:
SELECT NEW.*;或:
SET NEW.x = ...;那么整个触发器可能等于没写。
这类细节再次说明,触发器更适合做非常有限、边界清晰的字段修正,而不适合承载跨表同步、金额汇总、状态编排这类重逻辑。
结论
如果你只是想在更新前补齐字段、规范状态,BEFORE UPDATE 里修改 NEW 仍然是可用方案。但只要目标升级为“保证主表和明细表一致”,就不要再把希望寄托在触发器上。
强一致性场景,交给应用层显式事务;最终一致性场景,用队列表达变更、让异步消费者完成汇总。这样设计,才符合 MySQL 5.7+ 的限制,也更能承受真实生产流量。









