很多人在调 Oracle 19c 的 JOIN 性能时,第一反应是“把小表写前面”或“直接用 hint 指定驱动表”,但真正决定驱动表的并不是书写顺序。CBO 看的是统计信息、索引条件和过滤后的实际行数,hint 只是辅助,前提仍然是执行计划有可靠输入。
这篇文章按实际排查顺序展开:先看驱动表到底是怎么被推导出来的,再区分 LEADING 和 ORDERED 该怎么用,最后结合 LEFT JOIN 和执行计划验证,判断一次 JOIN 变慢究竟卡在过滤、索引,还是统计信息本身。
驱动表到底由什么决定
在 Oracle 19c 里,驱动表不是靠人工“选出来”的,而是由 CBO 自动推导。优化器不会看表在 FROM 里的先后顺序,而是按成本做判断,核心公式可以概括为:

outer_table_scan_cost + (outer_table_rows × inner_table_access_cost)真正影响驱动表选择的,主要是下面三件事:
WHERE条件过滤后的行数,且Actual Rows往往比Rows更值得参考- 候选驱动表能不能走索引扫描;如果只能
TABLE ACCESS FULL,成本通常会明显升高 - 被驱动表的连接字段有没有高效索引,是否能形成足够快的等值访问
也就是说,真正起作用的不是“小表优先”这种口号,而是“过滤后谁更小、谁访问代价更低”。
一个常见例子
例如下面这条语句:
SELECT * FROM orders o JOIN customers c ON o.customer_id = c.id WHERE c.status = 'vip'只要 customers.status 上有索引,而且统计信息准确,CBO 很可能把 customers 作为驱动表,即使它在 FROM 子句里排在后面。原因很简单:status = 'vip' 已经把候选数据集压得足够小,后续再去匹配 orders 的成本更低。
为什么 LEADING 通常比 ORDERED 更实用
在需要人工干预连接顺序时,很多人会先想到 /*+ ORDERED */,但在 Oracle 19c 里,/*+ LEADING() */ 往往更灵活,也更接近实际调优需求。

ORDERED 的限制在哪里
/*+ ORDERED */ 会强制数据库按照 FROM 子句的顺序做左深嵌套连接,但它只对 NESTED LOOPS 有效,而且要求左侧表本身已经能通过 WHERE 条件显著缩小结果集。否则即便顺序被强制下来,也未必能得到更低成本的计划。
LEADING 的适用方式
相比之下,/*+ LEADING(customers) */ 指定的是连接树的起点,也就是根节点。后续 JOIN 是继续走 HASH JOIN,还是由优化器在剩余表之间重新安排,仍然有空间。因此它更适合在你已经判断“谁应该先被访问”时使用。
使用 LEADING 时有几个容易踩坑的点:
- 必须配合有效过滤条件,例如
WHERE customers.status = 'vip';如果驱动候选表本身没有足够过滤,LEADING基本只是摆设 - 不能跨 schema 乱写,例如
/*+ LEADING(hr.employees) */在非hr用户下会失效 - 多表 JOIN 时要写全,例如
/*+ LEADING(a b c) */表示a → b → c的连接起点和顺序,不是只指定第一个表
如果执行计划里看到 LEADING 没生效,通常先排查两件事:
DBMS_STATS.GATHER_TABLE_STATS是否已经执行,统计信息是否过期customers.status这样的过滤列是否真的有可用索引
要注意,hint 只能引导优化器,不能创造索引,也不能修复错误或过期的统计信息。
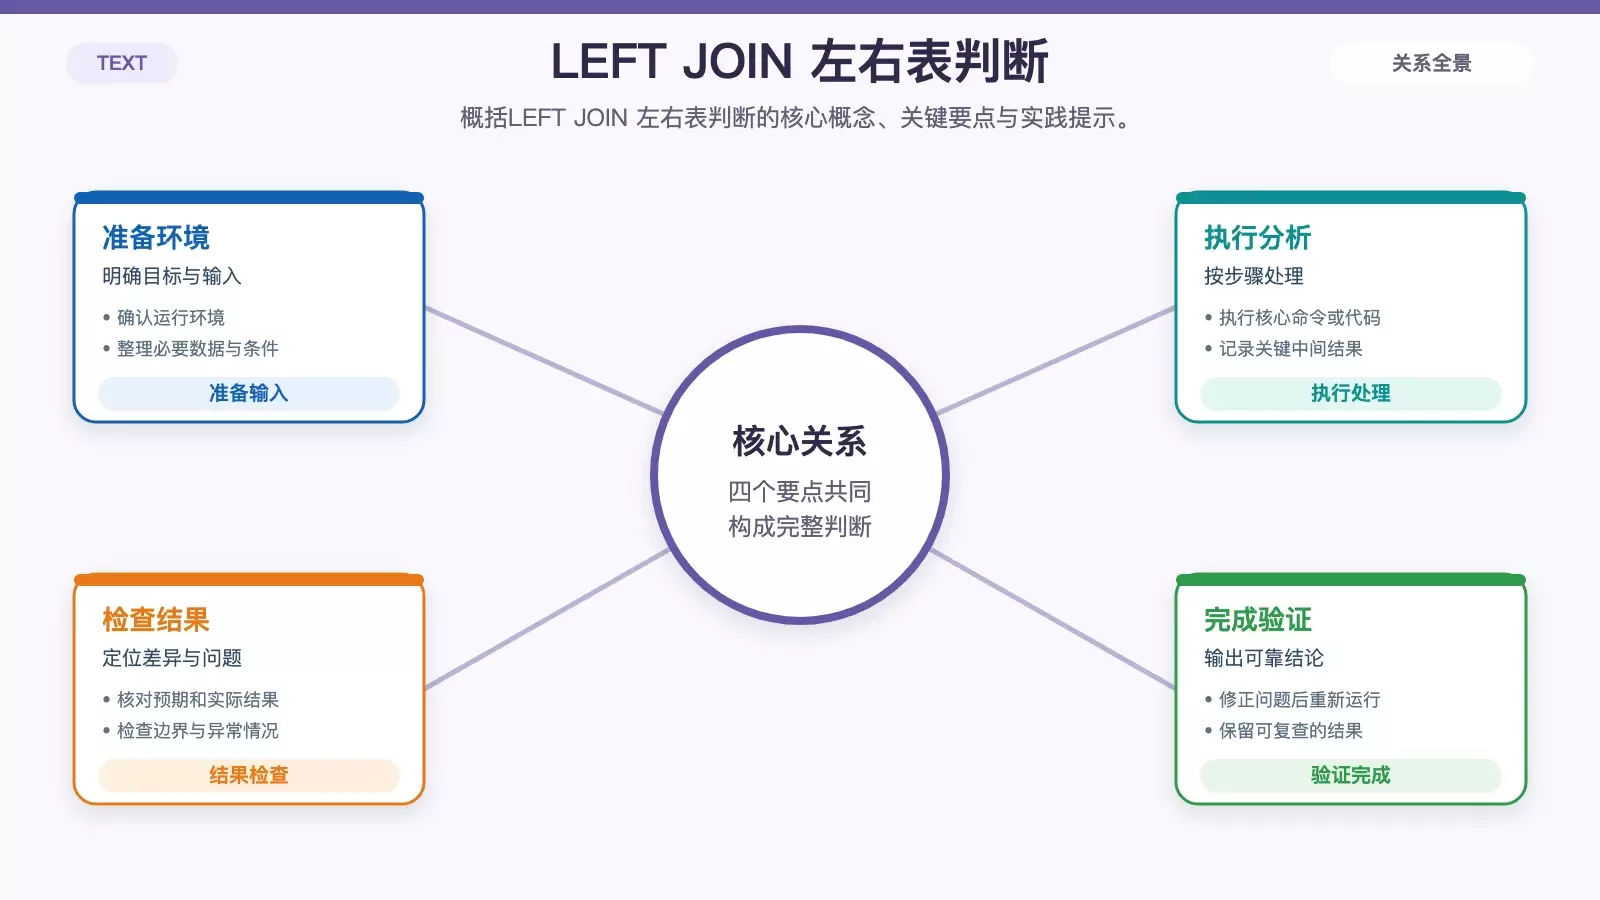
LEFT JOIN 里的驱动表为什么基本不能换
到了 LEFT JOIN 场景,驱动表问题会更“硬”一些。因为从语法语义上看,左表必须被完整保留,所以左表天然就是驱动表,优化器不能随意交换顺序。

例如:
big_table LEFT JOIN small_table ON ...哪怕 small_table 只有 10 行,Oracle 也必须先处理 big_table。这也是很多查询“看起来右表很小,为什么还是慢”的根源。
执行计划里的典型现象
常见表现是:
EXPLAIN里左表出现type=ALL- 右表虽然是
type=ref,整条 SQL 依然慢
问题不在右表访问够不够快,而在左表扫描规模已经决定了整体成本。
两个更实际的处理方向
- 如果业务允许,把
LEFT JOIN改成INNER JOIN,让优化器重新获得选择驱动表的自由 - 如果必须保留
LEFT JOIN语义,就先用子查询过滤左表,例如:
FROM (SELECT * FROM big_table WHERE flag = 1) b LEFT JOIN small_table s ON ...这里的关键点是:只有 WHERE 或子查询过滤,才能真正缩小驱动集。ON 条件不会减少左表扫描量,它只影响关联匹配方式。
怎么从执行计划里确认驱动表选得对不对
看执行计划时,不要只盯着 PLAN_TABLE 的缩进层级,更重要的是把“入口是谁、估算准不准、访问方式对不对”这三件事看清楚。
先看 OPERATION:谁是入口表
通常最顶层、缩进最少的 TABLE ACCESS 操作,就是驱动表入口。这里能直接看出 Oracle 是从哪张表开始发起这次 JOIN 的。
再看 ROWS 和 Actual Rows:统计信息是否可信
如果 ROWS 和 Actual Rows 接近,说明优化器对数据分布的估算基本靠谱;但如果 Actual Rows 比 ROWS 大 10 倍,通常就意味着统计信息已经严重失真,后续驱动表判断也容易跟着偏掉。
最后看谓词位置:是索引访问还是全表过滤
重点看 ACCESS PREDICATES 里是否出现类似 customer_id = :1 这样的等值索引访问。如果条件主要出现在 FILTER PREDICATES,往往说明优化器是在拿到更多数据后再筛选,成本会高得多。
实战里最容易忽略的一种情况是:驱动表自己没有走索引,却希望被驱动表靠索引把整体性能拉回来。这个时候加再多 /*+ LEADING() */ 都救不了,优先级应该是先补索引,或者先更新统计信息。
真正能干预的,不是“选表”,而是优化输入
Oracle 19c 里的 JOIN 驱动表,本质上是 CBO 根据统计信息、索引条件和过滤后行数推导出来的结果。调优时,与其纠结 FROM 子句谁写前谁写后,不如先确认过滤条件是否有效、驱动候选表能否走索引、被驱动表连接列是否具备高效访问路径。
当这些基础条件成立时,LEADING 才有实际价值;而在 LEFT JOIN 这种受语义约束的场景里,真正有效的做法往往是改写 SQL 结构或提前缩小左表数据集。最后再回到执行计划,用 OPERATION、ROWS / Actual Rows 和 ACCESS PREDICATES 交叉验证,才能判断驱动表到底是不是选对了。