在 Ubuntu 上做 Python 并发,很多人第一步都会想到多线程,但真正上手时,常见问题通常不是“线程怎么开”,而是“输出为什么乱了”“共享数据为什么会出错”以及“为什么开了线程性能还是没上去”。这篇文章按实际使用顺序,把 threading 的基本写法、加锁方法和 GIL 带来的限制串起来讲清楚,让你能在写代码前先判断这是不是合适的方案。
用 threading 创建并启动线程
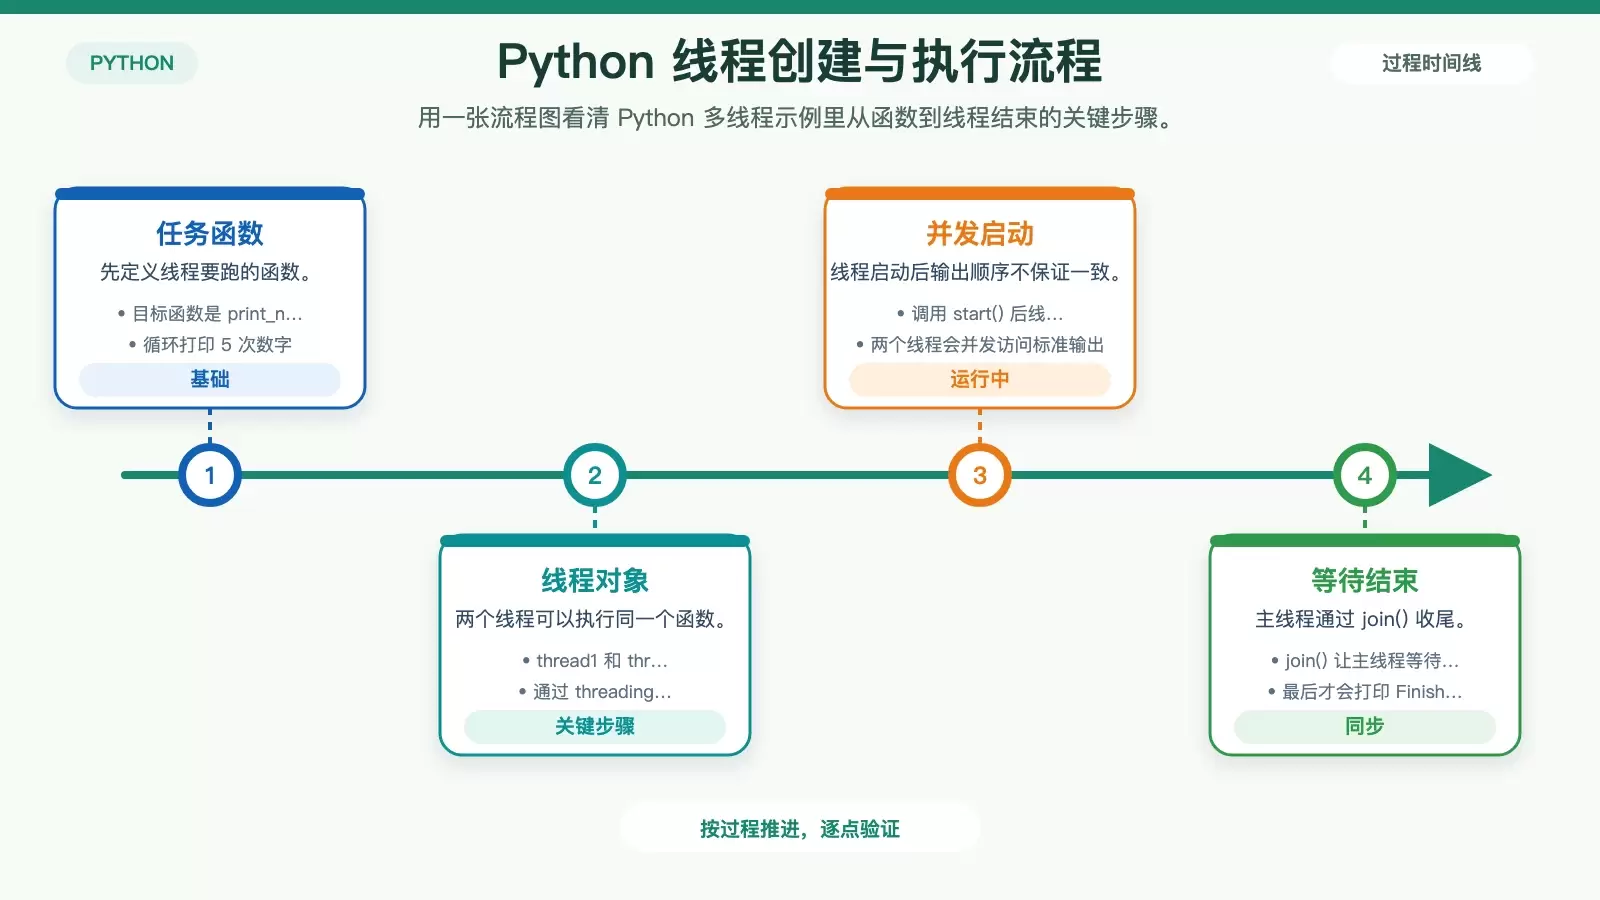
在 Ubuntu 上写 Python 多线程,标准库里的 threading 模块通常就是首选。最基础的用法包括三步:定义线程要执行的函数、创建 Thread 对象、调用 start() 启动线程。
import threading
# 定义一个线程要执行的函数
def print_numbers():
    for i in range(5):
        print(f"Number from thread: {i}")

# 创建线程对象
thread1 = threading.Thread(target=print_numbers)
thread2 = threading.Thread(target=print_numbers)

# 启动线程
thread1.start()
thread2.start()

# 等待所有线程完成
thread1.join()
thread2.join()

print("Finished executing threads")这段代码里,print_numbers 会循环打印 5 次数字;随后创建两个线程,它们都执行同一个目标函数。调用 start() 后,线程进入运行状态;调用 join() 则表示主线程会等待它们执行完毕,再继续往下走。
start() 和 join() 分别做什么
start() 的作用是正式启动线程,真正让线程去执行目标函数;join() 则负责阻塞当前线程,直到对应线程结束。对入门代码来说,这两个调用几乎总是成对出现,否则主线程可能比子线程更早退出,导致结果不完整。
为什么输出顺序可能会交错
需要注意的是,多线程并发执行时,两个线程可能同时访问标准输出,因此打印结果不一定按你肉眼预期的顺序排列。也就是说,代码逻辑没错,输出看起来“乱序”并不一定是程序异常,而是并发执行的正常表现。
多个线程共享数据时,为什么要加锁
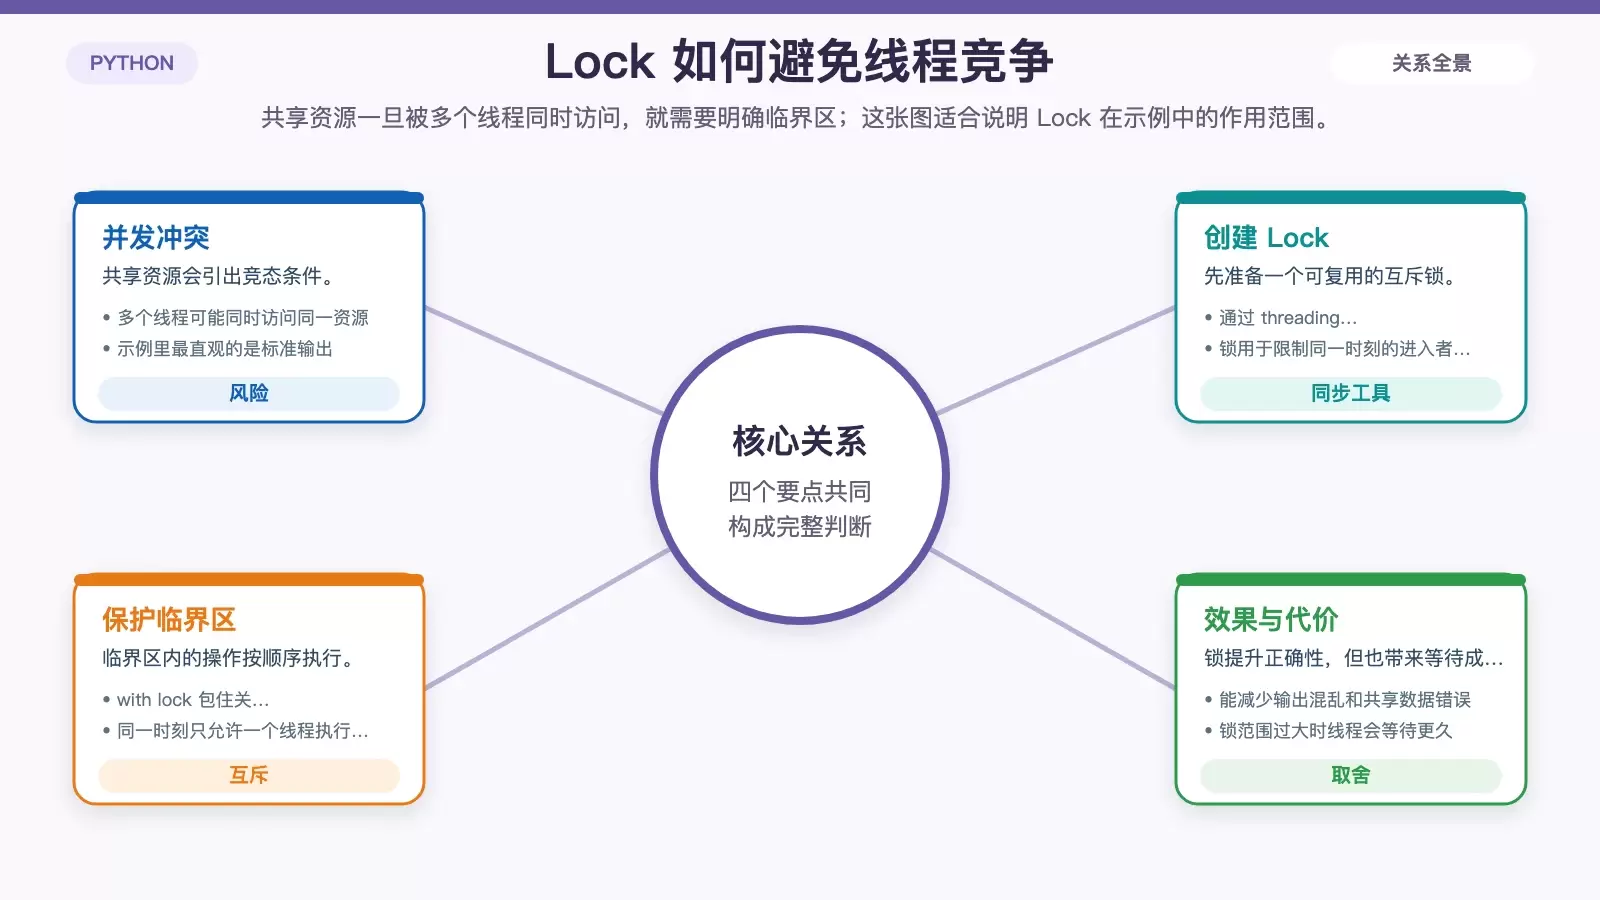
当多个线程只是在各自处理任务时,问题通常还不明显;一旦它们开始共享同一份数据或访问同一个资源,就可能出现竞态条件。为了避免线程互相打断,Python 提供了 Lock 这样的同步工具。
import threading

# 创建一个锁对象
lock = threading.Lock()

# 定义一个线程要执行的函数
def print_numbers_with_lock(thread_name):
    for i in range(5):
        # 获取锁,确保同一时间只有一个线程可以执行这段代码
        with lock:
            print(f"Number from {thread_name}: {i}")

# 创建线程对象
thread1 = threading.Thread(target=print_numbers_with_lock, args=("Thread-1",))
thread2 = threading.Thread(target=print_numbers_with_lock, args=("Thread-2",))

# 启动线程
thread1.start()
thread2.start()

# 等待所有线程完成
thread1.join()
thread2.join()

print("Finished executing threads")
这里先创建了一个 threading.Lock() 对象,然后在关键代码外层使用 with lock。这样一来,同一时刻只会有一个线程进入这段打印逻辑,另一个线程需要等锁释放后才能继续执行。
with lock 的实际效果
with lock 的意义不只是“写法更简洁”,更重要的是它明确划定了临界区。凡是放进这段代码块中的操作,都会在互斥条件下执行,适合保护共享变量、文件写入、日志输出等容易互相影响的资源。
加锁能解决什么,不能解决什么
加锁可以减少多个线程同时操作同一资源导致的数据混乱,但它并不会让程序天然变快。锁本身会带来等待成本,如果临界区写得过大,线程之间反而会排队严重,程序表现可能更接近串行执行。
GIL 为什么会影响 Python 多线程性能
除了线程同步,Python 多线程还有一个绕不开的话题,就是 GIL,也就是全局解释器锁。它的核心限制是:同一时刻只能有一个线程执行 Python 字节码。
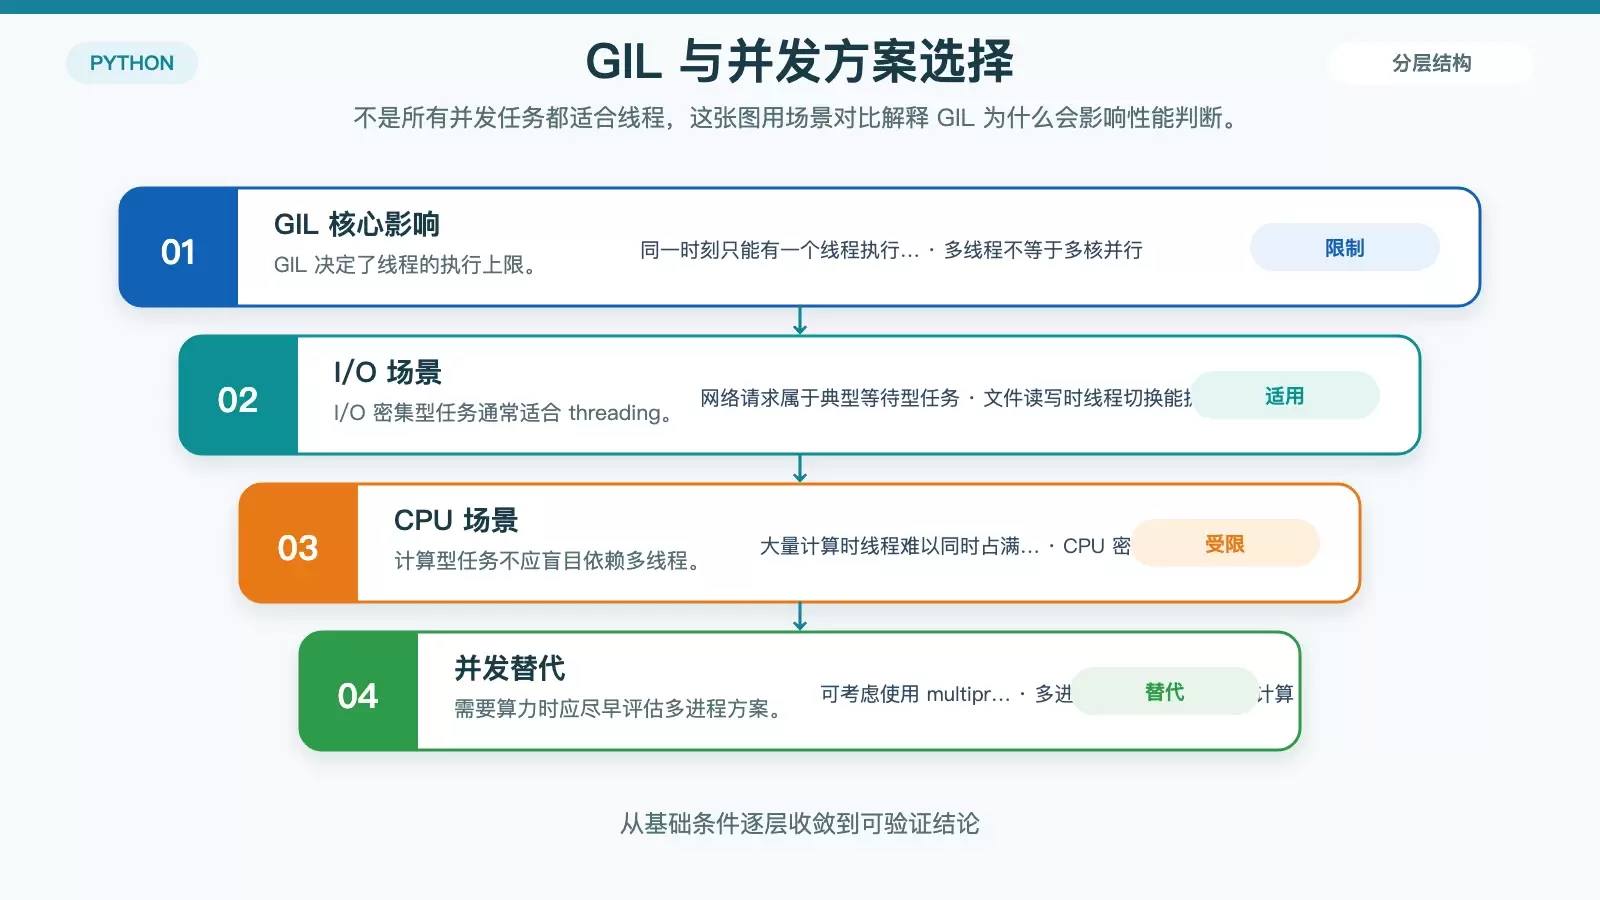
这意味着,多线程并不等于多核并行。对于 I/O 密集型任务,例如网络请求、文件读写、等待外部响应,多线程依然很有用,因为线程可以在等待期间切换执行;但如果是 CPU 密集型任务,多线程往往不能带来预期中的性能提升。
什么时候适合 threading,什么时候该换方案
如果你的任务主要时间花在等待上,比如下载、接口调用、磁盘操作,那么 threading 往往足够直接;如果任务主要是在做大量计算,那么就要谨慎看待多线程收益。这种情况下,更常见的替代方案是 multiprocessing,用多进程来实现真正的并行计算。
写在最后:先判断任务类型,再决定并发方式
把这几个知识点连起来看,Ubuntu 上的 Python 多线程并不复杂:会创建线程、会用 start() 和 join() 控制执行流程,只是第一步;真正决定代码是否稳定、是否有效的,是你有没有处理共享资源,以及有没有正确理解 GIL 的限制。
如果只是想快速把并发任务跑起来,threading 已经足够实用;如果你追求的是 CPU 计算性能,就应该尽早评估 multiprocessing 是否更合适。









