在 SQL 里,COUNT(*) 和 COUNT(字段) 看起来只差一个参数,实际统计口径却完全不同。很多线上报表偏差、关联后计数异常,往往不是数据库算错了,而是把 NULL、连接结果和聚合阶段混在了一起。
这篇文章把几个最常见的误判场景拆开说:先明确两种写法各自在数什么,再看 LEFT JOIN、WHERE、GROUP BY 为什么会让结果“静默偏掉”,最后补上性能判断时真正该看的点。
为什么 COUNT(字段) 一定小于等于 COUNT(*)
COUNT(*) 统计的是结果集的实际行数,不关心任何列是否为 NULL;COUNT(字段) 则会逐行检查该字段,只统计非 NULL 的值。也就是说,只要某一行满足 字段 IS NULL,这一行就不会计入 COUNT(字段)。

因此,COUNT(字段) 的结果始终小于等于 COUNT(*)。两者的差值,正好就是该字段在当前结果集中的 NULL 数量,这属于 SQL 标准行为,不是程序异常。
''(空字符串)、0、false都属于非NULL,会被COUNT(字段)统计进去。- 只有数据库层面真正的
NULL才会被排除。 - 如果
COUNT(id)返回 98,而COUNT(*)返回 100,就说明当前结果集中有 2 行的id为NULL。
判断某列到底有多少个 NULL,最直接的方式就是看这个差值:
COUNT(*) - COUNT(字段)这通常比猜业务逻辑、翻表结构更直接,也更不容易误判。
怎么快速验证某列的 NULL 数量
很多人看到字段名像 id、email、user_id,会先入为主地认为它“不可能是 NULL”。但只要没有真正加上 NOT NULL 约束,或者查询过程中经过了外连接、筛选、表达式转换,就仍然可能出现 NULL。
所以在排查计数异常时,先别急着怀疑数据库函数,优先验证当前结果集中这一列是否真的存在空值:
SELECT COUNT(*) AS total_rows,
       COUNT(id) AS non_null_id_rows,
       COUNT(*) - COUNT(id) AS null_id_rows
FROM your_table;
这类写法的价值在于,它验证的是“当前查询结果”本身,而不是表设计预期。对排查报表口径偏差尤其有用。
LEFT JOIN 后为什么最容易把 COUNT(字段) 用错
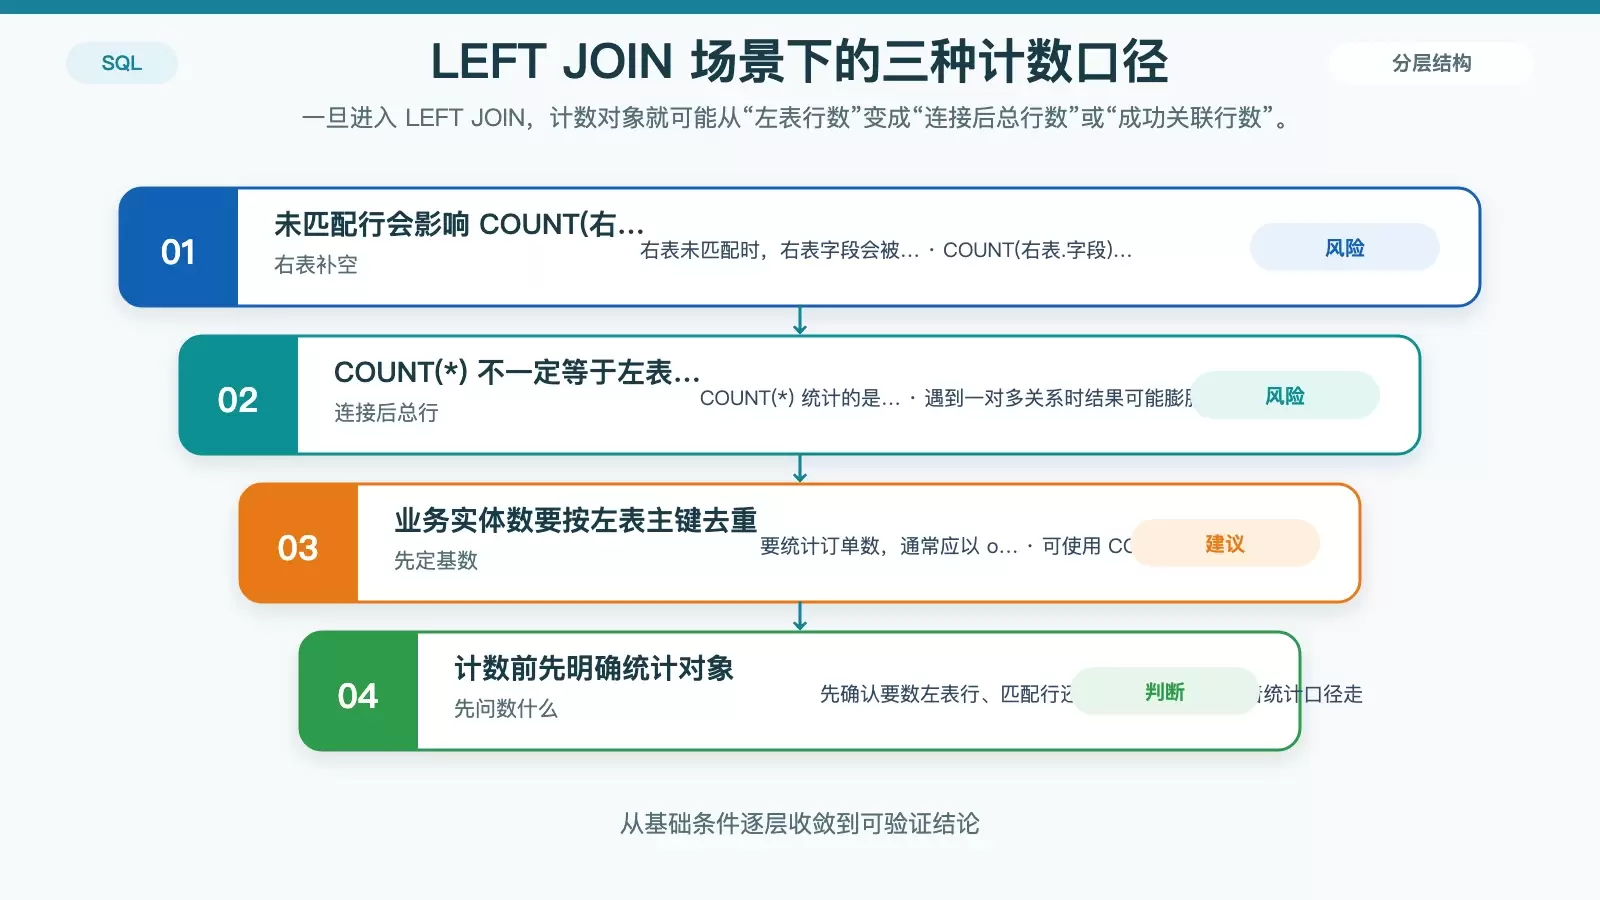
LEFT JOIN 是计数误判最常见的来源之一。原因很简单:当右表没有匹配行时,右表字段会被补成 NULL。这时 COUNT(右表.字段) 统计到的,其实是“成功关联上的行数”,而不是左表原始行数。
例如下面这条语句:
SELECT COUNT(*)
FROM orders
LEFT JOIN users ON orders.user_id = users.id;
这里的 COUNT(*) 统计的是连接后的总行数。如果一个用户对应多条订单,或者连接关系本身是一对多,结果甚至可能比 orders 原表行数更大。
再看这类写法:
SELECT COUNT(users.id)
FROM orders
LEFT JOIN users ON orders.user_id = users.id;
由于未匹配到的右表字段会变成 NULL,所以 COUNT(users.id) 统计的是“成功匹配到用户的订单行数”。这个值可能明显小于订单总数。
如果你真正想回答的问题是“有多少订单”,更稳妥的写法通常是:
COUNT(DISTINCT orders.id)或者先在子查询里把订单基数固定住,再做后续关联。关键不是把 COUNT(*) 换成 COUNT(字段),而是先明确你到底要数的是左表行、成功关联行,还是去重后的业务实体数。
COUNT(*) 和 COUNT(字段) 的性能差异该怎么理解
COUNT(*) 和 COUNT(字段) 确实可能有性能差异,但很多讨论把它简化成“谁更快”,这往往不准确。真正影响执行成本的,主要是是否需要判空、是否有可用索引,以及优化器最终选择什么访问路径。
- 在没有
WHERE条件时,COUNT(*)在 MySQL InnoDB 8.0+ 中可能走元数据估算或最小索引扫描,开销通常很小。 COUNT(字段)必须确认该列的实际值是否为NULL;如果该列没有索引,通常更容易触发全表扫描。- 即使字段上有索引,只要该列允许
NULL,优化器仍可能需要额外确认索引项对应行是否真实存在,未必能完全避免回表。 COUNT(1)和COUNT(*)在现代数据库里执行计划通常几乎一致,没有必要为了“看起来更快”而刻意替换。
所以,性能判断不要停留在函数字面写法上,而要结合执行计划、索引设计和过滤条件一起看。
为什么 WHERE 和 GROUP BY 之后更容易出现静默偏差
最容易被忽略的一点是:COUNT(字段) 统计的永远是“当前结果集里该字段的非空数量”,不是原始表中这列的总体分布。只要查询里出现了 WHERE、GROUP BY 或连接条件,统计口径就已经变了。

WHERE 先缩小结果集,再做 COUNT
例如:
SELECT COUNT(email)
FROM users
WHERE status = 'active';
这条语句统计的不是“全表有多少用户填了邮箱”,而是“活跃用户中有多少人的 email 非空”。如果把它拿去代表全表邮箱填充率,结论就会直接偏掉。
GROUP BY 之后,每组都按各自的 NULL 分布计数
在分组查询里,COUNT(字段) 会在每一组内部独立计算,只统计该组内的非 NULL 值。它不是对全表统一计数后再分摊,而是每个分组各算各的。
这也是为什么同一列在不同分组下,计数结果可能差异很大:真正变化的不是函数规则,而是每组内 NULL 的分布。
LEFT JOIN 再叠加 WHERE,语义可能已经变了
还有一种很常见的坑是:写了 LEFT JOIN,又在 WHERE 里加右表字段条件,例如:
WHERE users.name IS NOT NULL这样会把原本的外连接效果收紧,结果在语义上更接近内连接。此时 COUNT(users.name) 和 COUNT(*) 可能变得相等,但这不代表两种写法本质一致,而是因为查询结果本身已经被改写了。
实际写 SQL 时怎么避免把计数口径写歪
遇到计数需求时,可以先把问题拆成三个层次:
- 你要统计的是结果集总行数,还是某一列的非空值数量。
- 当前查询是否经过了
LEFT JOIN、WHERE、GROUP BY,导致结果集已经不是原表。 - 你要的到底是行数、成功匹配数,还是某个业务主键的去重数量。
如果这三个问题没有先想清楚,COUNT(*)、COUNT(字段)、COUNT(DISTINCT ...) 很容易写出“能执行、没报错、但口径错了”的 SQL。数据库不会提醒你,只会安静地返回一个看似合理的数字。









