在 Python HTTP 请求场景里,很多人会直接调用 urllib3.PoolManager(),却不清楚它到底替你管了什么,也容易在参数透传、重试和 socket 配置上踩坑。本文按“先理解职责,再看参数,最后处理常见问题和安全配置”的顺序梳理 PoolManager,读完你可以更稳地判断默认行为是否够用,以及哪些选项需要在生产环境里明确设定。
PoolManager 到底负责什么
PoolManager 是 urllib3 提供的高层连接管理器。它最核心的职责,不是简单“发请求”,而是为不同主机自动维护独立的连接池,并在后续请求里尽量复用已有连接。
这意味着你通常不必手动创建 HTTPConnectionPool,也不用自己追踪某个连接该不该复用、什么时候应该关闭。对于大多数业务代码来说,PoolManager 直接把连接管理这一层封装掉了。
import urllib3

http = urllib3.PoolManager()
resp = http.request('GET', 'https://www.baidu.com')
print(resp.status, resp.data.decode('utf-8')[:100])
这段代码表面上只有一次请求,背后实际上已经走完了“按目标主机定位连接池、从池中取连接、请求结束后保留可复用连接”的流程。也正因为如此,PoolManager 在多主机、多请求、长生命周期客户端里价值更明显。
几个关键参数,决定连接池怎么工作
日常使用里,最值得优先关注的是 num_pools、maxsize、timeout、block、retries 和 headers。这些选项直接决定连接池缓存规模、单池并发能力以及请求失败时的行为。
| 参数 | 含义 | 默认值 | 建议 |
|---|---|---|---|
| num_pools | 缓存的连接池数量,超过后丢弃最久未用的 | 10 | 多主机场景设 50~100 |
| maxsize | 每个池的最大连接数 | 100 | 根据并发量调整,50~200 常见 |
| timeout | 请求超时时间(秒) | 无超时 | 必须设,建议 3~10 |
| block | 池满时是否阻塞等待 | False | 高并发建议 True |
| retries | 重试策略 | Retry(3) | 网络不稳时保留,否则设 False |
| headers | 全局请求头 | None | 统一 UA、Token 等 |
其中有几个判断尤其重要:
为什么要先看 num_pools
num_pools 决定的是“最多缓存多少个不同主机对应的连接池”,不是总连接数。目标站点很多时,这个值太小会导致连接池频繁被回收,再访问老主机时又要重新创建,复用效果就会打折。
maxsize 和 block 要一起看
maxsize 是单个连接池可持有的最大连接数,block 则决定池满后怎么处理。高并发下如果仍用 block=False,更容易出现额外连接创建或行为超出预期;如果追求稳定的连接上限,通常会把 block 设为 True。
timeout 不要留空
默认“无超时”在生产里风险很高。只要下游接口卡住,请求线程就可能被长期占住,因此通常都应该明确设一个范围,例如 3~10 秒。
retries 不是你不配就没有
很多人以为自己没传重试参数,就等于不重试,但 urllib3 的默认值是 Retry(3)。这在网络不稳定时可能是保护,也可能让接口行为与预期不一致,后面单独展开。

实战配置示例
import urllib3
from urllib3.util.retry import Retry
import socket

pool = urllib3.PoolManager(
    num_pools=100,           # 缓存 100 个不同主机的连接池
    maxsize=50,              # 每个池最多 50 个连接
    timeout=3.0,             # 3 秒超时
    retries=Retry(total=3, backoff_factor=0.5),
    block=True,              # 池满就等,不报错
    source_address=("0.0.0.0", 0),  # 绑定本地 IP
    socket_options=[
        (socket.SOL_SOCKET, socket.SO_KEEPALIVE, 1),
        (socket.IPPROTO_TCP, socket.TCP_KEEPIDLE, 45),
        (socket.IPPROTO_TCP, socket.TCP_KEEPINTVL, 10),
        (socket.IPPROTO_TCP, socket.TCP_KEEPCNT, 6),
    ],
)

response = pool.request('GET', 'https://api.example.com/data')
print(response.status, response.data)
这类配置适合多主机访问、需要控制连接保活、也希望失败请求按策略重试的服务端程序。参数不一定越多越好,但超时、池大小和重试策略最好始终写清楚。
最容易踩的 3 个坑
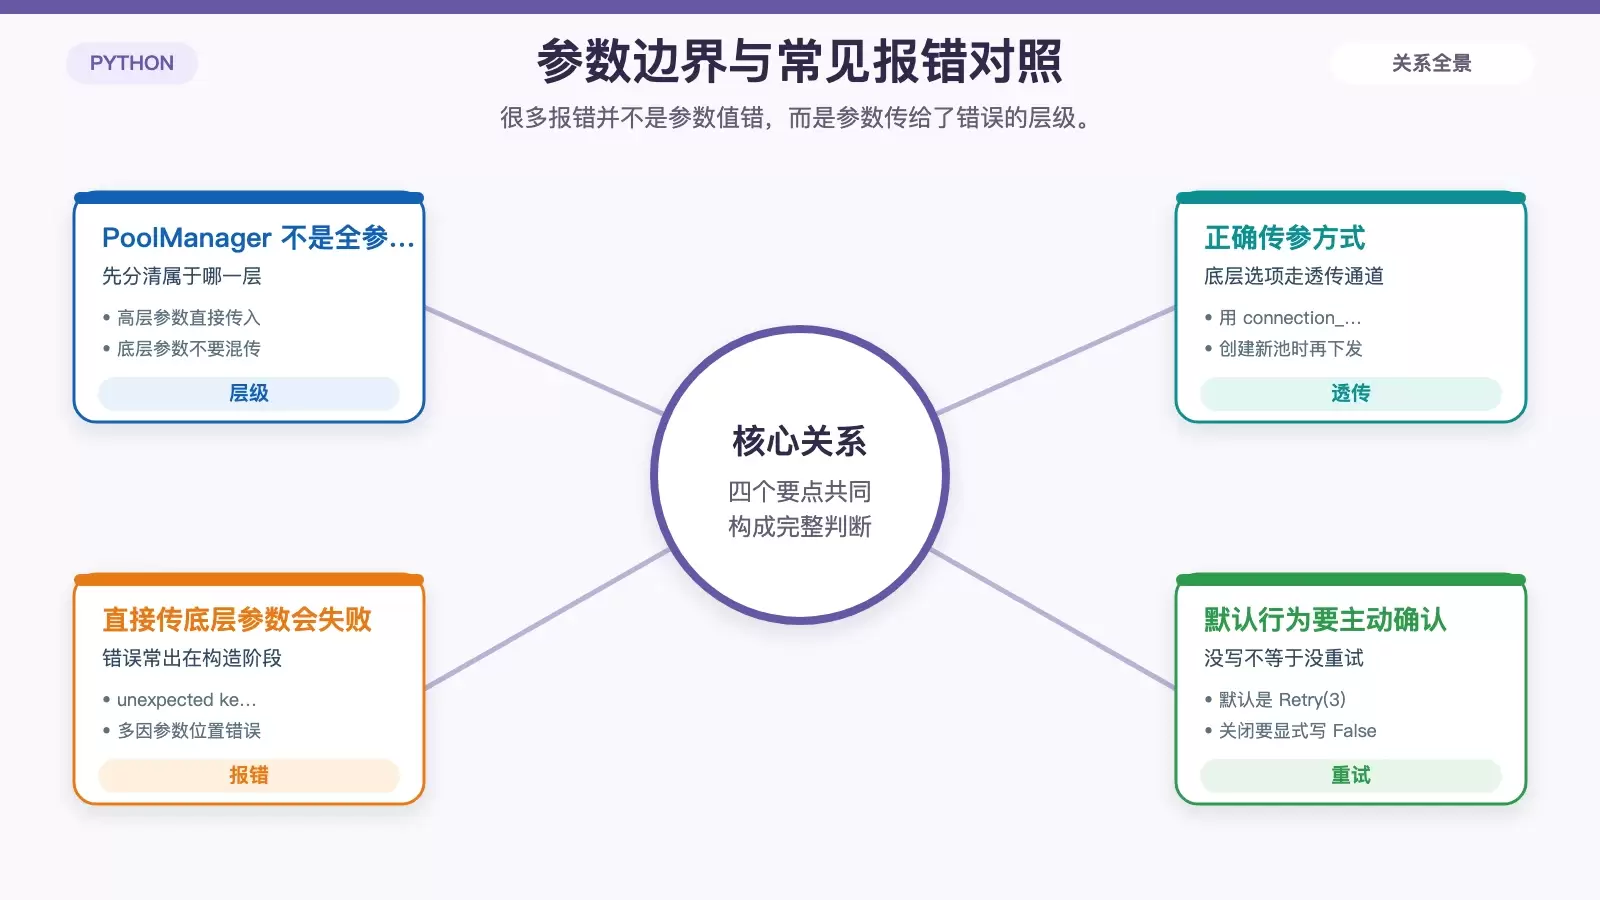
PoolManager 本身不复杂,真正容易出问题的地方往往在“以为它能直接接收某些底层参数”或“默认行为与直觉不一致”。下面这 3 个坑最常见。
坑 1:pool_preload_content 和 enforce_content_length 不能直接传给 PoolManager
这两个参数属于 HTTPConnectionPool,并不是 PoolManager 构造函数直接支持的参数。如果你直接传,通常会看到类似错误:
TypeError: __new__() got an unexpected keyword argument 'key_pool_preload_content'
这里的核心问题不是参数名拼错,而是参数层级用错了。PoolManager 自身负责管理池,不直接接收所有底层池参数。仅仅想使用默认行为时,删掉这两个参数即可;默认就已经是延迟读取,不必额外干预。
坑 2:socket_options 少了 level 参数会直接出错
#  错误写法
socket_options=[
    (socket.SOL_SOCKET, socket.SO_KEEPALIVE, 1),
    (socket.TCP_KEEPIDLE, 45),    # 缺 level!
]
setsockopt() 需要的是完整三元组:(level, optname, value)。也就是说,TCP 相关保活项不能只写选项和值,必须带上协议层级。
正确方式是补上 socket.IPPROTO_TCP:
#  正确写法
socket_options=[
    (socket.SOL_SOCKET, socket.SO_KEEPALIVE, 1),
    (socket.IPPROTO_TCP, socket.TCP_KEEPIDLE, 45),
    (socket.IPPROTO_TCP, socket.TCP_KEEPINTVL, 10),
    (socket.IPPROTO_TCP, socket.TCP_KEEPCNT, 6),
]
这一点看起来像小问题,但在保活和连接回收策略比较敏感的系统里,往往就是最先导致初始化失败或行为异常的地方。
坑 3:要彻底关闭重试,必须显式写 retries=False
urllib3 默认是 retries=Retry(3)。所以“没有配置”并不等于“关闭重试”。如果你的接口调用要求一次即返回,或者你不希望请求被库层自动重放,就要明确写出来:
# 完全关闭重试
http = urllib3.PoolManager(retries=False)
这在调用非幂等接口时尤其关键。否则代码层面只写了一次请求,底层却可能已经帮你试了多次。
需要控制底层连接池参数时,用 connection_pool_kw
如果确实要把参数传给每个新建的 ConnectionPool,正确入口不是直接塞进 PoolManager,而是通过 connection_pool_kw 透传。
pool = urllib3.PoolManager(
    connection_pool_kw={
        'pool_preload_content': False,
        'enforce_content_length': False,
    }
)
这种写法的意义在于:PoolManager 只负责统一管理和创建连接池,而具体连接池实例该带哪些底层参数,由 connection_pool_kw 交给内部新建流程处理。这也是更符合 urllib3 设计边界的方式。
如果你的需求还要更进一步,比如针对不同主机定制不同连接池行为,那才需要考虑继承 PoolManager 并重写 _new_pool。但对大多数业务系统来说,先把透传层级用对,就能解决 90% 的问题。
生产环境里的 SSL/TLS 配置与常用方法
除了连接池本身,生产环境还经常忽略证书校验。只要请求走 HTTPS,就应该把服务端证书验证明确打开,而不是依赖模糊默认值。
基本证书校验配置
import certifi
import urllib3

http = urllib3.PoolManager(
    cert_reqs='CERT_REQUIRED',
    ca_certs=certifi.where(),
)
这里 cert_reqs='CERT_REQUIRED' 表示强制校验证书,ca_certs=certifi.where() 则提供 CA 证书集合路径。这是通用 HTTPS 客户端里比较稳妥的起点。
双向认证场景
如果服务端要求客户端证书,还需要提供证书文件、私钥和可能的私钥口令:
http = urllib3.PoolManager(
    cert_file='/path/to/client_cert.pem',
    key_file='/path/to/client.key',
    key_password='your_password',
    cert_reqs='CERT_REQUIRED',
    ca_certs='/path/to/ca_bundle.pem',
)
这类配置常见于内部服务调用、金融或企业专线接口。重点不是参数多,而是把服务端验证和客户端身份材料分清楚。
常用方法速查
| 方法 | 用途 |
|---|---|
| request(method, url, **kw) | 发送请求,最常用 |
| clear() | 清空所有连接池,关闭所有连接 |
| connection_from_host(host, port) | 获取指定主机的连接池 |
| connection_from_url(url) | 从 URL 解析出连接池 |
其中 request() 是最常用入口;而在调试连接复用、观察特定主机池状态时,connection_from_host() 和 connection_from_url() 更有针对性。需要释放资源时,再调用 clear() 清空所有池和连接。
一张图看懂它的池化结构
PoolManager
  ├── HTTPConnectionPool (api.example.com:443)
  │     ├── conn1 ──→ 可复用
  │     ├── conn2 ──→ 可复用
  │     └── conn3 ──→ 可复用
  ├── HTTPConnectionPool (cdn.example.com:443)
  │     └── conn1 ──→ 可复用
  └── RecentlyUsedContainer (管理上述所有池)
可以把它理解成两层结构:
第一层是 PoolManager,按 (host, port, scheme) 维度维护多个独立连接池;第二层是每个 HTTPConnectionPool,内部再维护若干可复用连接。
当不同主机越来越多时,管理这些池的容器会按 LRU 策略淘汰最久未使用的池,这也是前面为什么要关注 num_pools 的原因。它不仅影响缓存数量,也直接影响连接复用命中率。
把这套结构记住之后,很多行为就更容易解释了:为什么同一主机请求越多越能复用连接,为什么跨大量域名访问时需要调大 num_pools,以及为什么某些参数必须通过底层连接池透传。
实际使用时,优先记住这几件事
PoolManager 的核心价值可以概括成一句话:你专注请求本身,它负责把连接池分组、复用和回收这些细节接住。
真正决定可用性的,通常不是“会不会用”,而是有没有把几个关键边界搞清楚:多主机场景先看 num_pools,并发高时联动考虑 maxsize 和 block,生产环境必须显式设置 timeout,而默认重试行为也需要按接口语义判断是否保留。
再往前一步,遇到参数不生效或初始化报错时,先判断它究竟属于 PoolManager 还是 HTTPConnectionPool。这个分层一旦理顺,connection_pool_kw、socket 保活和 SSL/TLS 配置基本都能顺着解决。