日志几乎是 Node.js 应用排障、追踪和运维判断的第一手材料,但在 Ubuntu 上把它真正用好,并不只是把内容写进文件这么简单。要让日志既能支撑开发调试,又不拖垮线上性能,还要兼顾轮转、检索和安全,通常需要一套成体系的设计。下面按实际落地顺序梳理这套策略,帮助你判断该选什么库、日志该怎么分级,以及哪些系统配置必须提前补上。
先选对日志库,决定后续扩展空间
日志方案的起点,是先确定应用到底需要什么类型的记录能力。对于 Node.js 项目,常见方案并不少,但它们适合的场景并不一样:
- Winston:灵活性高、扩展能力强,适合需要多目标输出、多格式处理和较强定制能力的项目。
- Pino:以高性能见长,更适合高吞吐、对 CPU 和内存开销敏感的服务。
- Morgan:主要用于 HTTP 请求日志,放在 Express 或 Koa 这类 Web 应用中非常顺手。
如果你的应用既有业务日志、错误日志,又希望后续接入文件、控制台或外部平台,Winston 通常更容易搭建完整策略;如果瓶颈已经落在日志开销上,Pino 会更合适;而 Web 服务中的访问记录,很多时候单独交给 Morgan 处理会更清晰。
实际选择时,重点不是“社区里谁更流行”,而是项目当前规模、吞吐压力和后续维护成本。工具一旦选定,后面的级别、分流和监控接入都会围绕它展开。
日志级别怎么配,开发与生产要分开看
很多日志失控的问题,本质上都不是“没打日志”,而是“什么都打”。开发环境和生产环境的目标不同,日志级别也不应该一套配置通吃。
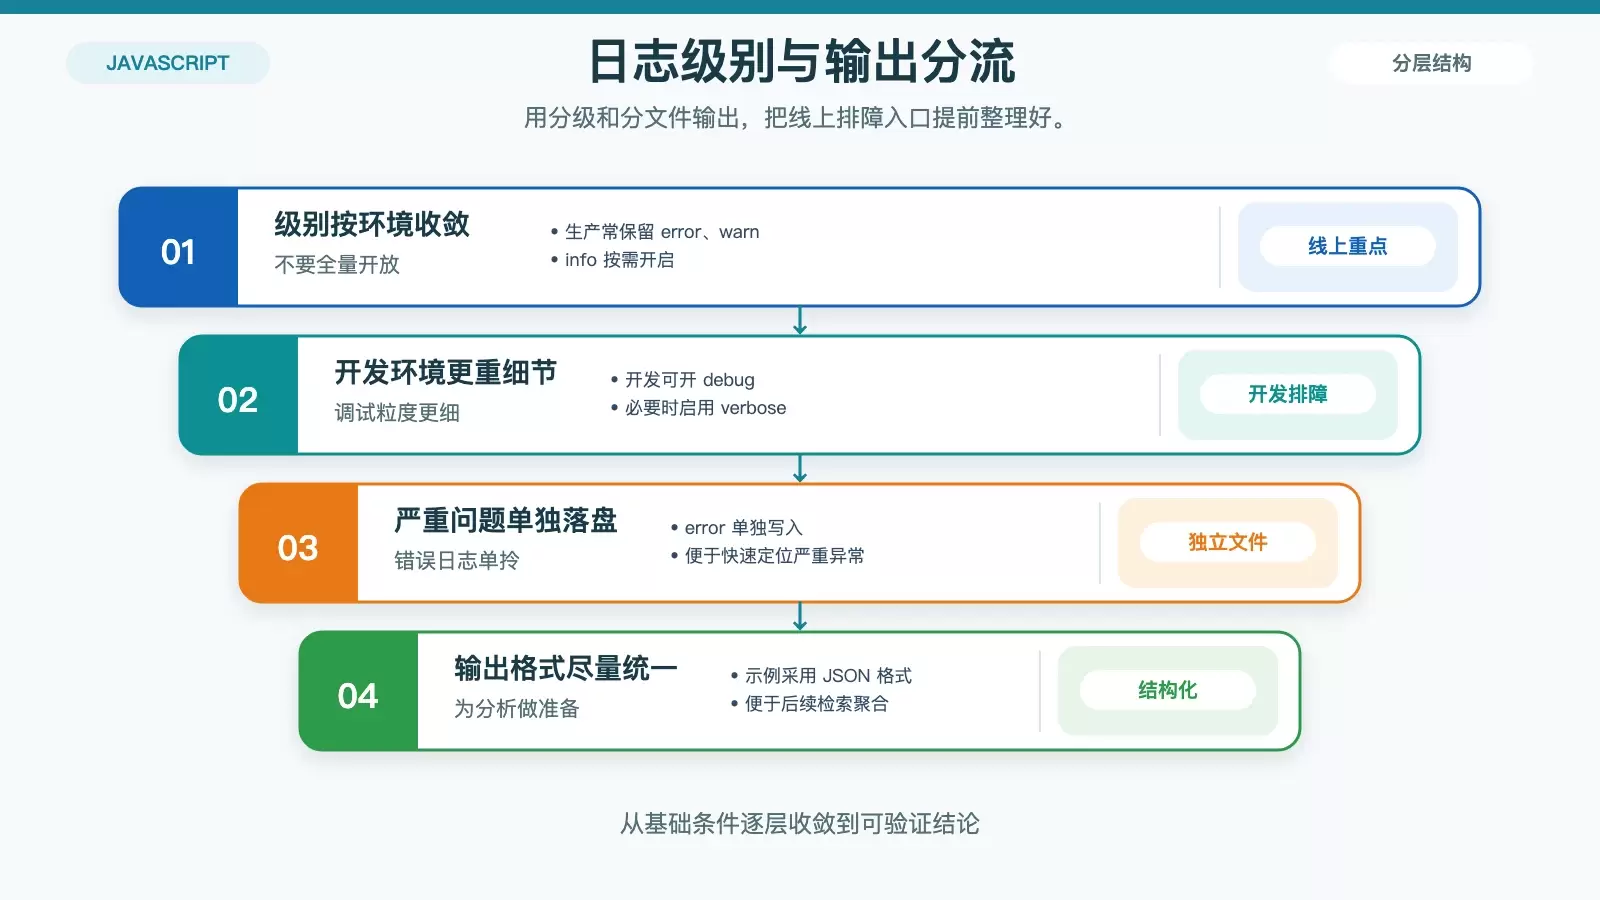
常见级别一般包括:error、warn、info、debug、verbose。开发阶段为了定位逻辑问题,通常会开放 debug 甚至 verbose;但到了生产环境,过多细节会带来噪声、I/O 压力和检索成本,通常保留 error、warn,按需加上 info 就够了。
以 Winston 为例,基础配置可以直接从下面这类结构开始:
const winston = require('winston');
const logger = winston.createLogger({
  level: 'info', // 默认日志级别
  format: winston.format.json(),
  transports: [
    new winston.transports.File({ filename: 'error.log', level: 'error' }),
    new winston.transports.File({ filename: 'combined.log' }),
  ],
});
这段配置的重点不只是“能写文件”,而是把 error 单独输出到 error.log。这样做的好处很直接:当线上出问题时,不必先从大量普通信息中筛选严重异常,先看独立的错误日志就能更快定位问题。
如果项目存在多环境部署,建议把级别配置和环境变量绑定,而不是写死在代码里。开发机、测试环境和生产环境看到的日志粒度,应当服务于各自的排障目标。
控制文件增长:轮转与分割要一起做
只记录、不治理,日志迟早会变成系统负担。Ubuntu 环境里最基础也最重要的一步,就是处理日志文件无限增长的问题。

用 logrotate 做轮转,避免磁盘被日志占满
Ubuntu 自带的 logrotate 就是最常见的解决方案。你可以在 /etc/logrotate.d/ 下为应用单独增加配置,例如创建 myapp:
/path/to/your/app/logs/*.log {
  daily
  missingok
  rotate 7
  compress
  notifempty
  create 0640 root adm
}
这份配置表达得很明确:
daily:每天轮转一次;rotate 7:保留最近 7 份历史日志;compress:旧日志自动压缩;notifempty:空文件不处理;create 0640 root adm:新日志文件按指定权限和属主创建。
对于中小型服务,这已经能显著降低磁盘膨胀风险。保留周期可以按实际排障窗口调整,但“长期不轮转”基本可以视为生产环境隐患。
按日志类型分文件,后期排查更省时间
轮转解决的是“文件会不会越来越大”,分割解决的是“出了问题能不能快速找”。如果 HTTP 访问、业务事件和异常堆栈全挤在同一个文件里,后续分析会非常低效。
更实用的做法,是按模块或用途拆分日志输出。比如仍然用 Winston,可以给不同类型的日志配置不同传输器:
const logger = winston.createLogger({
  level: 'info',
  format: winston.format.json(),
  transports: [
    new winston.transports.File({ filename: 'error.log', level: 'error' }),
    new winston.transports.File({ filename: 'access.log' }),  // HTTP请求日志
    new winston.transports.File({ filename: 'app.log' }),     // 应用日志
  ],
});这种分法的价值在于,每个文件承载的语义更单一:access.log 用来观察请求模式,app.log 用来跟踪业务流程,error.log 则聚焦异常。排查性能问题、接口异常或故障高峰时,检索路径会清晰很多。
日志不止用于复盘,还要接入监控和分析
如果日志只在事故发生后才被翻出来看,那它的价值只发挥了一半。更成熟的做法,是把日志接入监控体系,既能实时报警,也能长期分析趋势。
监控和报警:把异常从“事后发现”变成“及时感知”
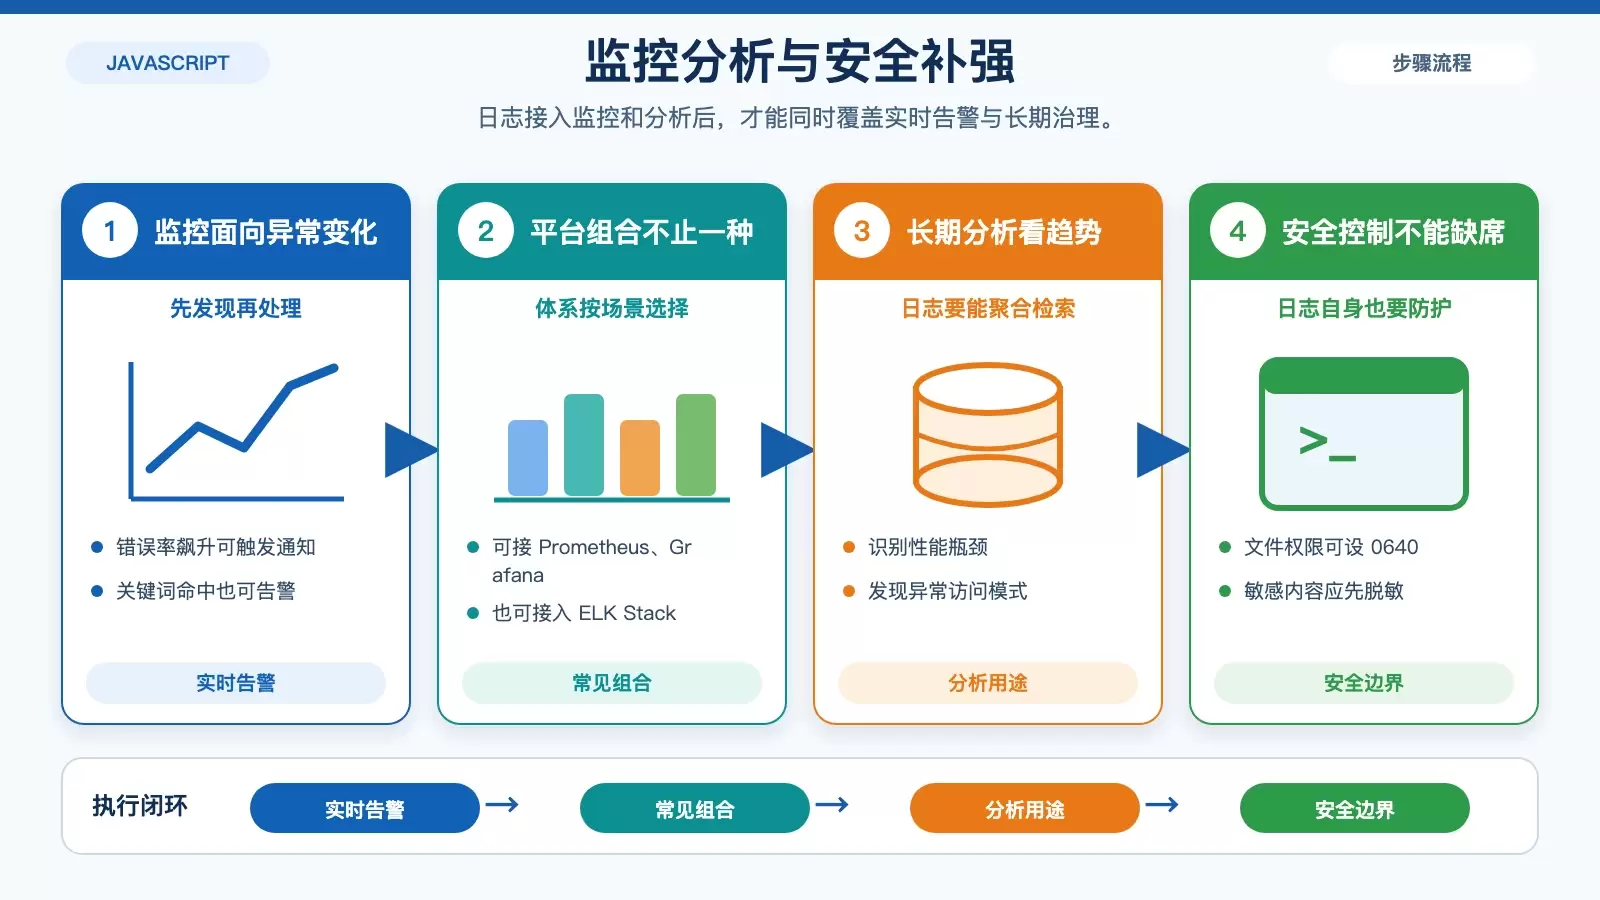
常见组合包括 Prometheus、Grafana,以及 ELK Stack,也就是 Elasticsearch、Logstash、Kibana。它们的角色不同,但目标一致:当错误率飙升、关键字段异常或出现指定关键词时,系统能自动发出告警。
告警渠道可以是邮件、钉钉、Slack 等,关键不在于接到哪里,而在于告警规则是否和业务风险对应。比如某个接口连续报错、认证失败突然增多、或数据库连接异常集中出现,这些都比单纯“有日志产生”更值得触发通知。
日志分析:从文本记录里找出性能和稳定性问题
除了实时告警,定期分析日志也很有必要。很多性能瓶颈、请求异常模式和隐藏故障,并不会立刻演变成宕机,但会先在日志里留下痕迹。
工具上,ELK Stack 往往是开源场景下的首选;Splunk 的能力更强,但通常需要付费。无论选哪一个,核心思路都一样:把原本分散、非结构化的日志文本转换成可搜索、可聚合的数据,再通过检索、聚合和图表看到错误趋势、访问峰值和异常分布。
当日志具备结构化输出能力后,后续做查询和统计会轻松很多,这也是为什么很多 Node.js 项目会优先采用 JSON 格式日志。
最后别忽略安全性,日志本身也可能是风险源
日志常被视为排障工具,但它本身也可能成为数据泄露入口。用户标识、请求参数、内部路径、异常堆栈,很多内容都带有敏感信息,一旦权限失控或日志外流,问题不会比程序报错更轻。
至少要先做到两件事:
- 设置合适的文件权限,例如
0640,限制无关账号直接读取; - 对敏感字段做脱敏处理,避免把用户隐私、密钥或内部细节原样写入日志。
如果业务受合规要求约束更强,还可以进一步考虑日志加密存储。这样即使文件被导出,也不至于直接暴露全部内容。
从运维角度看,安全控制不是附加项,而是日志策略的一部分。能查问题的日志,前提是它不会先制造新的风险。
一套可落地的 Ubuntu Node.js 日志策略应该长什么样
把这些环节串起来看,一套更可靠的 Ubuntu JavaScript 日志方案,通常包含几个连续动作:先按项目特点选择日志库,再区分环境设置日志级别,然后通过 logrotate 控制文件体积,并按用途拆分不同日志文件;在此基础上,把关键日志送入监控、告警和分析系统,最后再用权限、脱敏和必要的加密手段补足安全边界。
这套方法并不复杂,难点在于是否长期坚持。只要把日志从“顺手输出一点内容”提升为“可维护的系统能力”,Ubuntu 上的 Node.js 应用在可观测性、稳定性和故障处理效率上,通常都会明显提升一个层级。









