在 Ubuntu 上排查 JavaScript 问题,最怕的是一上来就四处翻日志,结果信息很多、方向却不清楚。更稳妥的做法,是按“应用输出、服务状态、代理层、运行环境、最近变更”这条线逐层收窄范围;这样不仅能更快定位问题,也更容易判断它到底是代码报错、部署异常,还是系统环境拖了后腿。
先看应用日志和浏览器控制台
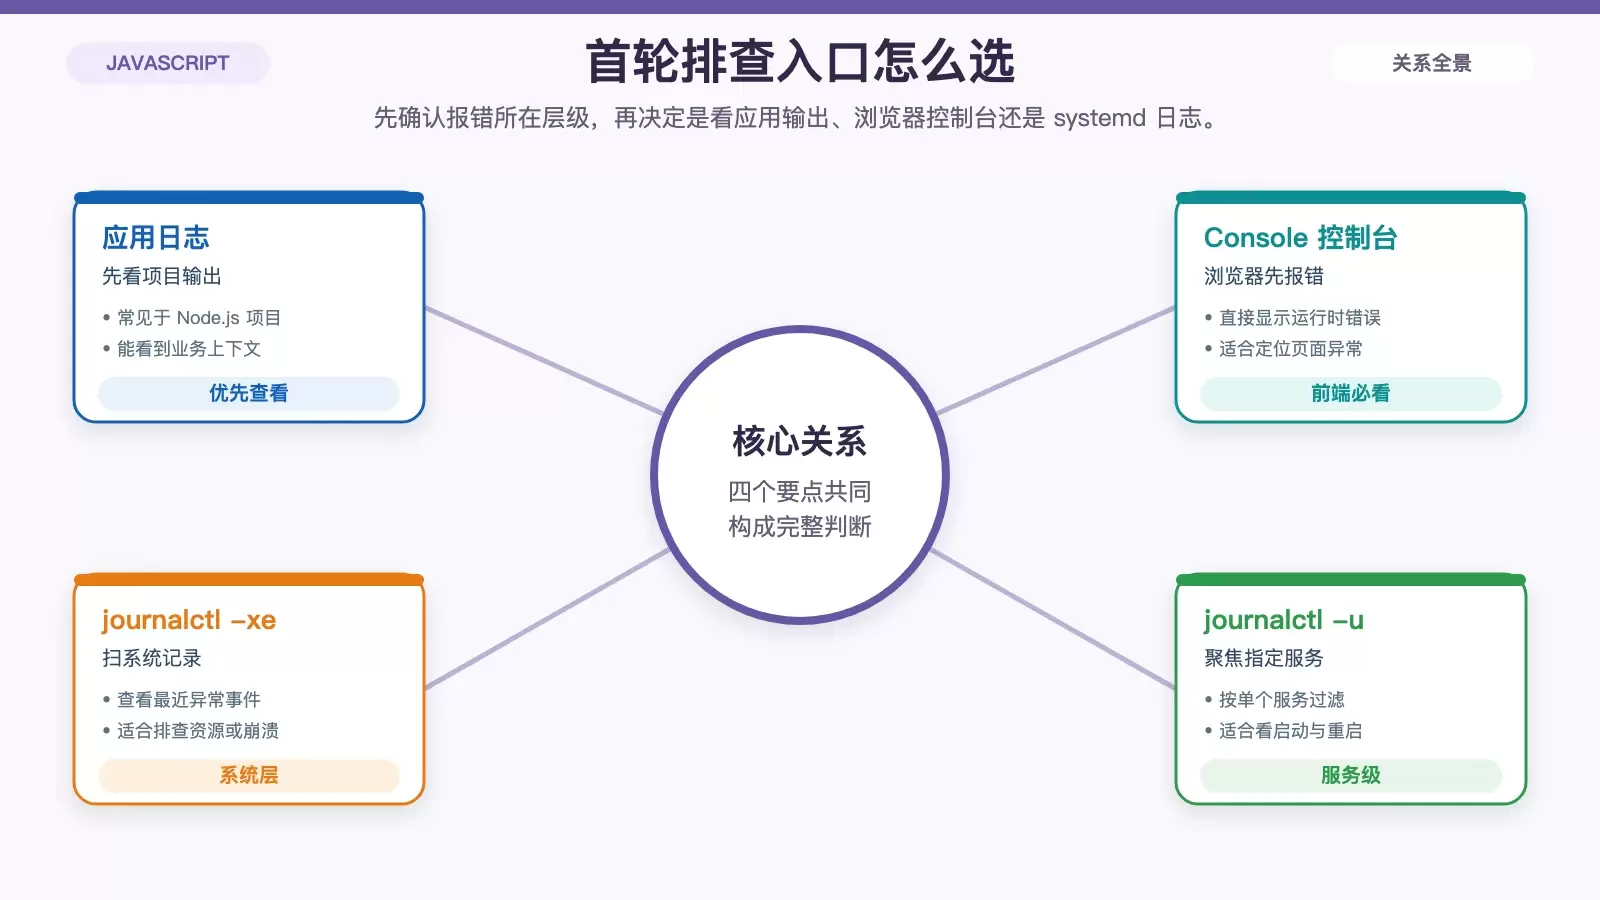
如果是 JavaScript 或 Node.js 应用本身报错,最直接的线索通常不在系统层,而在应用自己的输出里。很多项目已经接入了基础日志体系,比如用 console.log()、winston 或 morgan 输出运行信息,这些内容往往能直接暴露异常位置、请求上下文或启动失败原因。
如果问题出现在 Web 应用前端,还应优先打开浏览器开发者工具的 Console 标签页。这里通常会直接显示 JS 运行时错误、警告、资源加载失败或接口调用异常,比先去翻系统日志更高效。对于页面报错、脚本未执行、某个交互失效这类问题,控制台信息往往就是第一手证据。
这一步的重点不是“多看”,而是先确认报错发生在哪一层:是浏览器端脚本执行失败,还是后端 Node.js 进程本身就没正常工作。层级判断清楚了,后面的日志才不会看偏。
再查 systemd 与系统级日志
如果应用日志没有直接给出答案,下一步就该看 Ubuntu 的系统日志。很多 JavaScript 服务虽然表面上是“脚本问题”,实际触发点却可能是系统级事件,例如进程崩溃、权限异常、内存不足,或者服务重启失败。
常用命令是:
journalctl -xe这个命令可以查看最近的系统事件,适合先快速扫一遍当前机器是否存在异常记录。
如果你的 JS 服务由 systemd 管理,比如某个 Node.js 守护进程,那最好直接按服务名过滤,这样信息更集中:
journalctl -u your-service-name这种方式特别适合排查服务启动失败、反复退出、依赖项没准备好等问题。相比全局日志,按单个服务查看更容易拼出完整时间线,例如服务何时启动、退出时抛了什么错、systemd 是否尝试了重启。
如果日志里出现 OOM、segfault、permission denied 或频繁 restart 之类的信号,就不要只盯着业务代码了,应该同步检查资源占用、用户权限和服务配置。
不要忽略 Nginx 或 Apache 的错误日志
很多 JavaScript 应用并不是直接对外提供服务,而是部署在 Nginx 或 Apache 后面。这个时候,用户看到的“页面打不开”“接口超时”“静态资源加载失败”,未必是 JS 本身的问题,也可能是代理层、转发配置或上游连接出了问题。
以 Nginx 为例,错误日志常见位置是:
/var/log/nginx/error.log这里经常能看到请求失败、连接超时、上游服务不可用等记录。对于前端资源 404、反向代理转发异常、WebSocket 连接中断等现象,这类日志很有价值,因为它补上了“用户请求进入服务器之后发生了什么”。
如果应用前端一切正常,但请求始终没有返回、页面刷新后报 502 或 504,那么优先看 Web 服务器错误日志通常比反复修改 JS 代码更有效。它能帮助你区分:是应用没响应,还是请求压根没被正确转发过去。
Node.js 场景下的调试与结构化日志
如果排查对象本身就是 Node.js 服务,仅靠零散输出有时不够,这时可以结合调试参数和结构化日志一起使用。
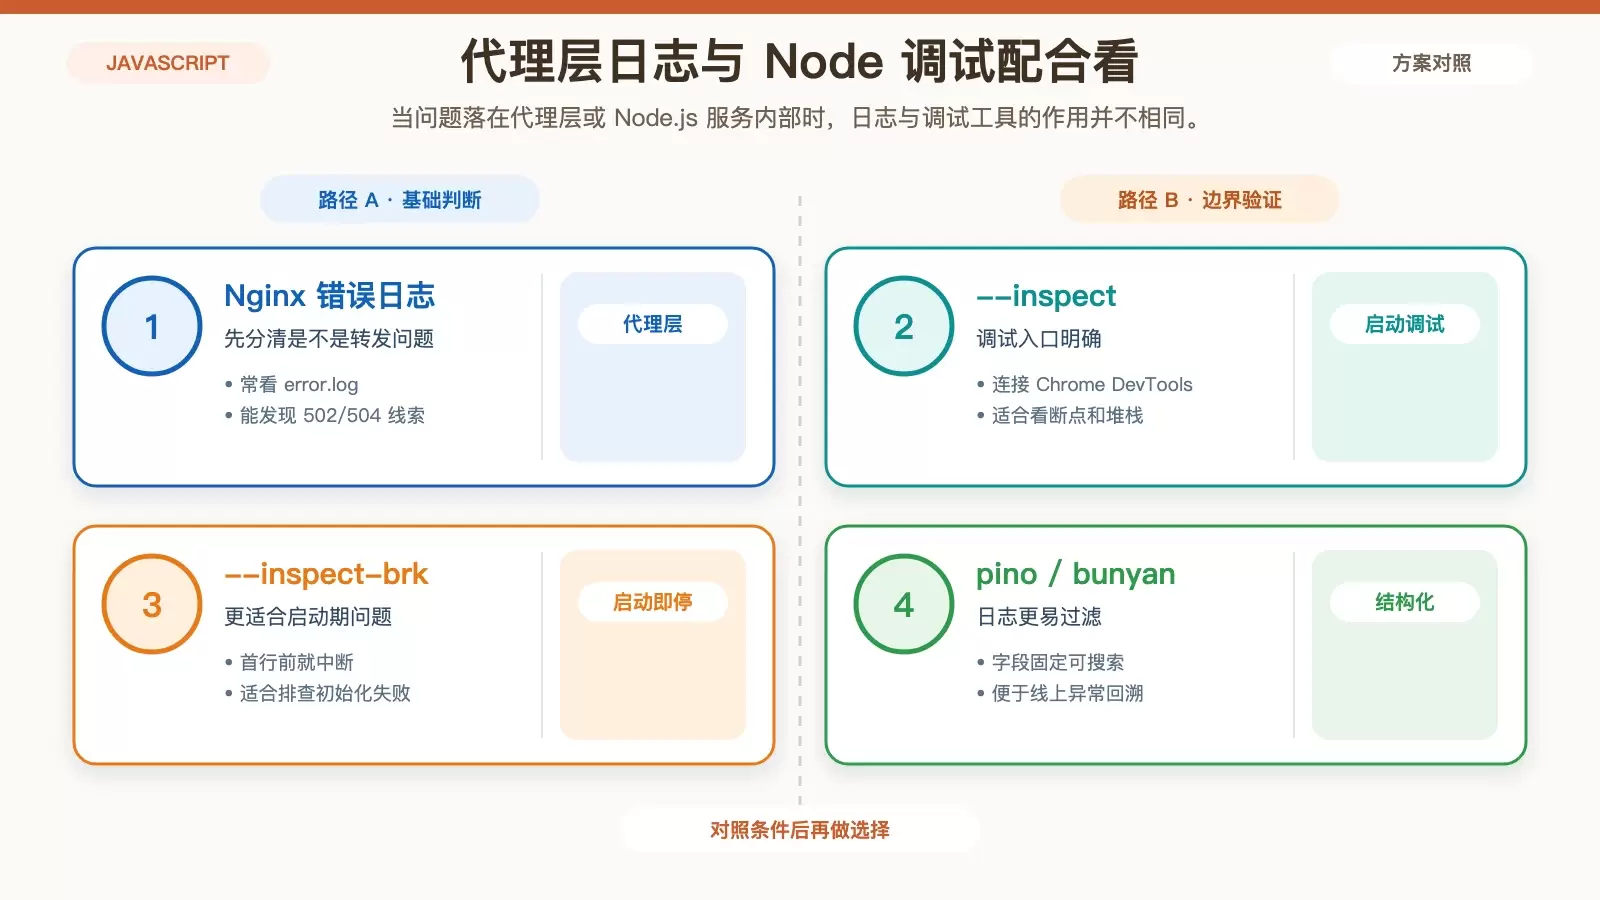
Node.js 启动时可加上以下标志:
--inspect
--inspect-brk
这样就能连接 Chrome DevTools 进行调试,查看断点、变量值和调用堆栈。对于启动阶段即报错、异步调用链复杂、某个分支逻辑异常这类问题,这种方式通常比加一堆临时 console.log() 更清楚。
另外,如果项目使用 pino、bunyan 这类日志库输出结构化日志,后续检索和分析会轻松很多。结构化日志的优势不只是“格式好看”,更在于它能把时间、级别、请求标识、异常对象等字段稳定地保留下来,方便按条件过滤,也更适合接入集中式日志系统。
对于线上问题,这类能力尤其重要:你不一定能复现,但只要上下文记录得够完整,就能根据单次异常反推出触发路径。
检查环境配置与最近代码变更
排查 JavaScript 问题时,一个常见误区是默认“肯定是代码写错了”。实际上,环境变量、配置文件和最近一次发布改动,经常才是真正的触发点。

例如应用启动失败、连接数据库报错、读取不到密钥、某个功能只在线上失效,这些情况都应先检查环境变量是否写错、配置是否缺项、语法是否有明显错误。很多时候只是外部配置不一致,就足以让 JS 应用表现得像“代码坏了”。
如果问题出现在一次更新之后,更应该尽快回到版本变更本身。用 Git 对比最近提交,或者临时回滚到上一个稳定版本,往往能迅速判断故障是不是由新改动引入。这个动作的价值在于,它能把排查范围从“整个系统”缩小到“最近那一批差异”。
最后,别忽略日志里的具体错误消息。遇到明确的异常文本,直接拿去搜索往往很有效。很多常见坑并不需要从零分析,别人已经遇到过,关键是先把报错原文准确提取出来,而不是只凭现象猜问题。
排查顺序比堆工具更重要
在 Ubuntu 上处理 JavaScript 问题,真正有效的方法通常不是一次性把所有日志都翻完,而是按层次逐步定位:先看应用和浏览器输出,再看 journalctl 与服务状态,接着补查 Nginx 或 Apache 日志,最后回到 Node.js 调试、环境配置和代码变更。
只要顺序清楚,很多问题其实都能很快缩小范围。先判断报错出现在哪一层,再决定下一步看什么,比一开始就陷在细节里要高效得多。









