Node.js 应用一旦进入线上环境,日志很快就会从“看得懂”变成“看不过来”。真正拉开效率差距的,不是盯着终端硬翻,而是先按优先级、来源、时间线和上下文把信息拆开,再决定是继续手查、借助工具,还是直接进入调试和测试。
下面这套方法适合处理堆栈交错、信息量大的 JavaScript 运行日志。你可以把它当成一条排查路径:先缩小范围,再确认触发位置,最后用复现和测试把结论坐实。
先用日志级别缩小排查范围
看到一大段输出时,第一步不是从头读到尾,而是先判断哪些内容值得优先处理。Node.js 中常见的几类日志本身就带有不同信号强度:
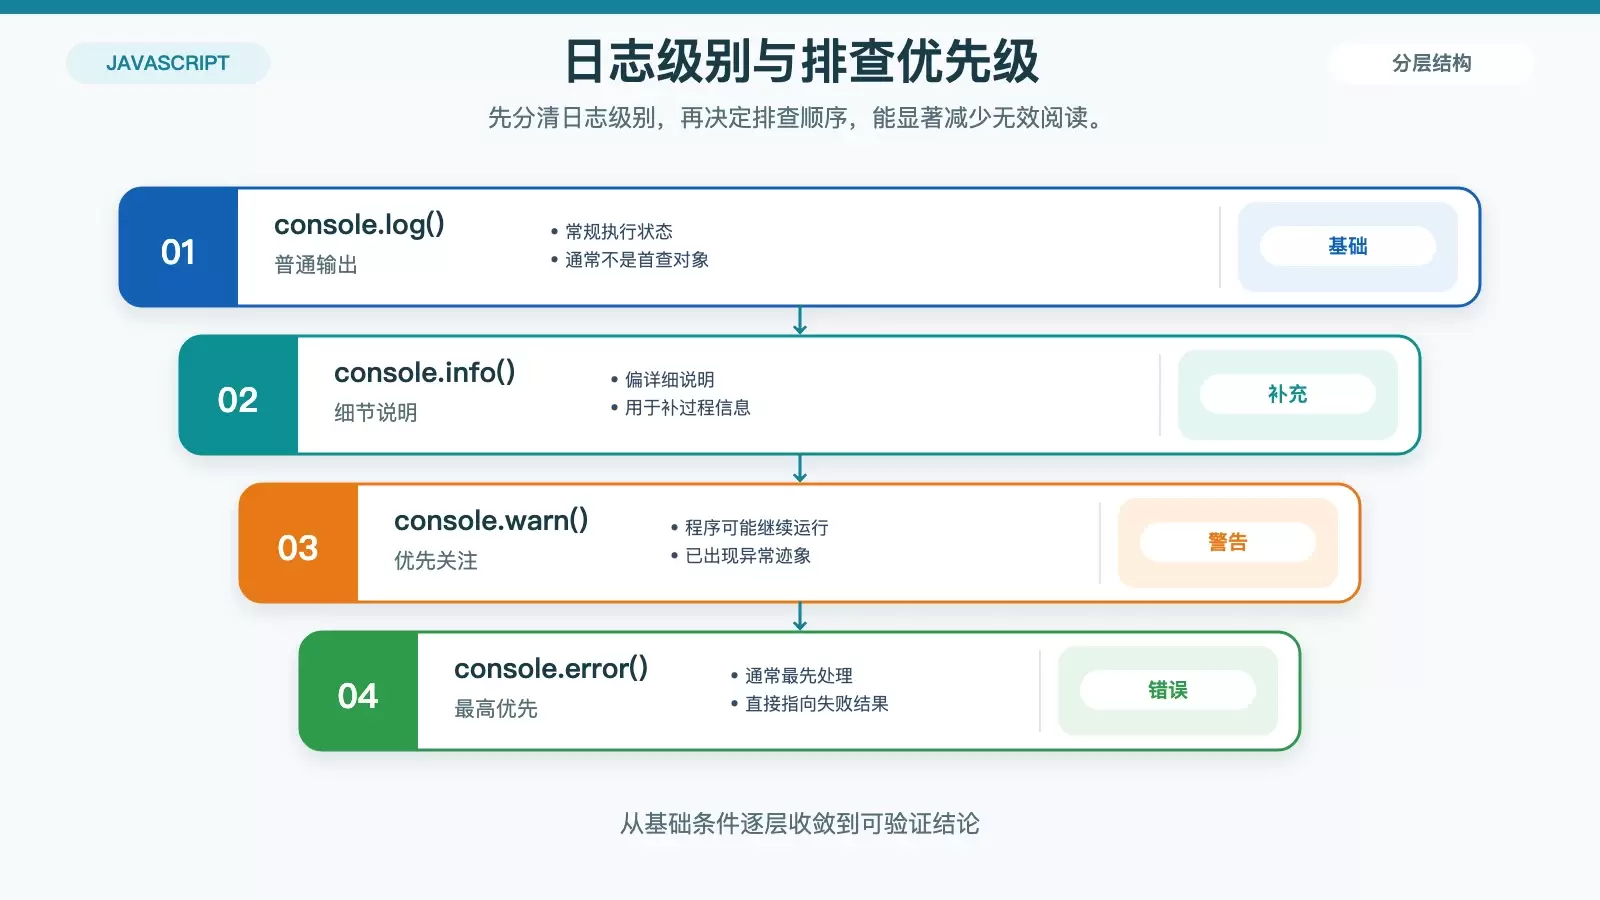
console.log():一般信息,用来记录普通执行状态。console.info():更偏详细说明,通常用于补充过程信息。console.warn():警告,说明程序还能继续跑,但已经出现异常迹象。console.error():错误,通常应该最先处理。
如果日志量很大,先盯住 error 和 warn,可以快速把注意力从噪声里抽出来。很多问题并不需要完整阅读全部输出,先抓住高优先级信号,后面的判断会轻松很多。
定位来源,再按时间线还原发生过程
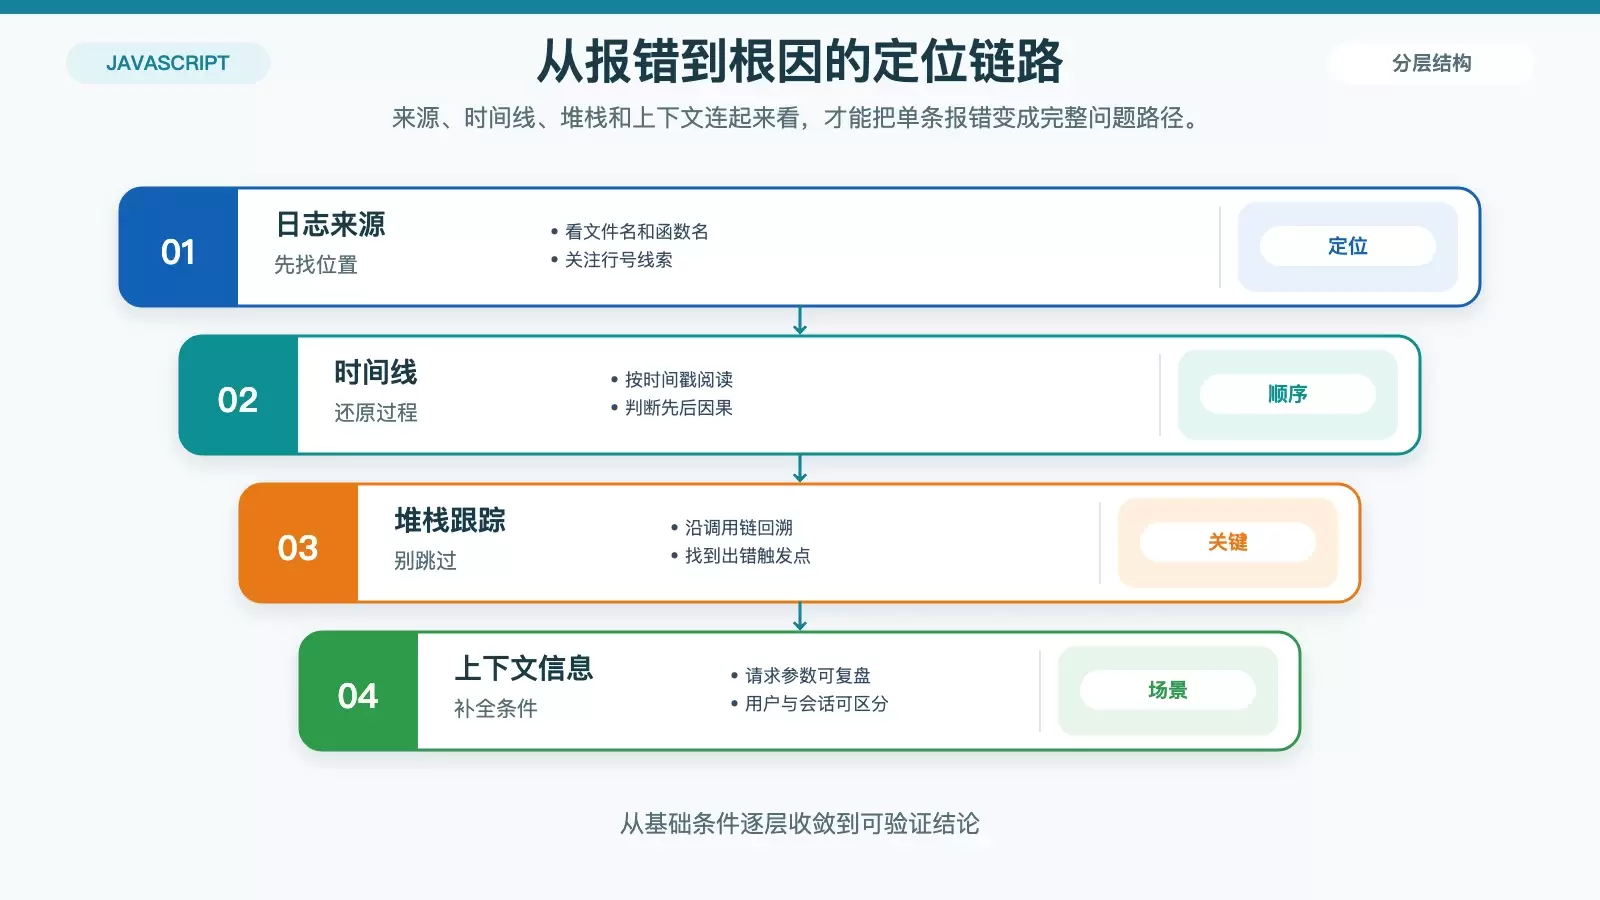
确定优先级之后,下一步是找到日志从哪里来。实际排查中,文件名、函数名和行号往往比大段描述更有价值。
例如日志里出现 userController.js:42,通常就意味着问题与用户控制器第 42 行附近有关。顺着这个位置回到代码,可以更快看到当时执行了什么逻辑、用了哪些参数、依赖了哪些上下文。
随后要结合时间戳逐行阅读。时间顺序往往能揭示事件之间的因果关系:哪个请求先进入、哪个警告先出现、哪个错误是连锁反应的结果。特别是在多个异步操作交织时,只看单条错误信息很容易误判,按时间线串起来才更接近真实执行过程。
这一步的目标不是立刻修复,而是回答两个问题:错误发生在什么模块,之前又发生了什么。
抓关键词、看堆栈、补上下文
当日志文件很长时,手动滚动查找效率很低,这时应该先做筛选。可以在编辑器里搜索,也可以直接用命令行工具过滤重点词,比如:
grep "error"
grep "warning"
grep "exception"
类似 error、warning、exception 这样的关键词,通常能帮助你先找到真正值得读的片段,再回头补全上下文。
如果日志中带有堆栈跟踪,就更不能略过。堆栈记录的是函数调用链,能把问题从表面现象一路追回触发点。很多时候,报错信息本身只告诉你“坏了”,而堆栈才告诉你“是怎么坏的、在哪一层坏的”。
除了堆栈,还要看日志里是否附带请求参数、用户 ID、会话 ID 等上下文信息。这些字段能帮助你判断问题是否只在某个用户、某类请求或某个场景下出现。对于偶发问题,这类上下文尤其重要,因为它往往决定你能否稳定复现。
什么时候该上工具,什么时候该查文档和社区
如果日志规模已经超出人工可读范围,就不该继续靠肉眼翻。像 ELK Stack、Graylog 这类日志分析工具,更适合处理长期积累的大量输出。它们的价值不只是“看日志更方便”,而是能把日志做解析、索引和可视化,让异常模式更容易被发现,也便于后续生成报告和持续监控。
对于团队项目,这类工具尤其适合用来建立长期排查机制,而不是每次出问题都临时翻文件。
另一条常被忽略的路径是查文档和社区。很多应用或框架本身就对日志格式、记录策略和常见错误有说明;如果你已经看到明确的报错关键词,也可以去 Stack Overflow 或相关技术论坛检索。遇到成熟框架时,别人踩过的坑往往已经有现成讨论,查到的速度通常比自己盲猜更快。
把日志结论落到调试和测试上
日志分析的终点不是“看懂了”,而是“验证并修掉了”。当你已经根据日志大致锁定问题范围后,下一步应该尝试重现故障,再配合断点和单步执行观察代码实际走向。
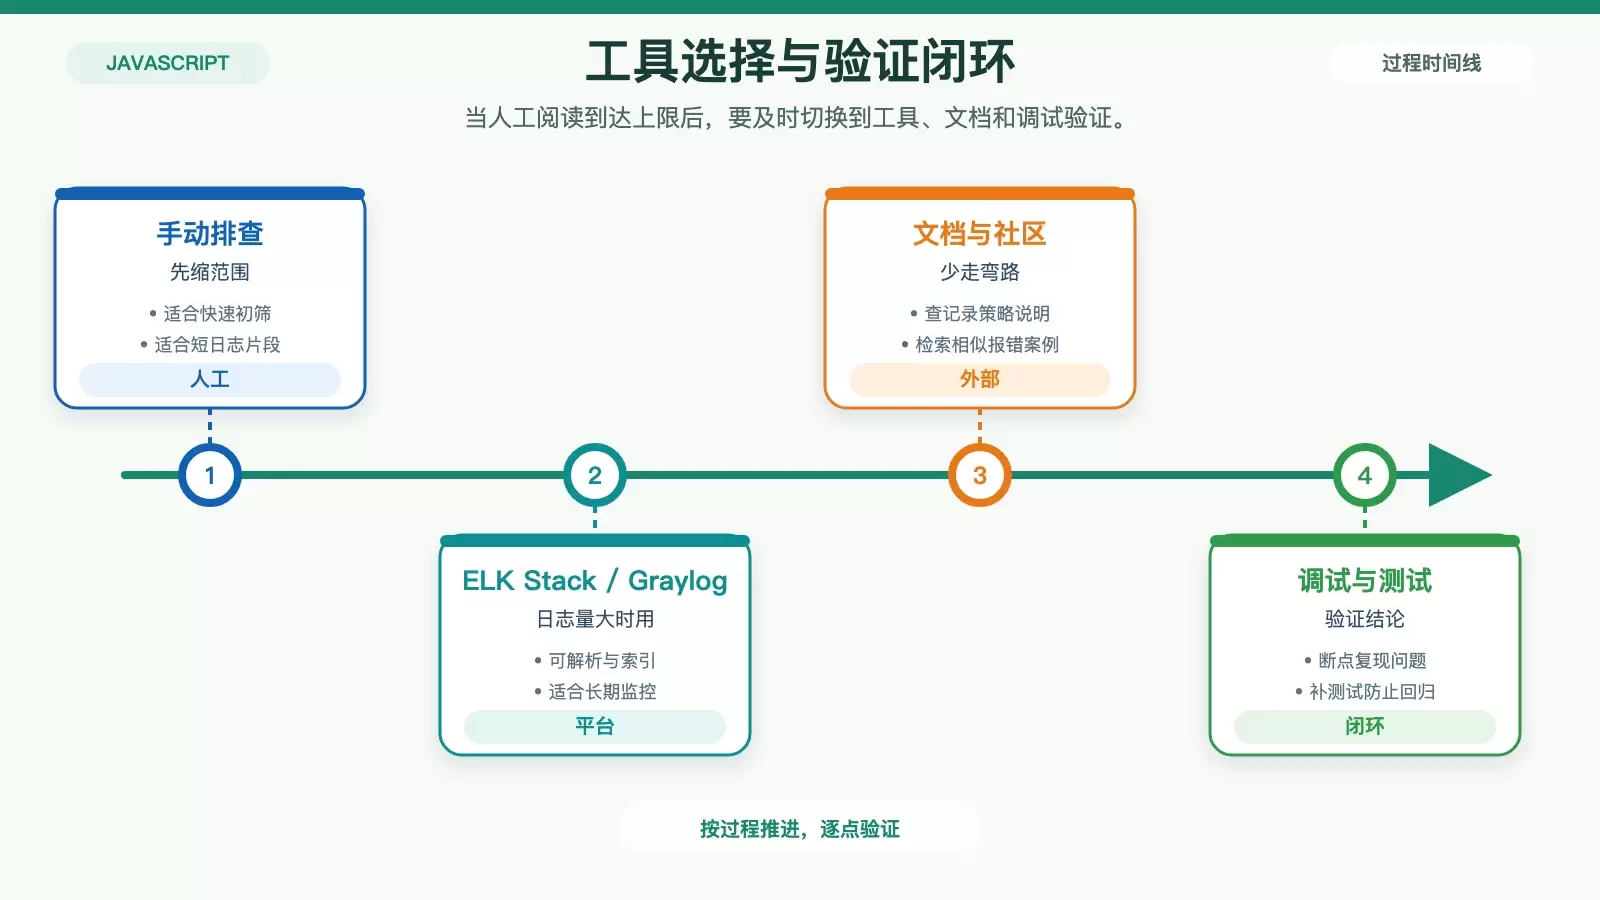
这一步可以用来确认两件事:第一,日志推断出来的根因是否成立;第二,修复后同样路径是否还会再次触发错误。
问题修完之后,最好补上对应测试用例。这样做的意义很直接:以后即使代码再次调整,至少能尽早发现同类问题回归,而不是等到新一轮日志报警时才被动处理。
把这套流程连起来看,复杂日志并不是不能读,而是不能乱读。先按级别筛,接着定位来源和时间线,再用关键词、堆栈与上下文确认问题范围;必要时引入 ELK Stack、Graylog 等工具,最后回到调试和测试完成闭环。做到这一步,日志就不再只是噪声,而是定位 Node.js 问题最直接的线索。









