在 Debian 上写 C++ 多线程,很多人一开始就会卡在两个问题上:到底该用
环境准备:Debian 上先把编译环境配齐
在 Debian 中做 C++ 多线程开发,第一步不是直接写代码,而是先确认编译工具链已经就绪。标准的安装方式如下:
sudo apt update
sudo apt install g++ build-essential
# 安装g++及编译工具链
如果你准备使用 C++11 标准库里的 libstdc++ 中。至于 pthread,Debian 环境里一般也已经具备基础支持,但原文仍给出了一个补充安装命令,适合在环境不完整时做兼容处理:
sudo apt install libpthread-stubs0-dev这里可以先建立一个简单判断:如果是新写的 C++ 项目,优先考虑
C++11 线程库实践:更适合现代 C++ 项目

基础线程创建与等待
先看最基础的线程创建。下面这个例子中,主线程启动一个子线程去执行 print_hello,然后通过 join() 等待它结束:
#include
#include

// 线程函数:无参数、无返回值
void print_hello() {
    std::cout << "Hello from a thread!" << std::endl;
}

int main() {
    // 创建线程:传递函数名作为参数
    std::thread t(print_hello);

    // 主线程继续执行
    std::cout << "Hello from the main thread!" << std::endl;

    // 等待子线程结束(必须调用,否则程序可能提前退出)
    t.join();

    return 0;
}
编译时要同时开启 C++11 标准并链接 pthread 支持:
g++ -std=c++11 -pthread multithreading_example.cpp -o multithreading_example示例输出可能如下,但顺序并不固定,因为主线程和子线程是并发执行的:
Hello from the main thread!
Hello from a thread!
这里最容易被忽略的是 join()。它不是“可选优化”,而是线程生命周期管理里的关键一步。如果主线程在子线程还没完成时就直接退出,程序行为往往不可控。
线程函数参数怎么传
在线程入口函数中传参数并不复杂,但要搞清一个核心点:默认情况下,传入线程的参数会被复制。如果只是把值带进去处理,复制没问题;如果需要线程修改外部变量,就要明确用引用或指针,并且在共享访问场景下做好同步。

#include
#include

// 线程函数:接受int参数
void print_number(int num) {
    std::cout << "Thread received number: " << num << std::endl;
}

int main() {
    int value = 42;
    // 传递参数(自动复制)
    std::thread t(print_number, value);
    t.join();

    // 传递引用(需用std::ref包装)
    int ref_value = 100;
    std::thread t2(print_number, std::ref(ref_value));
    t2.join();

    return 0;
}
这个例子想说明的重点,不是“复制和引用哪个更高级”,而是线程边界会改变参数语义。很多看起来理所当然的传参方式,到了并发环境里就会带来变量副本、悬空引用或共享读写冲突的问题,因此在设计线程函数时,最好先确认数据所有权和修改范围。
多个线程并发执行
当任务可以拆分成多段并行处理时,
#include
#include
#include

void print_range(int start, int end) {
    for (int i = start; i <= end; ++i) {
        std::cout << "Thread " << std::this_thread::get_id() << ": " << i << std::endl;
    }
}

int main() {
    const int num_threads = 3;
    std::vector threads;  // 存储线程对象

    // 创建3个线程,分别处理不同范围
    for (int i = 0; i < num_threads; ++i) {
        int start = i * 10 + 1;
        int end = start + 9;
        threads.emplace_back(print_range, start, end);
    }

    // 等待所有线程结束
    for (auto& t : threads) {
        t.join();
    }

    return 0;
}
这种写法很适合演示“任务拆分后并发执行”的基本模式:先准备线程对象容器,再按任务范围逐个启动线程,最后统一 join() 回收。实际项目里,只要你的任务天然可以分段,例如批量处理、独立计算、日志分流等,就可以沿用类似结构。
pthread 实践:兼容老项目时依然有价值
虽然现代 C++ 更常用
基础用法:创建线程并等待结束
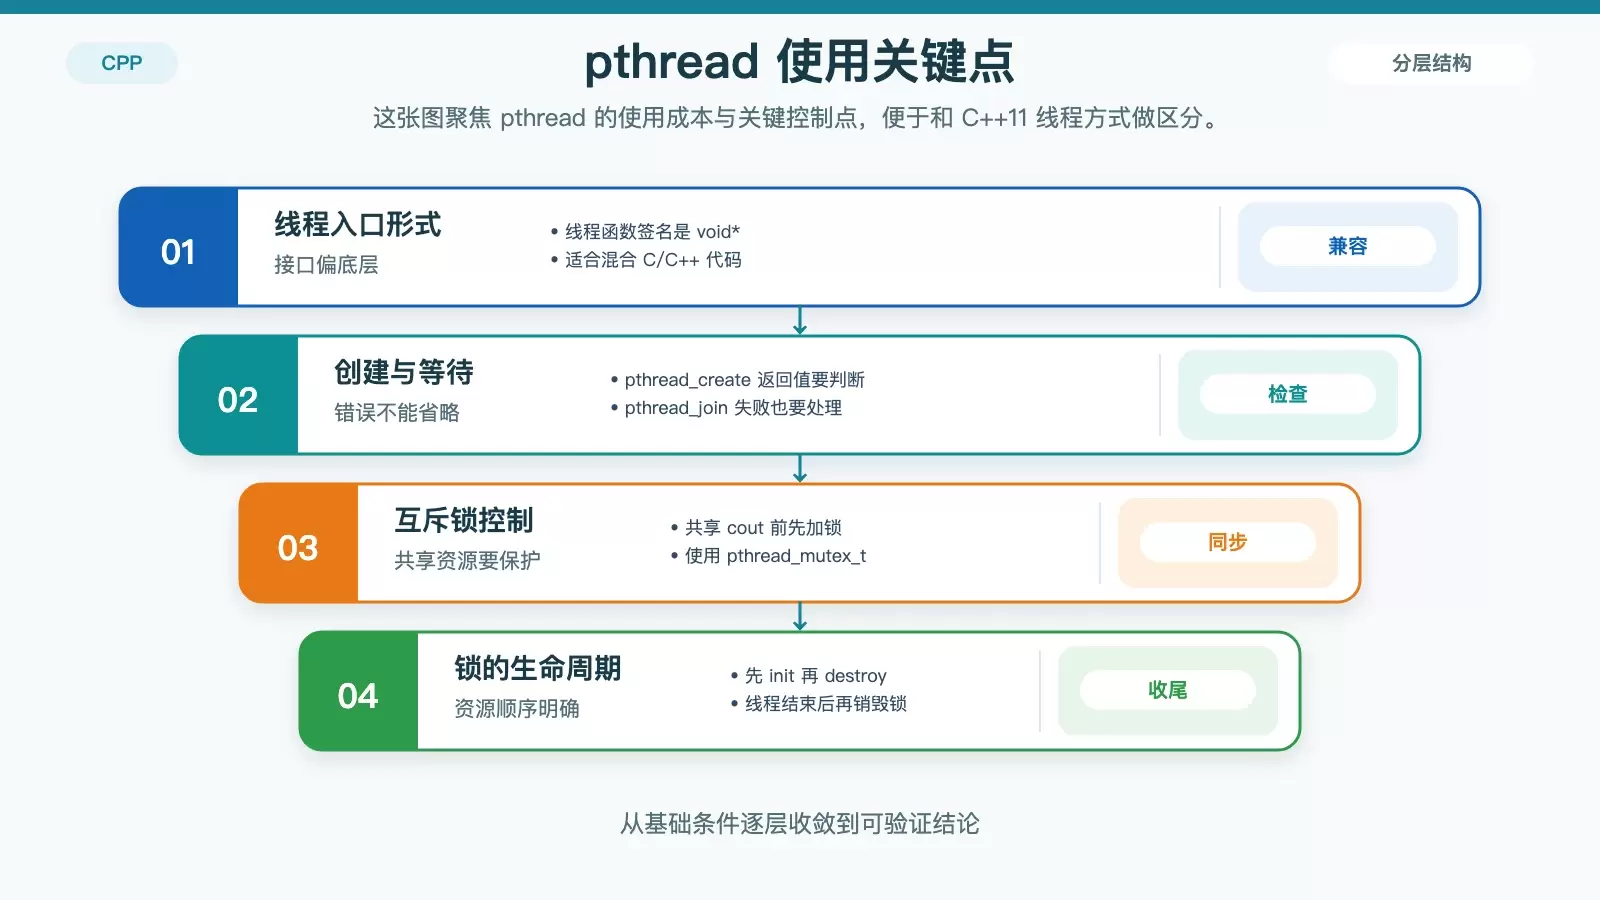
pthread 的线程函数签名与 C++11 不同,返回值和参数都采用 void* 形式。下面是一个最小可运行示例:
#include
#include

// 线程函数:返回void*,参数为void*
void* print_hello(void* arg) {
    std::cout << "Hello from a pthread!" << std::endl;
    return nullptr;
}

int main() {
    pthread_t thread_id;

    // 创建线程:参数依次为线程ID、属性(nullptr表示默认)、线程函数、参数
    if (pthread_create(&thread_id, nullptr, print_hello, nullptr) != 0) {
        std::cerr << "Failed to create thread!" << std::endl;
        return 1;
    }

    // 等待线程结束
    if (pthread_join(thread_id, nullptr) != 0) {
        std::cerr << "Failed to join thread!" << std::endl;
        return 1;
    }

    return 0;
}
对应的编译命令比较直接:
g++ -pthread pthread_example.cpp -o pthread_example和
共享资源访问:用互斥锁避免竞态
只要多个线程会同时读写共享资源,就不能只关心“线程开起来了没有”,还必须关注它们会不会互相踩数据。原文用 std::cout 作为示例,演示了 pthread 里最典型的同步方式:pthread_mutex_t。
#include
#include

pthread_mutex_t mutex;  // 互斥锁

void* print_numbers(void* arg) {
    int id = *((int*)arg);
    for (int i = 0; i < 3; ++i) {
        pthread_mutex_lock(&mutex);    // 加锁
        std::cout << "Thread " << id << ": " << i << std::endl;
        pthread_mutex_unlock(&mutex);  // 解锁
    }
    return nullptr;
}

int main() {
    pthread_mutex_init(&mutex, nullptr);  // 初始化互斥锁

    int ids[2] = {1, 2};
    pthread_t threads[2];

    // 创建2个线程
    for (int i = 0; i < 2; ++i) {
        if (pthread_create(&threads[i], nullptr, print_numbers, &ids[i]) != 0) {
            std::cerr << "Failed to create thread " << i << std::endl;
            return 1;
        }
    }

    // 等待线程结束
    for (int i = 0; i < 2; ++i) {
        pthread_join(threads[i], nullptr);
    }

    pthread_mutex_destroy(&mutex);  // 销毁互斥锁
    return 0;
}
这段代码反映了 pthread 开发里一个很重要的习惯:同步对象的初始化、加锁、解锁和销毁都需要显式处理。也正因为如此,pthread 更适合那些已经有明确并发控制框架的老代码,而不是刚起步的新项目。
写 Debian C++ 多线程时,最容易踩的几个点
无论你最终选择
同步不能省
只要线程之间会访问共享资源,例如全局变量、文件句柄、输出流或缓存对象,就必须使用同步机制。原文提到的典型工具包括 std::mutex、pthread_mutex_t 以及条件变量。没有这些保护时,竞态条件往往不是“偶尔出错”,而是出现难以复现、难以排查的随机故障。
线程生命周期要收干净
多线程程序里,主线程并不天然知道子线程何时完成,所以必须显式回收。对 C++11 线程来说,常见手段是 join() 或 detach();对 pthread 来说,则要用 pthread_join 等待线程结束。若线程还在运行,主流程却已经退出,崩溃、资源泄漏或未定义行为都可能出现。
编译选项要和线程模型对应
很多“代码没问题却编不过”的情况,其实都出在编译参数。使用 C++11 线程时,需要:
g++ -std=c++11 -pthread multithreading_example.cpp -o multithreading_example使用 pthread 示例时,需要:
g++ -pthread pthread_example.cpp -o pthread_example-pthread 不能漏,因为它不只是链接库的问题,还会影响编译期和运行期的线程支持行为。
频繁建线程不一定划算
线程并不是免费资源。创建和销毁线程本身有开销,如果业务里是大量短任务、而且不断重复开线程,那么性能未必比串行更好。原文给出的建议是使用线程池,例如 boost::asio::thread_pool,把线程复用起来,减少频繁创建和销毁带来的成本。
换句话说,多线程优化的第一步不是“线程越多越快”,而是先确认任务是否适合并发、共享数据是否可控,以及线程复用是否值得引入。把这些条件想清楚,比单纯把循环丢进多个线程更重要。
怎么选:新项目优先
如果把全文压缩成一个可执行结论,其实很明确:
- 新写的 C++ 项目,优先使用 C++11 的
- 需要兼容 C 代码、POSIX 接口或维护历史工程时,pthread 依然是稳妥方案。
- 无论选哪种方式,都要同时处理好同步、生命周期和编译选项三个基础问题。
在 Debian 上做 C++ 多线程,真正决定代码质量的,往往不是“用哪套 API 更时髦”,而是线程是否收得住、共享资源是否锁得对、并发是否真的解决了问题。先把这几件事做好,再往线程池、条件变量或更复杂的并发模型扩展,会顺很多。


