很多人把“用了 Entity Framework”直接等同于“不会有 SQL 注入”,这其实只对了一半。EF Core 确实会在常规 LINQ 查询里帮你做参数化,但只要你自己开始拼 SQL、动态组装字段名,或者把表达式先转成字符串,这层保护就可能失效。本文按常见使用场景拆开说明:哪些写法默认安全,哪些 API 需要手动参数化,以及遇到表名、字段名、ORDER BY 这类结构性输入时该怎么处理,方便你快速判断一段 EF 代码到底靠不靠谱。
Where 查询为什么默认安全
在 EF Core 里,Where、Select 这类 LINQ 查询默认具备防注入能力,核心原因是表达式树在翻译成 SQL 时,会把变量转换成数据库参数,而不是直接把变量内容拼到 SQL 字符串里。

比如下面这段代码:
_context.Users.Where(u => u.Email == email)数据库真正接收到的通常不是把 email 原样写进语句,而是类似这样的形式:
WHERE [Email] = @p0这意味着,就算有人传入 admin' OR 1=1 --,数据库也只会把它当成一个普通字符串值去比对,而不是把它解释成可执行的 SQL 片段。
不过,这种安全性有个前提:你不能自己把 EF 的参数化机制绕开。下面几类写法都要避免:
- 不要调用
.ToString()或Expression.ToString(),把表达式转成字符串后再交给 EF。 - 不要用反射动态取字段名,例如
u.GetType().GetProperty(fieldName),这会把用户输入推向“代码结构”的位置。 - 避免手动拼接表达式树再编译成
Func<>。这样做可能让查询退化为内存过滤;如果字段名来自用户输入,还会演变成列名注入问题。
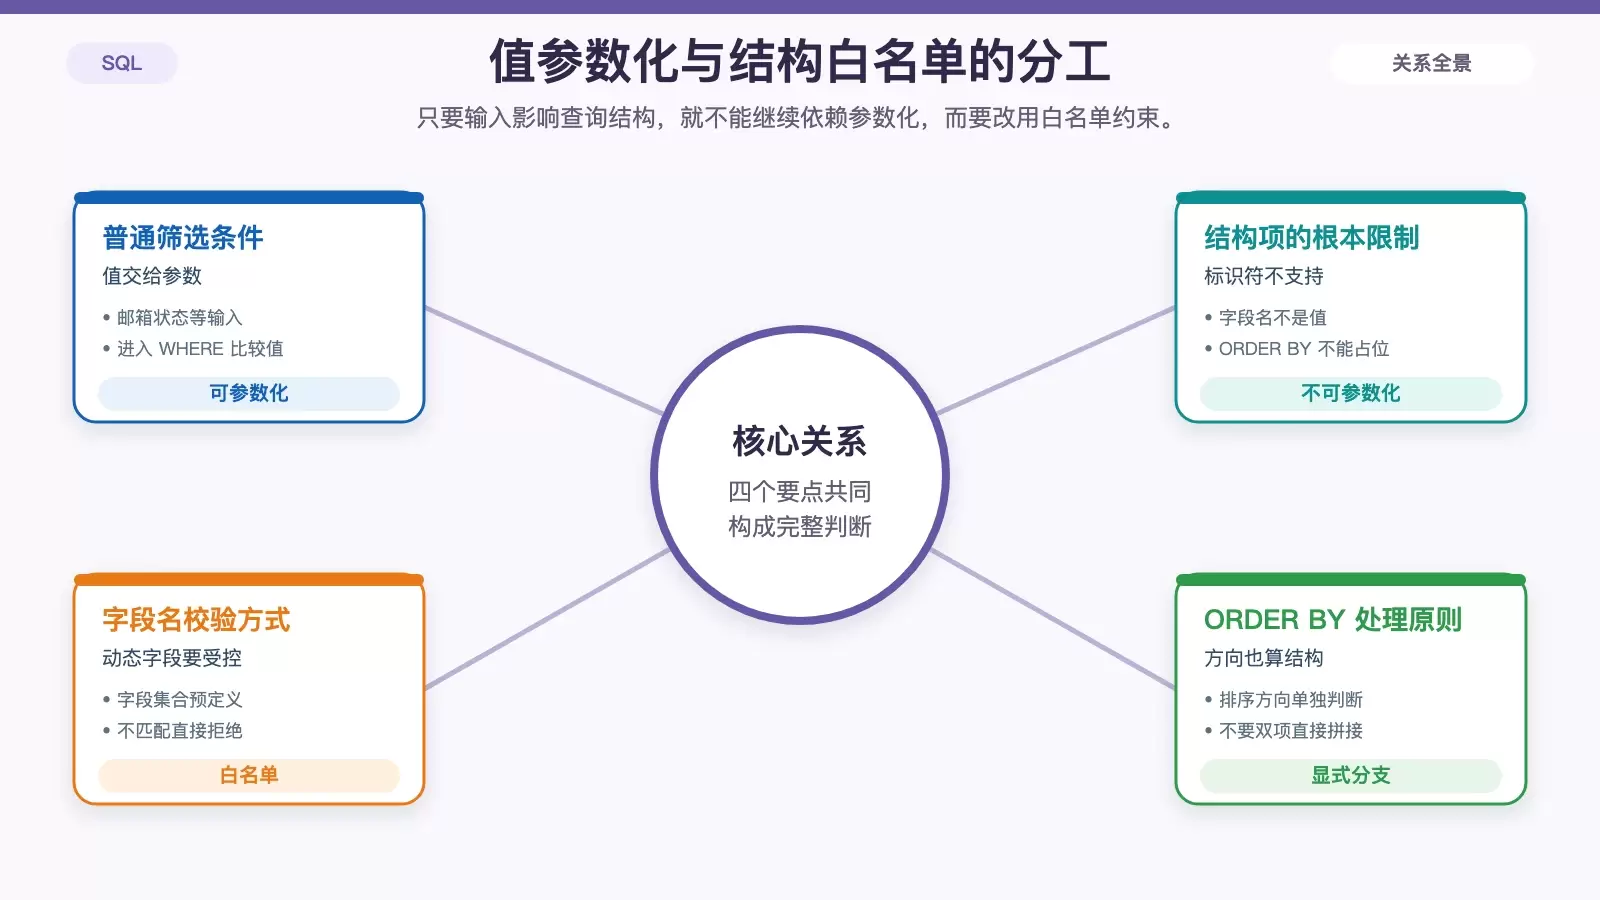
判断标准可以很直接:如果用户输入只是作为“值”参与比较,EF 通常能帮你安全处理;如果用户输入开始影响“字段、表达式、查询结构”,就不能再指望默认保护了。
FromSqlRaw 和 ExecuteSqlRaw 为什么必须手动参数化
一旦进入原生 SQL 场景,规则就变了。FromSqlRaw 和 ExecuteSqlRaw 不会替你自动参数化传入的整段字符串,它们会直接执行你给出的 SQL 内容。
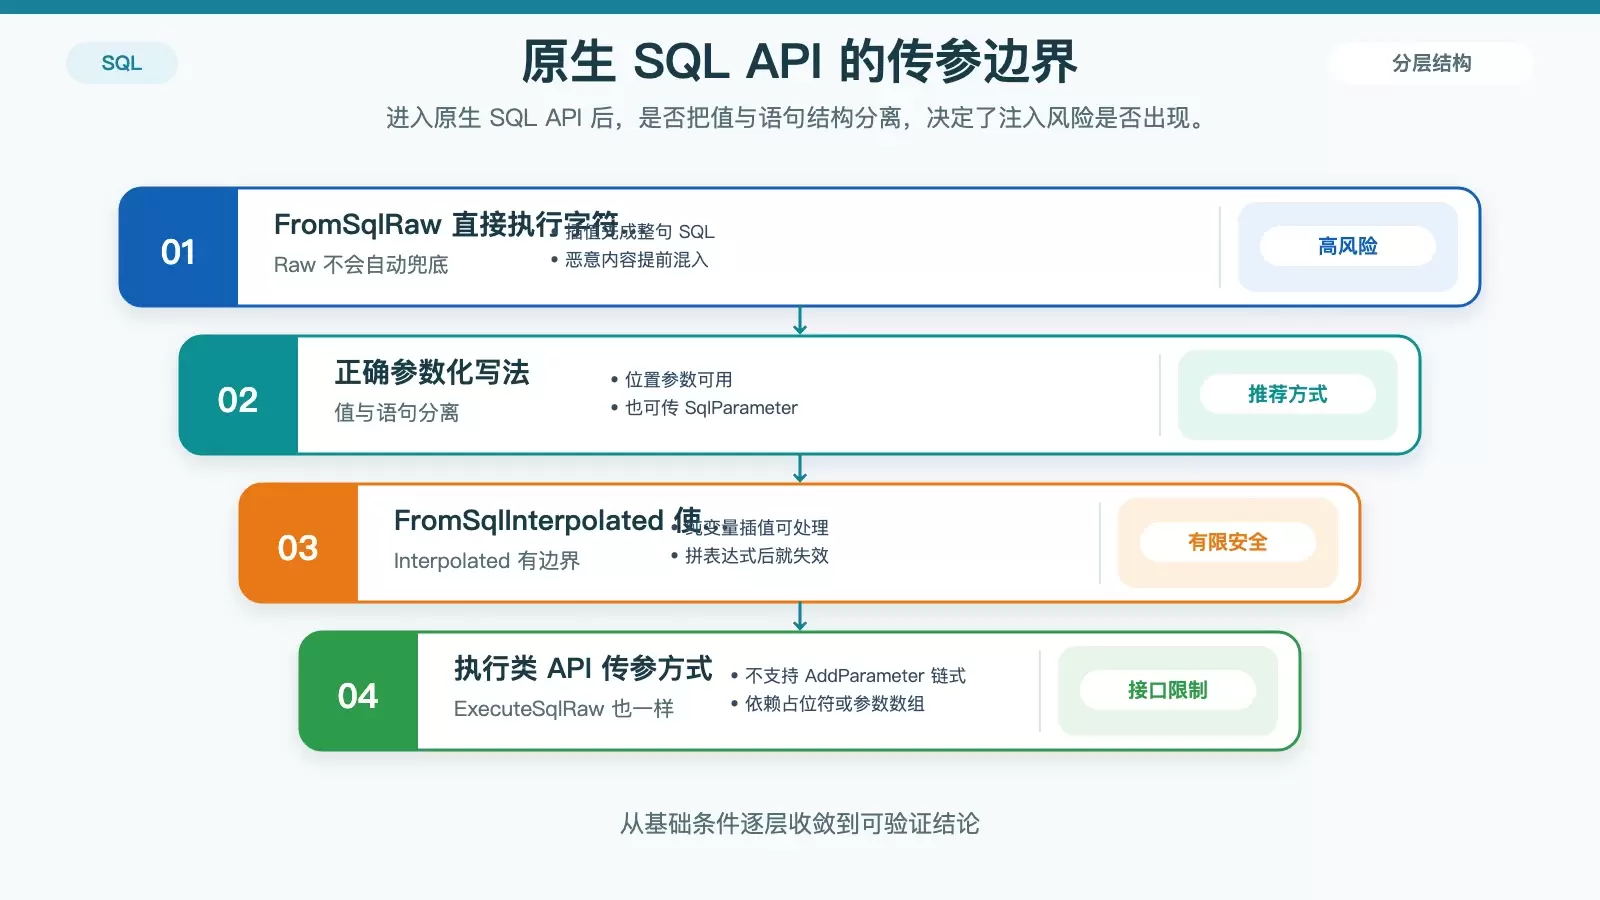
例如下面这种写法就是典型高风险:
FromSqlRaw($"SELECT * FROM Users WHERE Name = '{name}'")问题不在数据库,而是在 C# 这一层:在 EF 收到字符串之前,name 就已经被插进 SQL 语句里了。只要输入可控,恶意内容也会一起进入最终执行的语句。
这类 API 的正确做法只有一个原则:占位符和参数分离。
可用的安全写法
- 位置参数:
.FromSqlRaw("WHERE Status = {0} AND CreatedAt > {1}", "Active", DateTime.UtcNow.AddDays(-7)) - 命名参数 +
SqlParameter:.FromSqlRaw("WHERE Name = @name", new SqlParameter("@name", name)) ExecuteSqlRaw也一样,不能依赖链式AddParameter,而是要用占位符或SqlParameter数组传参。
FromSqlInterpolated 也有使用边界
FromSqlInterpolated 不是“所有插值都安全”。它只对纯变量插值的场景有效,比如 {name} 这种值变量。
下面这些写法仍然不安全:
{name + "%"}{"Name = '" + name + "'"}
原因很简单:字符串在 C# 层就已经拼好了,EF 此时拿到的是结果,不是原始变量,自然也就来不及做参数化处理。
所以这里不要只看 API 名字,而要看一个更本质的问题:EF 接收到的是“值”,还是已经拼好的 SQL 片段。如果是后者,就谈不上防注入。
表名、字段名和 ORDER BY 为什么必须走白名单
很多开发者在参数化上已经足够谨慎,但还是会在动态排序、动态表名这类需求上出问题。原因在于:数据库引擎本身并不支持参数化标识符,也就是表名、字段名、排序字段这类“结构性内容”。
例如你试图这样写:
ORDER BY @sortField即便传入了 SqlParameter,数据库也不会把它理解成列名,而更接近于:
ORDER BY 'Email'结果通常是排序失效,或者直接报错。更重要的是,这说明“结构”不能靠参数化解决。
因此,动态结构的处理方式必须换成白名单校验。
字段名和排序方向的安全处理方式
- 字段名白名单:
new[] { "Name", "Email", "CreatedAt" }.Contains(sortField),不在允许列表里就直接拒绝。 - 排序方向显式判断:
sortDir == "desc" "ORDER BY Name DESC" : "ORDER BY Name ASC",不要直接拼ORDER BY {sortField} {sortDir}。 - 表名同理,禁止通过反射、配置文件或用户输入动态构造
FROM {tableName}。 - 不要用
string.Format或Replace自己“转义”字段名,这类规则很容易被绕过,可靠性不够。
这部分最关键的区分是:值可以参数化,结构必须受控。两者的防护方式完全不同,不能混着处理。
批量操作和迁移脚本里,哪些地方也可能出问题
除了日常查询,批量更新和迁移脚本也是容易被忽略的区域。
例如 EntityFramework Plus 的批量更新:
.Update(p => new Product { Price = p.Price * 1.1m })这类写法内部通常仍然使用参数化,本身是安全的。但要注意,风险并不会因为“最终调用的是批量更新”就自动消失。如果你在进入批量操作之前,已经先手动拼了一段 SQL 字符串,那么漏洞仍然存在。
迁移脚本中的原生 SQL 同样要按相同原则处理。比如:
context.Database.ExecuteSqlCommand("UPDATE Posts SET Rating = 5 WHERE Author = @author", new SqlParameter("@author", userSuppliedAuthor))这里真正起保护作用的仍然是参数化,而不是“代码写在迁移里”这件事本身。
如果迁移中需要动态表名或字段名,也不能放松要求,还是得用白名单控制。EF 的迁移 API 本身就明确不适合直接处理不受信任的输入。
一条实用判断规则:先分清“值”还是“结构”
很多注入问题并不是因为没听说过参数化,而是因为场景判断错了。写 EF 代码时,最值得养成的习惯是每次遇到动态拼接都先问一句:这段内容是不是用户可控?如果是,它属于“值”还是“结构”?
- 如果是值,例如邮箱、用户名、时间范围、状态值,就应该走参数化。
- 如果是结构,例如表名、字段名、排序字段、排序方向,就必须走白名单。
- 如果一段代码里把值和结构混在一起拼接,通常就已经进入高风险区。
归根到底,安全不在于“用了 EF 就万事大吉”,而在于你有没有保住 EF 原本的参数化边界。能让 EF 接住的值,就不要提前拼成字符串;必须动态控制的结构,就明确限制在可选集合里。把这条边界守住,EF 才真能发挥它在防 SQL 注入上的价值。









