Rust 本身已经尽量把内存安全和运行效率兼顾起来,但在 Debian 环境里,程序真实的内存表现仍然会受到编译参数、分配器选择、数据结构、并发模型以及系统配置的共同影响。想把优化做得有效,不能只盯着某一个点,而是要先分清瓶颈在构建产物、运行时分配,还是系统层资源竞争。下面就按“先低成本、再深入定位”的顺序,把几类常用且能落地的优化策略整理出来。
编译与构建参数先做对
如果还在默认调试配置下评估内存表现,结论通常不具备参考价值。Rust 程序上线前,Release 模式几乎是基础要求,最直接的做法就是:
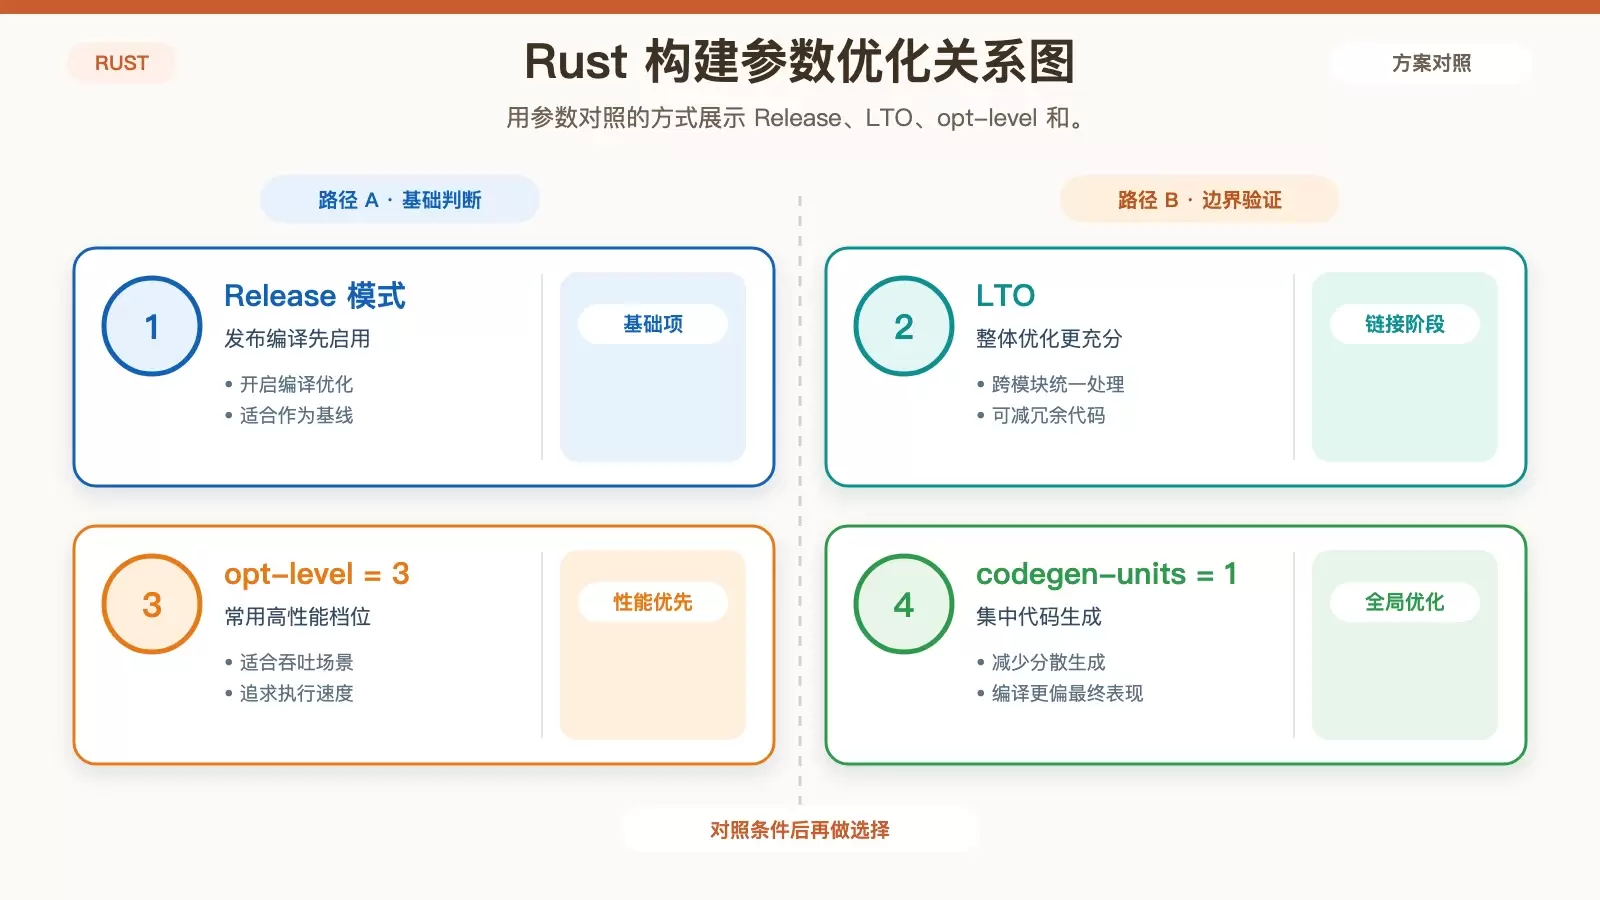
cargo build --release这一步会让编译器开启更积极的优化策略,包括内联、死代码消除等,通常能同时改善性能和内存占用。对于很多服务或命令行程序来说,仅切到 Release,二进制体积和运行时行为就会明显稳定下来。
如果还想继续压缩冗余代码,可以在 Cargo.toml 的 [profile.release] 中打开链接时优化:
[profile.release]
lto = true
LTO 的价值在于跨模块统一优化。原本分散在不同 crate 或编译单元里的代码,会在链接阶段一起分析,因此更容易去掉重复路径,减少不必要的内存开销。
除此之外,优化等级也要按目标来选,而不是一味追求最高性能:
opt-level = 3:更适合优先追求吞吐和执行速度的场景。opt-level = "z":更适合在意二进制体积、缓存占用或部署空间的场景。
还有一个经常被忽略的参数是 codegen-units。把它设为 1,编译器会减少分散生成代码的情况,从而给全局优化更多空间:
[profile.release]
lto = true
codegen-units = 1
代价是编译时间可能变长,但如果你关注的是最终运行表现,这通常是值得的。对 Debian 上常驻运行的 Rust 服务来说,这类构建阶段优化往往是最先该做、收益也最稳定的一步。
分配器与数据结构决定运行时开销
什么时候考虑替换默认分配器
Rust 默认使用系统分配器,它在通用场景下没有问题,但在多线程、高频分配回收或长时间运行的服务中,未必是最合适的选择。一个常见替代方案是 jemalloc,它更擅长处理碎片控制和分配效率。
接入方式并不复杂,先添加依赖:
jemallocator = "0.3"然后在代码中声明全局分配器:
use jemallocator::Jemalloc;
#[global_allocator]
static GLOBAL: Jemalloc = Jemalloc;
如果程序本身有比较明显的堆分配压力,还可以配合环境变量继续调优:
export MALLOC_CONF="background_thread:true,dirty_decay_ms:10000"这里的含义很明确:开启后台线程做回收,并适当延长脏页回收时间,让分配器在高压场景下更从容,避免过于频繁地做回收动作。
数据结构选型比“微调”更重要
很多内存问题并不是分配器本身造成的,而是容器选错了。比如需要频繁在两端插入、删除元素时,VecDeque 通常比 Vec 更合适,因为它的 push_front 和 pop_back 都是 O(1) 操作。若仍坚持使用 Vec,就容易在数据移动上付出额外成本。
查找场景也一样。如果目标是更快地按键访问数据,HashMap 平均 O(1) 的查找复杂度,一般会优于 BTreeMap 的 O(log n)。但如果你需要有序遍历或范围查询,再考虑 BTreeMap 才更合理。
对小规模数组,还有两个很实用的选择:smallvec 和 arrayvec。当元素数量较少,例如不超过 32 个时,数据可以直接放在栈上,避免堆分配。这在高频函数调用、短生命周期对象很多的场景里,收益通常很直接。
这类优化的判断标准很简单:如果你的程序主要时间花在“存、取、挪”,那数据结构和分配器往往比局部语法层面的优化更有价值。
减少不必要的分配与拷贝
在 Rust 里,分配本身并不算低效,但频率一高,成本仍然会快速累积。尤其在请求处理、文本拼接、批量数据转换这类路径上,减少分配次数几乎总是有意义的。
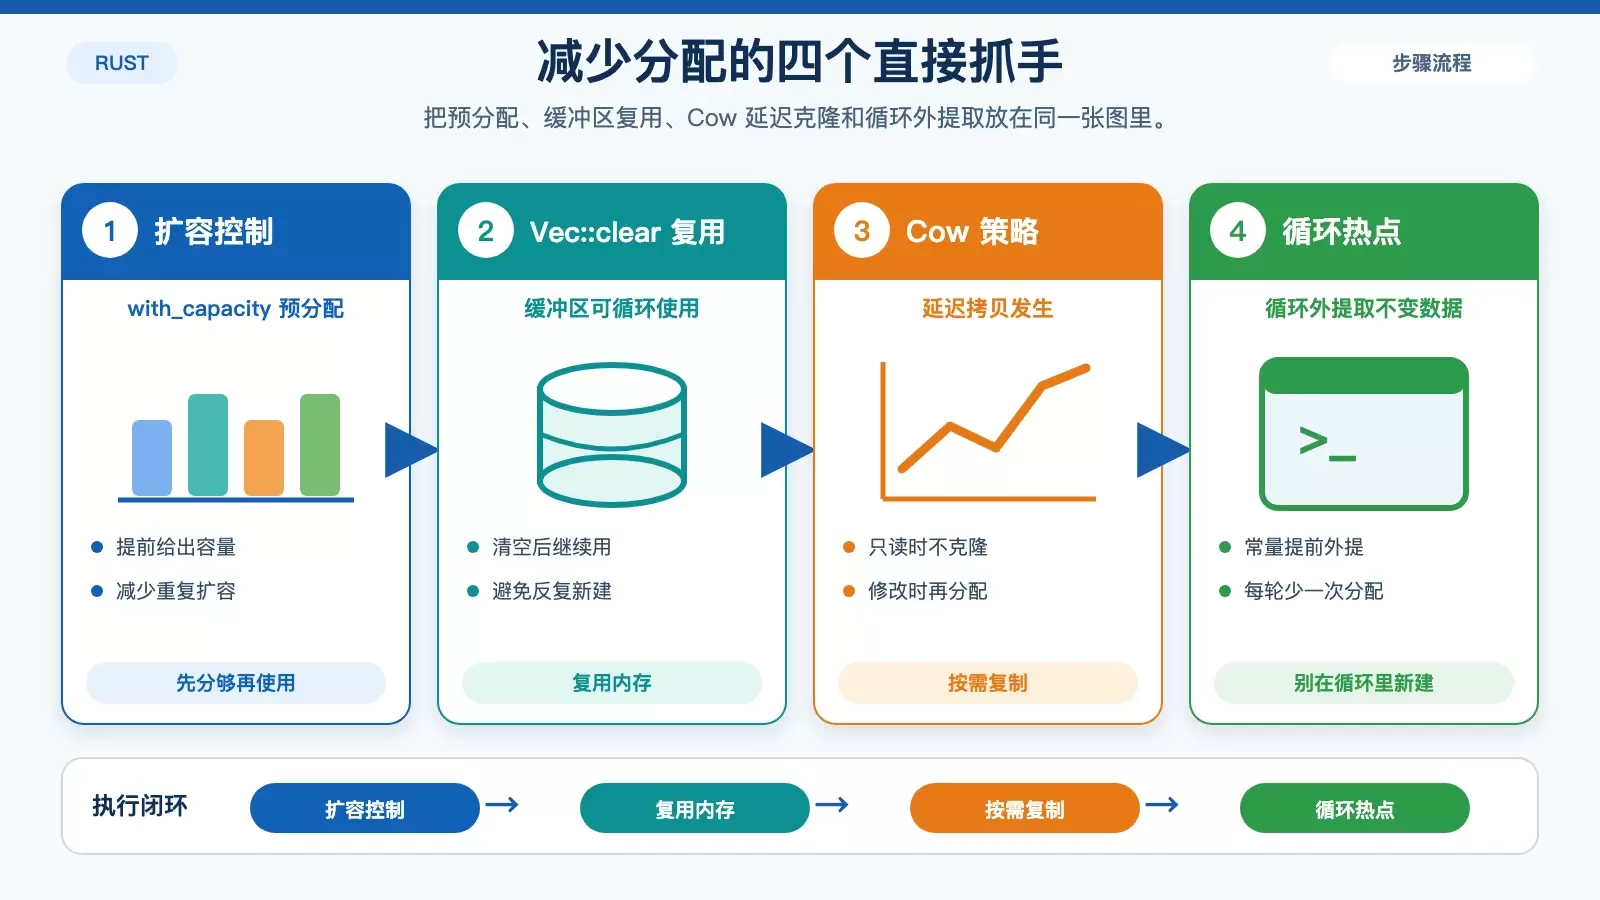
最常见的手段是预分配。已知大致容量时,直接使用 Vec::with_capacity 或 String::with_capacity,可以避免容器在增长过程中多次扩容:
Vec::with_capacity(...)
String::with_capacity(...)
如果一个缓冲区会重复使用,那么与其反复新建,不如复用已有对象。像 Vec::clear() 这种方式就很适合清空后继续使用同一块已分配的内存;对象创建和销毁特别频繁时,也可以考虑对象池,例如 ObjectPool。
另一个容易被忽视的工具是 Cow。当一段数据大多数时候只是读取,只有少数情况下才会被修改时,Cow 或 Cow<[T]> 可以把克隆动作延后到真正发生写入的那一刻。这样做的重点不是语法“高级”,而是少做无意义的复制。
循环内分配同样是常见陷阱。配置项、常量字符串、可复用的中间缓冲区,如果每次迭代都重新创建,最终会形成很稳定的额外分配压力。把这些不变对象提前移到循环外,通常就是一笔立竿见影的优化。
这一节的核心思路可以概括为一句话:能复用就复用,能延迟复制就延迟复制,能提前知道容量就不要让容器自己一路试错扩容。
并发策略与分析工具要配合看
并行不是越多越好
在 Debian 上运行 Rust 程序,通常意味着你手里至少有多核 CPU 可用。对于数据密集型任务,Rayon 确实是一个很省事的并行化工具,例如:
data.par_iter().sum()这种写法能很快把顺序迭代改造成并行执行,适合计算密集、任务之间相对独立的场景。不过并发一旦引入,也会带来新的内存和调度问题,尤其是锁竞争。
如果多个线程频繁争用同一把锁,吞吐未必提升,反而可能让等待和上下文切换增加,连带放大内存使用抖动。因此,能用无锁数据结构时,可以优先考虑例如 AtomicUsize;如果业务更适合任务解耦,消息传递方式如 std::sync::mpsc 往往比共享可变状态更稳。
先定位热点,再决定动哪一层
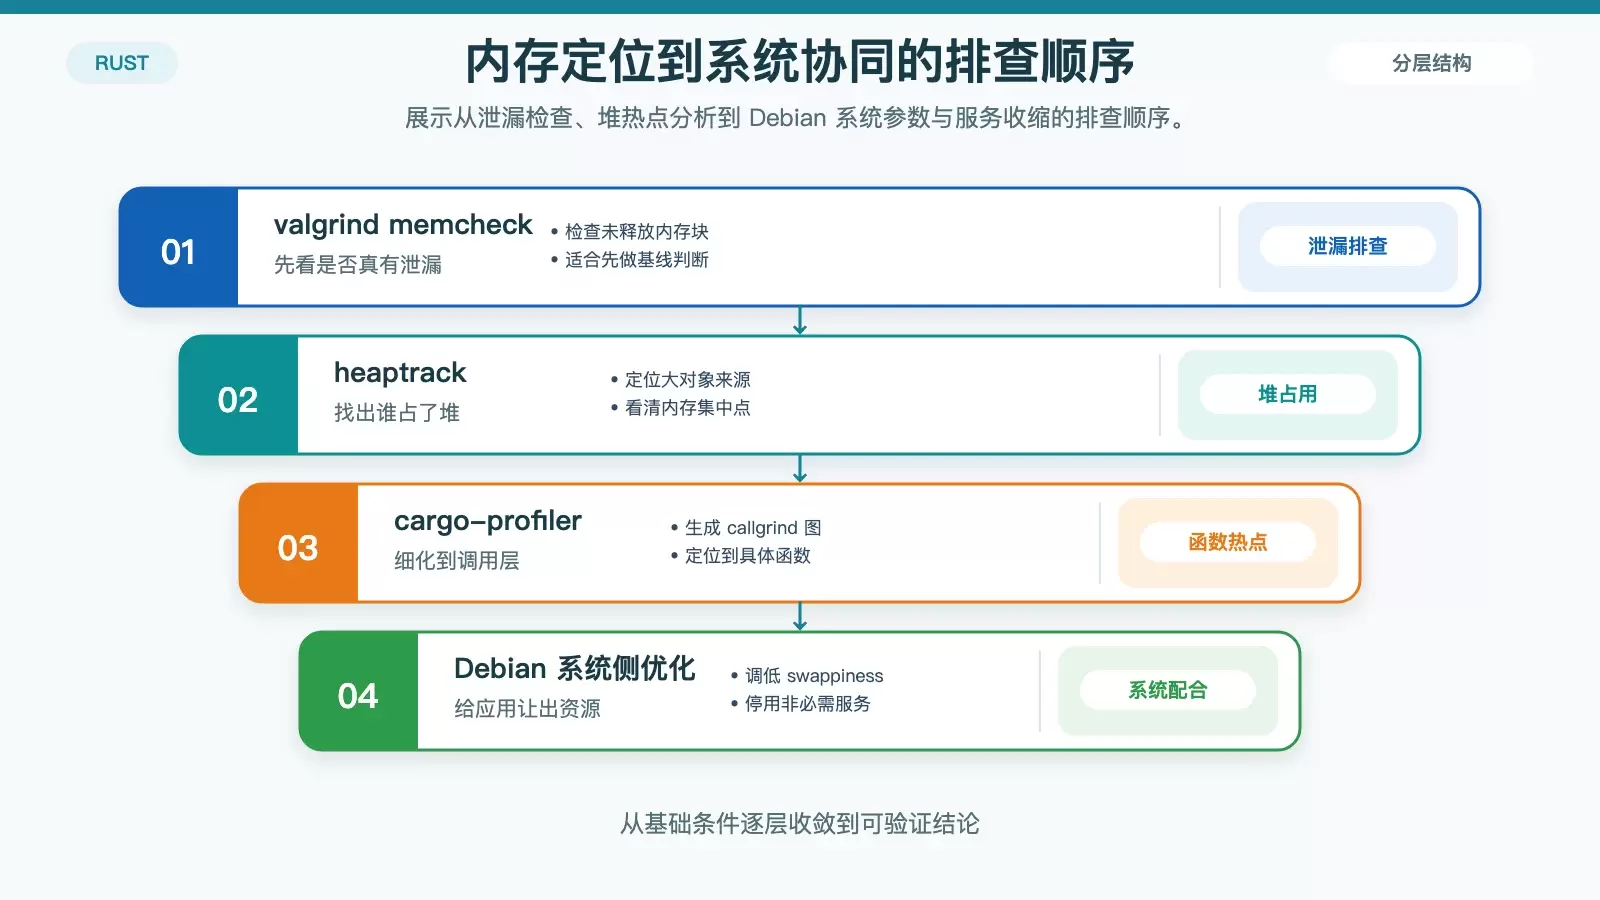
优化最怕“凭感觉”。如果不先测量,就很容易把时间花在收益有限的地方。针对内存问题,Debian 环境下常见的几类工具已经足够覆盖大多数排查需求。
检查泄漏时,可以直接使用 valgrind:
valgrind --tool=memcheck --leak-check=full target/release/your_program它适合找出未释放的内存块,尤其在怀疑 FFI、长生命周期缓存或资源管理路径有问题时很有帮助。
如果你更关心堆内存是被谁大量占用,可以用 heaptrack:
heaptrack target/release/your_program它会生成堆使用报告,便于你看到是哪个对象、哪段代码在持续放大内存占用。
需要进一步看函数级热点时,可以安装 cargo-profiler:
cargo install cargo-profiler它能生成 callgrind 调用图,帮助你把问题定位到具体函数,而不是停留在“程序整体内存高”的笼统判断上。
一个更稳妥的顺序是:先确认有没有泄漏,再确认堆占用集中在哪里,最后再决定是调整分配器、改数据结构,还是重写并发路径。这样做,优化动作才有依据。
Debian 层面的配合优化
应用层已经调得差不多时,系统层配置也会影响最终结果。Debian 本身不是瓶颈制造者,但如果默认配置和服务占用没有收拾好,应用可用内存还是会被挤压。
先看可直接处理的部分。清理系统缓存可以释放 APT 占用的空间:
apt-get clean这一步不直接改变 Rust 代码的行为,但能减少系统层无谓占用,特别是在磁盘和内存资源都比较紧张的环境中更有意义。
接着可以检查虚拟内存策略。通过调整 /etc/sysctl.conf 里的 vm.swappiness,例如设为 10,可以降低内核过早把内存换出到 Swap 的倾向。对常驻型 Rust 服务来说,这通常比保守默认值更友好,因为它能让物理内存优先服务活跃进程。
最后别忽略后台服务。可以先列出当前运行中的服务:
systemctl list-units --type service如果机器是专门跑某个 Rust 服务的,像 bluetooth、cups 这类并非必需的服务,停掉之后就能把一部分系统资源让出来。这里不只是“节省一点内存”那么简单,更重要的是减少资源竞争,让你的应用表现更稳定。
总的来看,Debian 上的 Rust 内存优化没有单一银弹。更可靠的做法是先用 cargo build --release、LTO、合理容器和预分配这些低成本手段拿到第一轮收益,再通过 valgrind、heaptrack 和 cargo-profiler 定位热点,最后视情况把优化推进到分配器、并发模型和系统配置层。这样做,既能控制改动成本,也更容易确认每一步到底带来了多少实际收益。


