在 Debian 下搭 Python 机器学习环境,很多人卡的并不是命令本身,而是不清楚该先选 pip 还是 conda,以及哪些步骤是必须做、哪些只是按需处理。本文把两套安装路径拆开说明,再补上 Python、权限、CUDA 支持等容易踩坑的地方,方便你根据项目规模和依赖复杂度快速判断用哪一种方案。
先选安装方式:pip 还是 conda
如果你已经有可用的 Python 环境,且只是想在 Debian 上尽快装好常见机器学习库,pip 通常是最直接的办法,命令简单,上手成本也低。
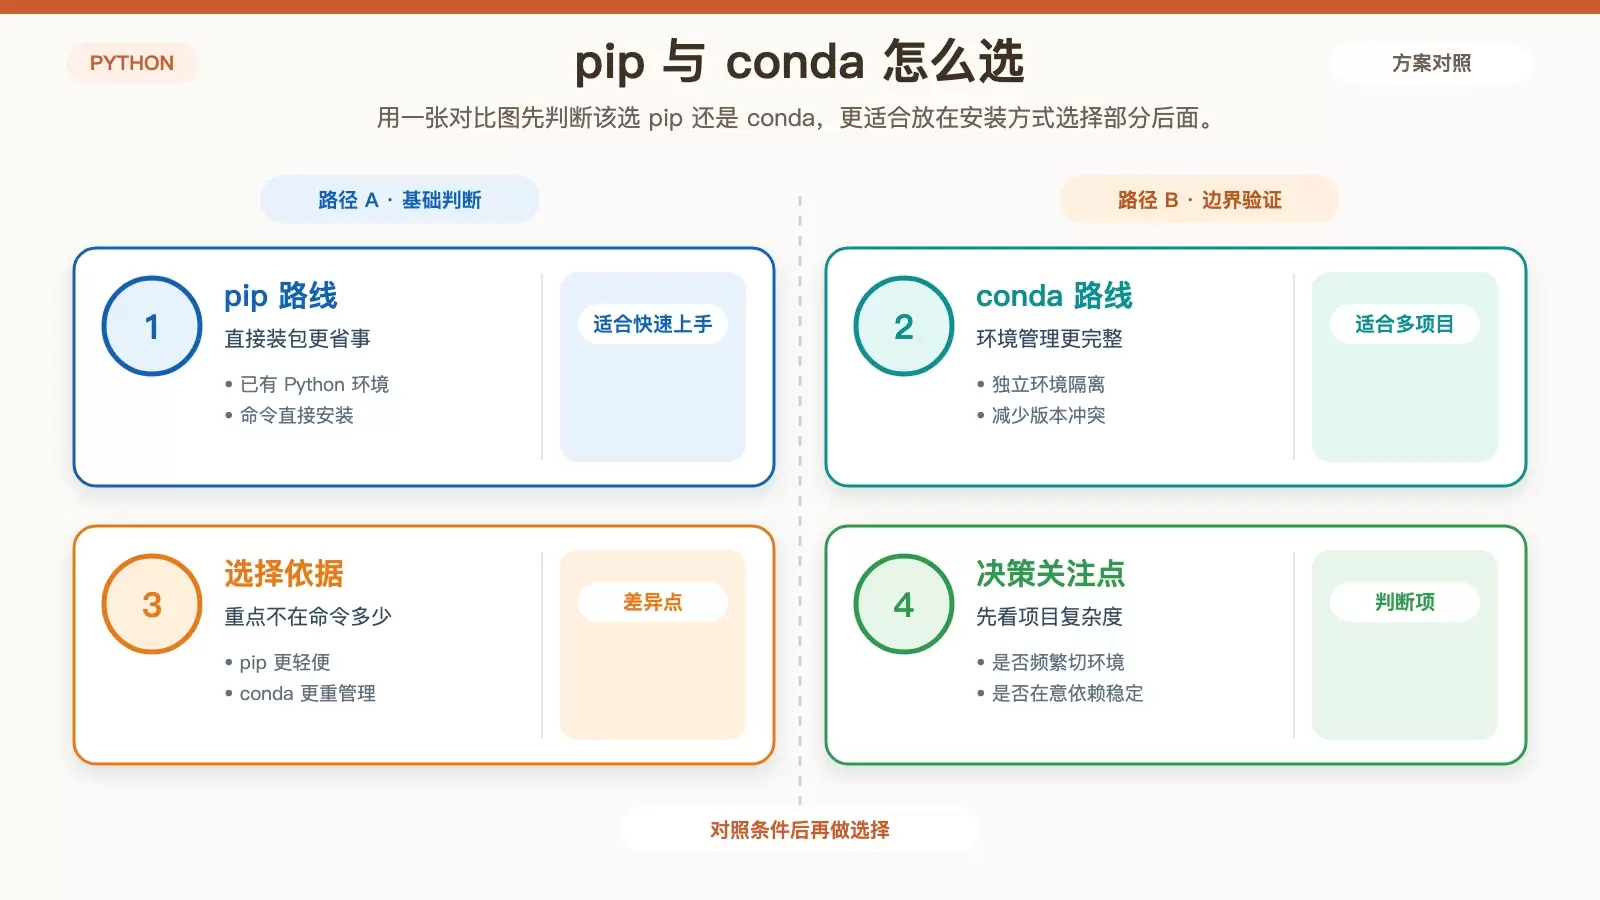
如果你更在意环境隔离,希望不同项目之间不要互相影响,或者后续还要频繁切换 Python 版本与依赖组合,那么 conda 会更合适。它除了装包,也能顺手把环境管理这件事一起解决。
两种方式都能完成安装,重点不是“哪一个绝对更好”,而是你的场景更偏向快速部署,还是更偏向稳定管理。
用 pip 安装常用机器学习库
对大多数已经熟悉 Python 包管理的用户来说,pip 是最省事的一条路径。开始前,可以先把 pip 升级到较新的版本,这一步不是强制,但能减少一部分安装兼容问题:
pip install --upgrade pip接下来就可以按需安装常见库。原文给出的几组核心命令如下,适合直接使用:
- NumPy:
pip install numpy - Pandas:
pip install pandas - Scikit-learn:
pip install scikit-learn - TensorFlow(需要Python 3):
pip install tensorflow - PyTorch(需要Python 3):
pip install torch torchvision torchaudio
这套方式的优点很明确:安装路径短,适合单机快速准备实验环境。像 tensorflow 和 torch 这样的深度学习库,执行命令后会自动拉取对应依赖,通常不需要再手工补装 Python 层面的关联包。
不过,pip 更适合你已经知道自己在装什么、环境里还有什么的情况。若系统里同时存在多个项目、多个 Python 版本,后面就更需要自己额外留意依赖冲突。
用 conda 管理环境并安装库
如果你希望把项目依赖隔离开,conda 会更稳妥一些。使用前需要先安装 Miniconda 或 Anaconda。两者区别也比较直接:

- Miniconda:只包含
conda和 Python,体积更轻。 - Anaconda:预装了较多科学计算相关库,更适合希望开箱即用的场景。
装好后,比较推荐先创建独立环境,再往里面装机器学习库。这样做的主要好处,是把不同项目的依赖版本隔离开,减少后续升级或切换库版本时互相影响的概率。
conda create -n myenv python=3.x这里 myenv 是环境名,python=3.x 需要替换成你实际要用的 Python 版本。创建完成后,先激活环境:
conda activate myenv然后再执行安装命令:
- NumPy:
conda install numpy - Pandas:
conda install pandas - Scikit-learn:
conda install scikit-learn - TensorFlow:
conda install tensorflow - PyTorch:
conda install pytorch torchvision torchaudio cudatoolkit=11.3 -c pytorch
这套命令里,PyTorch 示例带上了 cudatoolkit=11.3 和 -c pytorch,也就是从 PyTorch 对应渠道安装带 CUDA 支持的版本。如果你不打算使用 GPU 加速,可以去掉 cudatoolkit 这一部分,简化安装。
和 pip 相比,conda 的优势不只在安装库本身,而在于环境生命周期更容易管理。对于需要长期维护、多人协作,或者同一台 Debian 机器上跑多个实验项目的情况,它通常更省心。
安装前后要注意的几件事
无论你最终选哪种方式,系统里都应该先有 Python 和 pip。如果 Debian 环境还是比较干净,可以先执行下面的命令补齐基础组件:
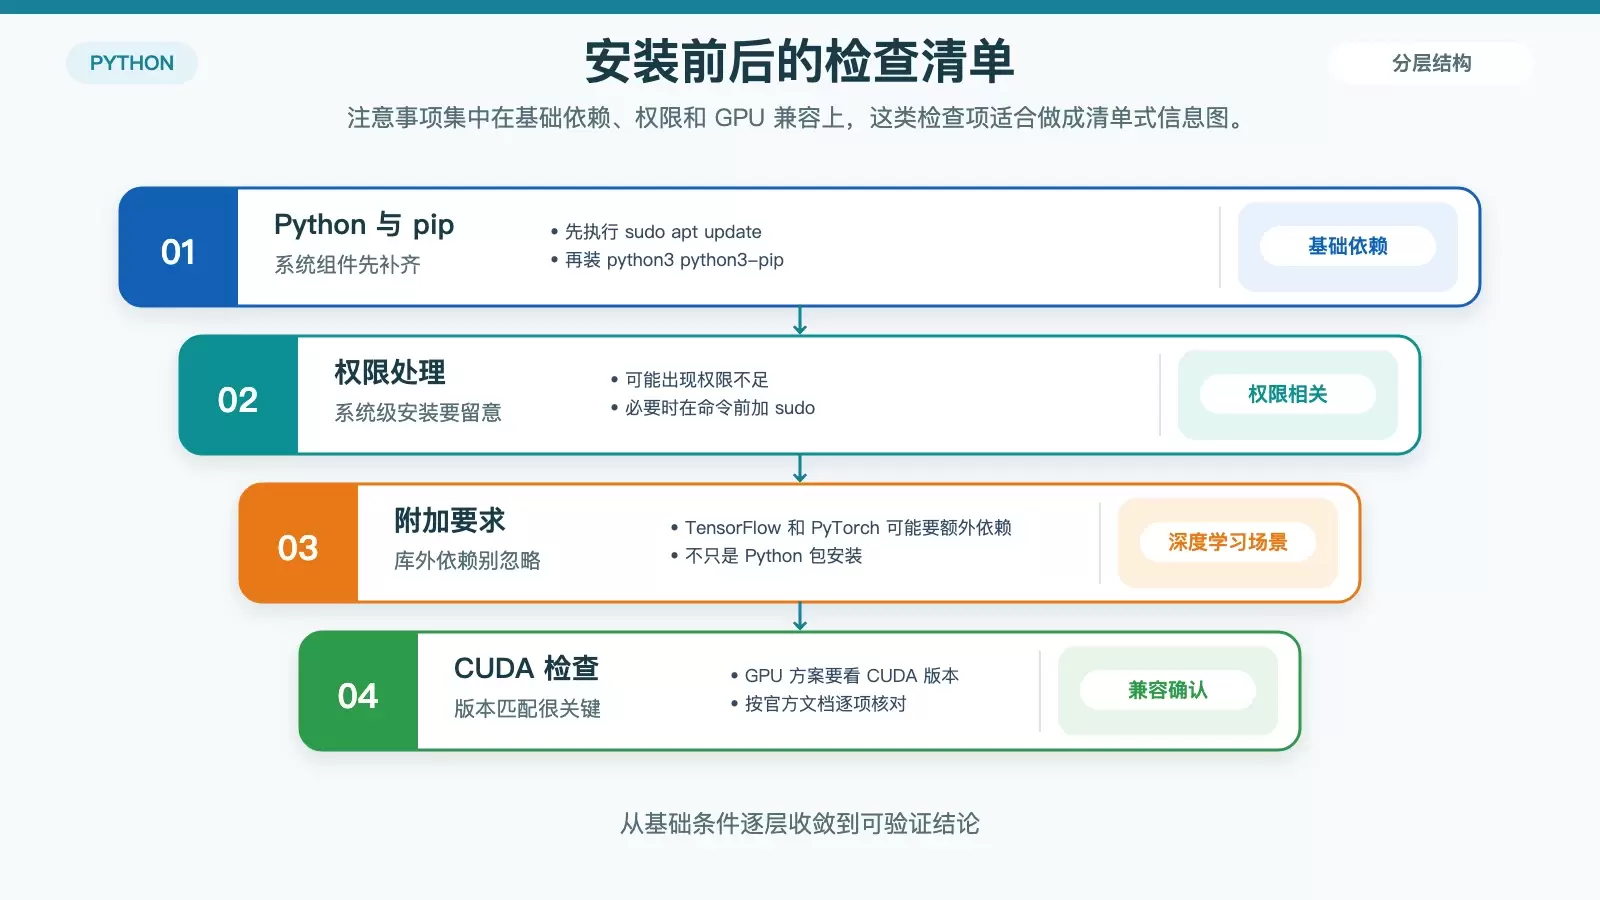
sudo apt update
sudo apt install python3 python3-pip
如果安装过程中出现权限不足,可以按原文建议,在对应命令前加上 sudo。不过这一做法更适合系统级安装;如果你本来就在 conda 环境内操作,通常优先在环境内部解决依赖,而不是把所有包装到系统范围。
另一个需要提前判断的点,是你是否真的需要深度学习 GPU 支持。像 TensorFlow、PyTorch 这类库,在 CPU 环境下也能安装和运行;但一旦涉及 CUDA,就要进一步关注显卡驱动、CUDA 版本以及额外系统依赖是否匹配。原文这里给出的结论很实用:遇到这类情况,最好直接对照对应库的官方文档逐项确认。
简单说,如果你的目标只是完成基础数据分析、传统机器学习实验,numpy、pandas、scikit-learn 往往已经足够;如果还要训练深度学习模型,再去补 TensorFlow 或 PyTorch,并同步确认 Python 3 与 CUDA 相关要求,会更稳妥。
怎么选更合适
把全文归纳成实际决策,其实不复杂。
想快速安装、已有 Python 使用经验、项目规模也不大,可以直接走 pip 路线;想把环境隔离好,减少版本冲突,或者后面还会维护多个实验环境,那么优先考虑 conda。
在 Debian 上,这两套方案都能完成 Python 机器学习环境搭建。关键不在于命令多复杂,而在于你是否提前确认了 Python 版本、是否需要独立环境、是否涉及 GPU/CUDA 支持。把这几个判断点理顺,后续安装基本就会顺畅很多。


