在 Ubuntu 服务器上,PHP 响应慢通常不是单点问题,而是 Web 服务器、PHP 进程、数据库和缓存链路一起拖慢了请求。要把延迟真正压下来,不能只盯着代码本身,还要看运行模式是否合适、缓存是否命中、数据库是否在做无效工作。下面按生产环境最常见的几个优化方向展开,帮助你判断每一步为什么有效、该怎么配,以及哪些参数需要结合机器资源再细调。
切换到 PHP-FPM,并先把 OPcache 用起来
为什么先改运行模式
Ubuntu 上如果还在使用 Apache 的 mod_php 模式,每次请求都要重新加载 PHP 引擎,开销会比较大。把它改成 Nginx + PHP-FPM,或者 Apache + PHP-FPM,本质上是让 PHP 进程以进程池方式常驻内存,请求来了直接调度现成进程,减少重复启动成本。

这一步往往是最先见效的基础优化,尤其适合访问量持续存在、请求比较密集的业务。
安装与切换要点
- 安装 PHP-FPM:
sudo apt update && sudo apt install php-fpm - 如果使用 Apache,先禁用
mod_php:sudo a2dismod phpX.X,其中X.X是你的 PHP 版本;然后启用proxy_fcgi和setenvif模块。 - 在 Nginx 或 Apache 中,把 PHP 请求转发到 PHP-FPM。例如 Nginx 中可使用:
fastcgi_pass unix:/run/php/phpX.X-fpm.sock;
OPcache 为什么几乎是必选项
PHP 每次执行脚本,都要先解析再编译成字节码。OPcache 会把编译结果缓存起来,后续请求直接复用,省掉重复解析和编译的时间。这通常是 PHP 性能优化里投入最小、回报最高的一项。
- 安装 OPcache:
sudo apt install php-opcache。多数 PHP 版本已经默认包含该扩展。 - 配置文件路径:
/etc/php/X.X/fpm/php.ini
zend_extension=opcache.so
opcache.enable=1
opcache.memory_consumption=256   # 根据项目代码量调整,小型项目128MB,大型项目512MB
opcache.max_accelerated_files=20000   # 项目包含的PHP文件总数,可以用`find . -name "*.php" | wc -l`统计
opcache.revalidate_freq=60   # 文件变更检查间隔(秒),生产环境建议设60以上
opcache.fast_shutdown=1   # 加速脚本关闭时的资源回收
opcache.jit=1   # 启用JIT编译(PHP 8.0+),计算密集型场景性能提升明显
opcache.jit_buffer_size=64M   # JIT缓冲区大小
配置完成后,重启 PHP-FPM 让修改生效:
sudo systemctl restart phpX.X-fpm
其中,opcache.memory_consumption、opcache.max_accelerated_files 和 opcache.revalidate_freq 最值得重点看。代码量不大却给太多缓存,收益有限;文件数估计过低,则会导致缓存容纳不足;生产环境把文件变更检查间隔适当拉长,也能减少额外开销。
PHP-FPM 进程池怎么调,决定了并发和内存上限
PHP-FPM 用得对不对,不在于有没有装,而在于进程池参数是否贴合机器资源。配置太小,请求会排队;配置太大,又可能把内存吃满,最后拖垮系统。
常见配置文件位于 /etc/php/X.X/fpm/pool.d/www.conf,可以先从动态模式开始:
pm = dynamic   # 动态模式,适合大多数场景,可根据负载自动调整进程数
pm.max_children = 50   # 最大子进程数,计算公式:(服务器总内存 - 系统预留内存) / 单个PHP进程内存(比如256MB)
pm.start_servers = 10   # 启动时的进程数,建议为pm.max_children的1/5~1/4
pm.min_spare_servers = 5   # 最小空闲进程数,避免请求到来时临时创建进程
pm.max_spare_servers = 20   # 最大空闲进程数,避免空闲进程占用过多内存
pm.max_requests = 500   # 每个子进程处理的最大请求数,防止内存泄漏,达到阈值后重启进程
这些参数该怎么理解
pm.max_children决定同一时间最多能处理多少 PHP 请求,是并发能力的硬上限。pm.start_servers、pm.min_spare_servers和pm.max_spare_servers决定空闲进程池的弹性,影响突发流量来临时能否及时接住请求。pm.max_requests用来限制单个子进程长期存活导致的内存膨胀,适合存在轻微内存泄漏风险的业务。
实践上,建议先估算单个 PHP 进程的平均内存占用,再反推 pm.max_children。如果服务器总内存不高,盲目把这个值调大,通常会从“响应变快”走向“系统开始交换或 OOM”。
参数调整后,别只看页面快不快,还要结合状态信息判断是否真的合理。可以用下面方式查看:
sudo systemctl status phpX.X-fpmphp-fpm-status页面
如果经常出现空闲进程不足、请求堆积,说明池子偏小;如果空闲进程长期过多、内存居高不下,则需要反向收缩。
用缓存层和数据库优化,减少真正耗时的请求路径
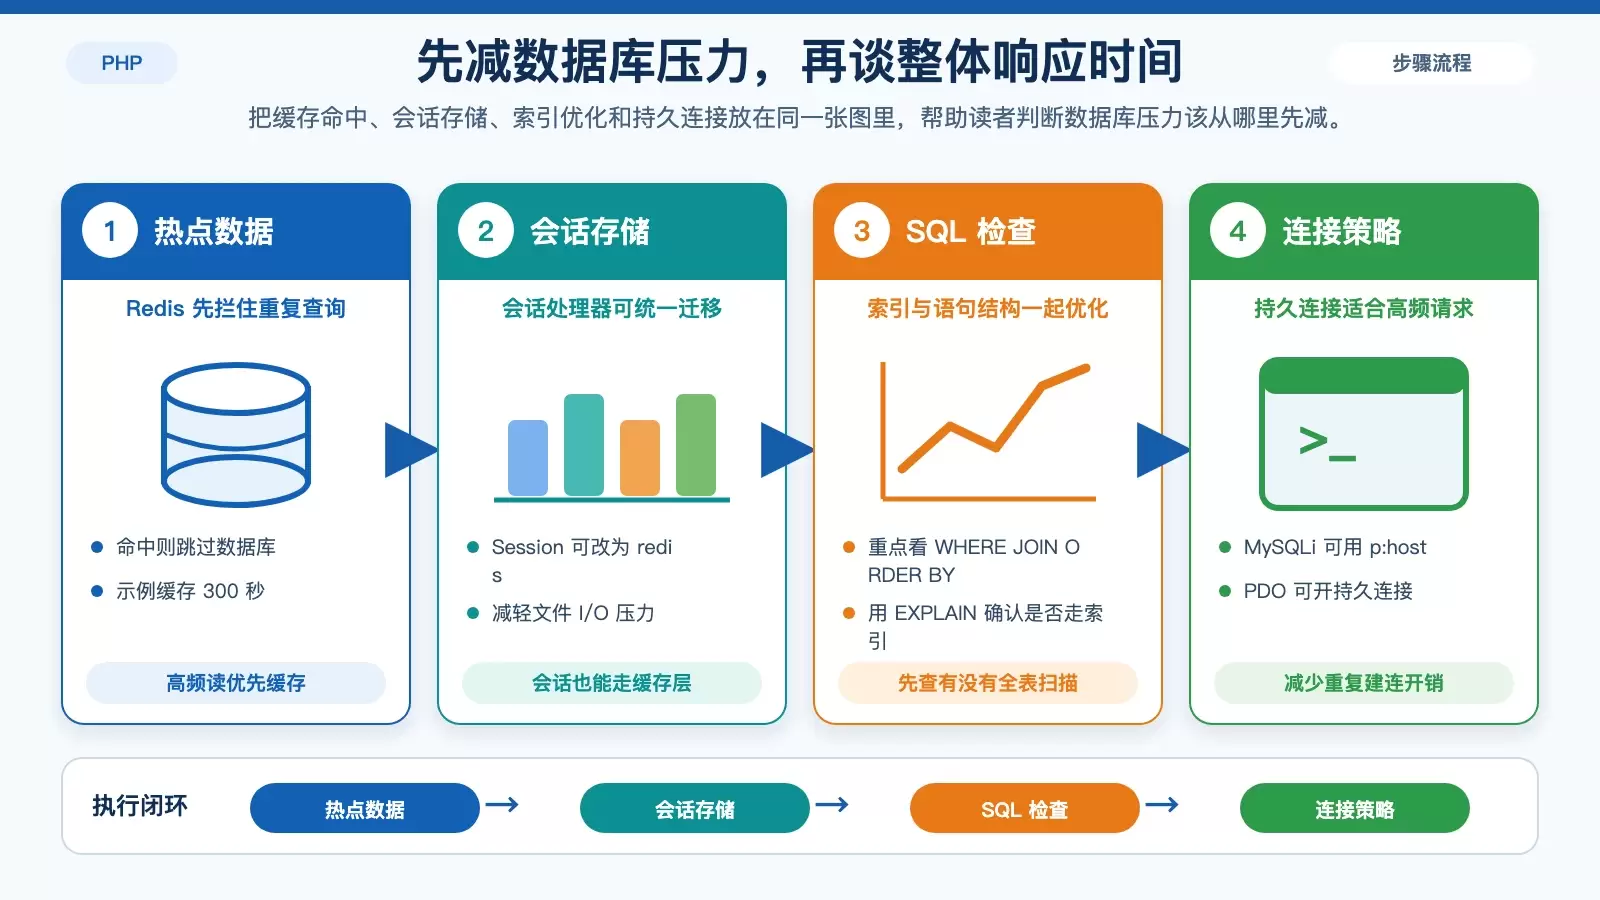
很多 PHP 应用慢,不是 PHP 解释器慢,而是请求一路走到数据库才变慢。热点数据频繁查询、会话落库、SQL 没走索引,都会把响应时间拉高。这里需要同时处理缓存层和数据库本身。
Redis 缓存为什么有效
对于热点商品、首页聚合数据、用户会话这类高频读取内容,优先放到 Redis 或 Memcached 中,能显著减少数据库查询次数。数据库少做一次重复查询,PHP 整体响应通常就能少一段稳定耗时。
- 安装 Redis:
sudo apt install redis php-redis - PHP 7.0+ 需要安装
php-redis扩展
一个典型的缓存读写逻辑如下:
$redis = new Redis();
$redis->connect('127.0.0.1', 6379);
$key = 'hot_products';
if ($data = $redis->get($key)) {
    // 从缓存读取数据
    $products = unserialize($data);
} else {
    // 缓存未命中,从数据库查询
    $products = $db->query("SELECT * FROM products WHERE is_hot = 1")->fetchAll();
    $redis->set($key, serialize($products), 300); // 缓存5分钟
}
这里的关键不只是“有没有缓存”,还包括缓存是否选对对象、过期时间是否合理。像示例中的 300 秒,更适合能接受几分钟延迟刷新的热点数据。如果数据变化非常频繁,缓存策略就要重新设计。
把 Session 放进 Redis
如果会话数据仍然走默认文件方式,访问量上来后也可能成为隐性瓶颈。把会话处理器切到 Redis,通常能降低 I/O 开销,并提升多实例部署时的会话共享能力。
在 php.ini 中可这样设置:
session.sa ve_handler = redis
session.sa ve_path = "tcp://127.0.0.1:6379"
数据库层该优先检查什么
数据库优化不一定要大改架构,很多时候先把几个基础问题处理掉,就能明显降低响应时间:
- 为常用查询字段建立索引,重点是
WHERE、JOIN、ORDER BY中出现的列。 - 用
EXPLAIN分析 SQL,确认查询是否真正走了索引,而不是全表扫描。 - 避免
SELECT *,只取实际需要的字段,减少网络传输和结果集处理开销。 - 尽量减少不必要的子查询,能改成
JOIN的场景优先改写。 - 避免
LIKE '%keyword%',这种写法通常无法使用索引。
连接建立本身也有成本。如果业务请求非常频繁,可以考虑持久连接,减少 TCP 连接的重复创建与关闭:
// MySQLi持久连接示例
$mysqli = new mysqli('p:localhost', 'user', 'password', 'database');
// PDO持久连接示例
$pdo = new PDO('mysql:host=localhost;dbname=database', 'user', 'password', [PDO::ATTR_PERSISTENT => true]);
不过持久连接并不是无条件更快。连接数、数据库负载模型和应用生命周期都要一起考虑,尤其是在连接池、长连接上限比较敏感的环境里,更应该先压测再决定是否启用。
代码细节和静态资源分离,解决容易被忽略的慢点
当 PHP 运行模式、缓存和数据库已经做了基础优化后,剩下的性能问题往往藏在代码细节和请求分工里。单个点可能不夸张,但叠加起来会持续拖慢响应。
代码层可以先改这些习惯
- 减少函数调用,尤其避免在循环里重复调用像
strlen()这类可以预先计算的函数。 - 多使用局部变量,局部变量访问通常比全局变量更快。
- 能用
strpos()、substr()等原生函数时,就不要优先上正则表达式,因为正则匹配成本更高。 - 处理大型数据集时,使用
yield生成器代替一次性构造完整array,可以降低内存峰值。 - 遇到复杂性能问题,用
XHProf或Blackfire做性能分析,找出热点函数和真实瓶颈。
这类优化的特点是“单次收益未必很大,但非常稳定”。尤其是循环内重复计算、无谓的字符串处理和大数组堆积,往往会在高并发下被成倍放大。
让静态资源别再占用 PHP 进程
图片、CSS、JS、字体文件本来就不该经过 PHP 处理。如果静态资源请求还落到 PHP-FPM,等于用最贵的计算资源做最不该做的事。
在 Nginx 中,可以明确把这些请求交给 Web 服务器直接处理:
location ~* .(jpg|jpeg|png|gif|css|js|ico|woff2)$ {
    expires 30d;   # 设置缓存时间
    access_log off;   # 关闭访问日志
    add_header Cache-Control "public";
}
同时,最好让静态资源目录不处于 PHP 处理范围内,例如放在 /var/www/html/static/,由 Nginx 直接访问。这样一来,PHP-FPM 只处理真正需要执行脚本的请求,进程池压力会明显下降。
监控系统资源,再决定下一轮调优方向
性能优化不是改完配置就结束,真正决定效果的是持续观察。CPU、内存、磁盘 I/O 和 PHP-FPM 状态如果没有一起看,很容易出现“某项参数调高了,但系统整体反而更慢”的情况。
- 用
htop、top观察实时 CPU 和内存使用情况。 - 用
vmstat 1监控整体系统状态,重点看上下文切换和 I/O 等待。 - 用
iostat -x 1查看磁盘 I/O 性能,%util超过 70% 时通常就需要排查磁盘瓶颈。 - 按需清理系统缓存和 PHP-FPM 日志,例如
/var/log/phpX.X-fpm.log,避免磁盘空间被长期占用。
文中提到的清理系统缓存命令如下:
sudo sync && sudo echo 3 > /proc/sys/vm/drop_caches
这类操作更适合排查和测试阶段,不建议把它当作日常“提速手段”频繁执行。对生产环境来说,更可靠的做法始终是先定位瓶颈,再针对性调整。
如果要把这些优化真正落到线上,建议按顺序推进:先切 PHP-FPM 和 OPcache,再调进程池,然后补缓存层、查数据库、清理静态资源路径,最后用监控结果验证是否继续细调。这样做的好处是,每一步带来的收益都更容易量化,也更容易在测试环境中提前发现回归风险。









