线程池在 Java 项目里几乎随处可见,但真正容易出事故的地方,往往不是“有没有用线程池”,而是“线程池到底怎么配”。很多人习惯直接写 Executors.newFixedThreadPool(10) 或 newCachedThreadPool(),表面上省事,实际上把队列容量、线程上限和拒绝行为都交给了默认实现。
这篇文章按生产环境最常见的几个问题来拆:为什么不建议直接用 Executors 快捷方法,ThreadPoolExecutor 七个参数各自管什么,任务提交后到底是先扩线程还是先进队列,以及 CPU 密集、IO 密集场景下参数该怎么估。看完后,你至少能判断一个线程池配置是不是存在明显风险,而不是只凭经验拍值。
为什么不建议直接用 Executors 快捷方法
不少问题都始于“先跑起来再说”。但在线程池这件事上,快捷方法常常把最关键的风险藏起来了。
先看 Executors.newFixedThreadPool 的实现:
public static ExecutorService newFixedThreadPool(int nThreads) {
    return new ThreadPoolExecutor(nThreads, nThreads,
            0L, TimeUnit.MILLISECONDS,
            new LinkedBlockingQueue()); // 无界队列!
}
这里的关键问题在于 LinkedBlockingQueue 默认容量是 Integer.MAX_VALUE。这意味着,只要任务提交速度持续高于消费速度,任务就会不断在队列里堆积。线程数虽然看起来固定住了,但内存压力会越来越大,最终可能直接把进程拖到 OOM。
而 newCachedThreadPool 走的是另一条极端路线:它的最大线程数是 Integer.MAX_VALUE。在突发流量、高并发请求或者外部依赖变慢时,线程池可能迅速膨胀出大量线程,带来上下文切换、内存占用和机器负载的全面恶化。
这也是为什么阿里的《Java 开发手册》明确不建议直接使用 Executors 提供的这类快捷方法。手动创建 ThreadPoolExecutor,把队列、线程上限、线程命名和拒绝策略都明确写出来,才有真正可控的运行边界。
ThreadPoolExecutor 的七个参数分别控制什么
生产环境里更常见的写法,是直接构造一个 ThreadPoolExecutor:
ThreadPoolExecutor executor = new ThreadPoolExecutor(
    4,                              // corePoolSize 核心线程数
    8,                              // maximumPoolSize 最大线程数
    60L, TimeUnit.SECONDS,          // keepAliveTime 空闲线程存活时间
    new ArrayBlockingQueue<>(200),  // workQueue 有界任务队列
    new ThreadFactoryBuilder()      // threadFactory 线程工厂,给线程起名
        .setNameFormat("order-pool-%d").build(),
    new ThreadPoolExecutor.CallerRunsPolicy() // handler 拒绝策略
);
这几个参数里,最值得单独理解的是下面几项:
corePoolSize:核心线程数
这是线程池默认维持的常驻线程数量。通常情况下,即使这些线程处于空闲状态,也不会被回收,除非你额外开启了 allowCoreThreadTimeOut。
maximumPoolSize:最大线程数
这是线程池允许扩张到的线程数上限。但它不是一开始就会生效,只有在队列满了之后,线程池才会继续创建线程,直到达到这个上限。
keepAliveTime:非核心线程存活时间
当线程数已经超过 corePoolSize 时,多出来的那部分线程如果空闲超过指定时间,就会被回收。这个参数主要影响高峰期扩出来的线程多久收缩回去。
workQueue:任务队列
当核心线程都在忙时,新提交的任务会先进入队列等待执行。这里最关键的一条不是“用什么队列”,而是必须优先考虑有界队列。队列有没有上限,直接决定了系统是“可控排队”还是“无限堆积”。
threadFactory:线程工厂
它决定新线程是怎么创建的。实践里最常见的用途就是给线程命名,比如 order-pool-%d。出了问题以后看线程栈、JVM dump 或监控面板,能快速定位到具体线程池,而不是在一堆 pool-1-thread-7 里猜。
handler:拒绝策略
当队列已经满了、线程数也已经打到 maximumPoolSize,新的任务再进来就无法继续接收,这时就由拒绝策略决定怎么处理。
任务提交后到底怎么走:先排队,再扩线程
线程池最容易被误解的地方,不是参数名,而是任务的实际流转顺序。很多人会下意识觉得“任务多了就继续加线程”,但 ThreadPoolExecutor 默认并不是这么工作的。
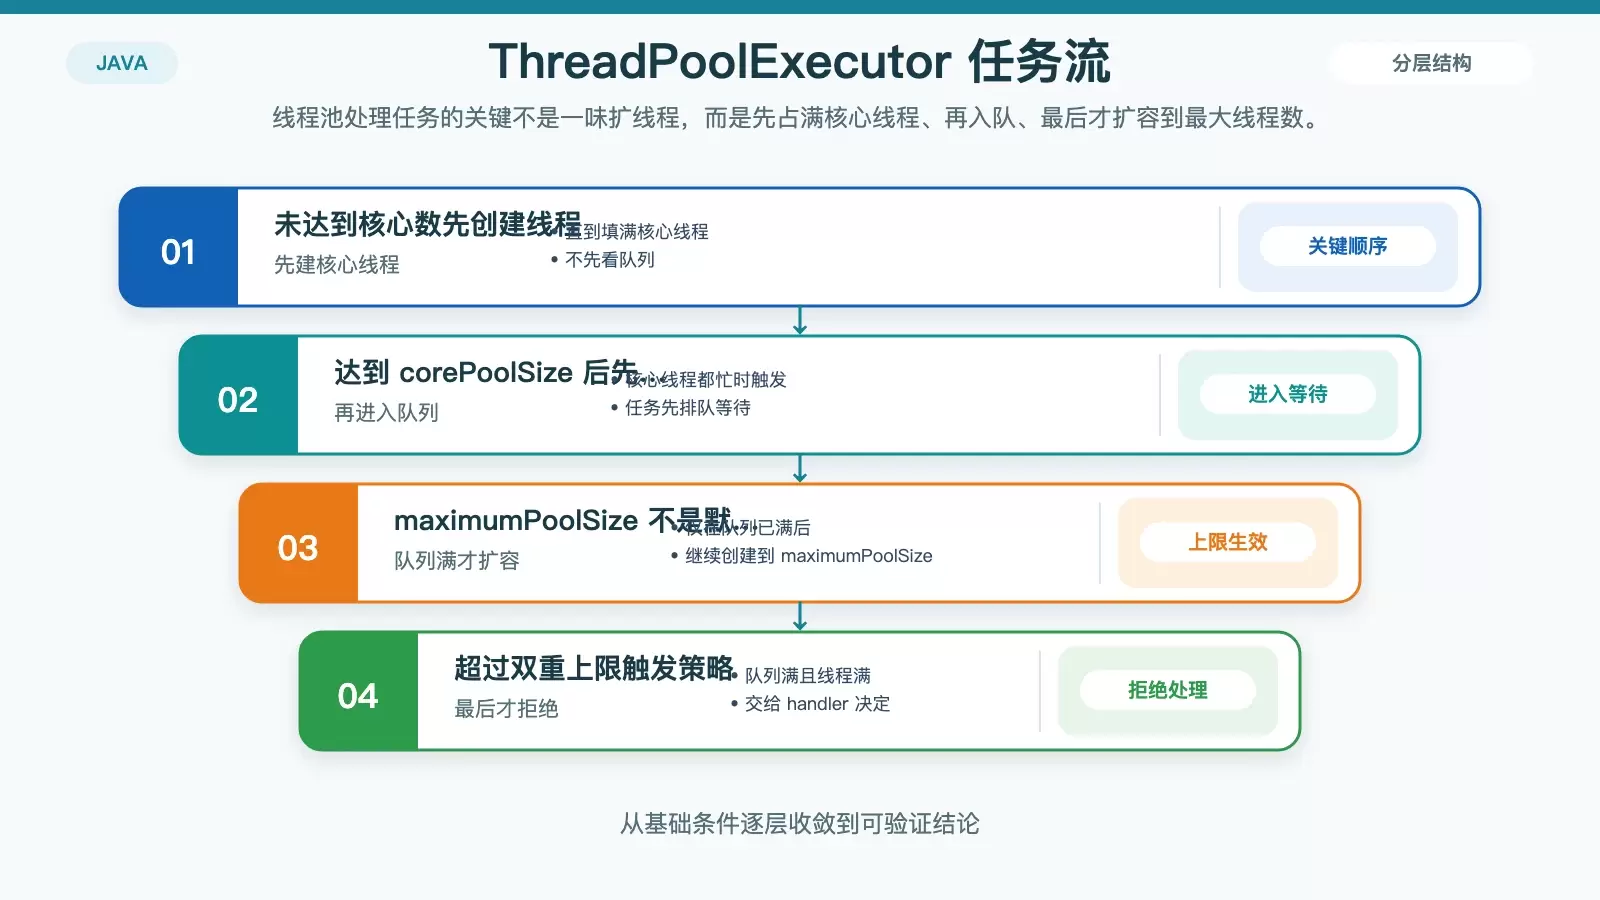
一个任务提交进来后,线程池会按下面的顺序判断:
- 如果当前线程数
< corePoolSize,则直接创建新线程执行任务。 - 如果线程数已经达到
corePoolSize,新任务先进入队列等待。 - 如果队列也满了,才会继续创建新线程,直到达到
maximumPoolSize。 - 如果队列满且线程数也达到
maximumPoolSize,则触发拒绝策略。
也就是说,默认规则不是“先扩容再排队”,而是先把核心线程占满,再把队列塞满,最后才扩到最大线程数。
这条顺序直接决定了一个很重要的结论:如果你用的是无界队列,那么第 3 步通常根本走不到。任务会一直往队列里塞,maximumPoolSize 看起来配置了,实际却几乎没有发挥空间。
这也是为什么很多人明明把最大线程数设得很大,系统高峰时却看不到线程数增长,反而只看到队列持续积压。问题不在线程池“没生效”,而在队列策略已经把扩容路径挡住了。
队列满了以后,四种拒绝策略该怎么选
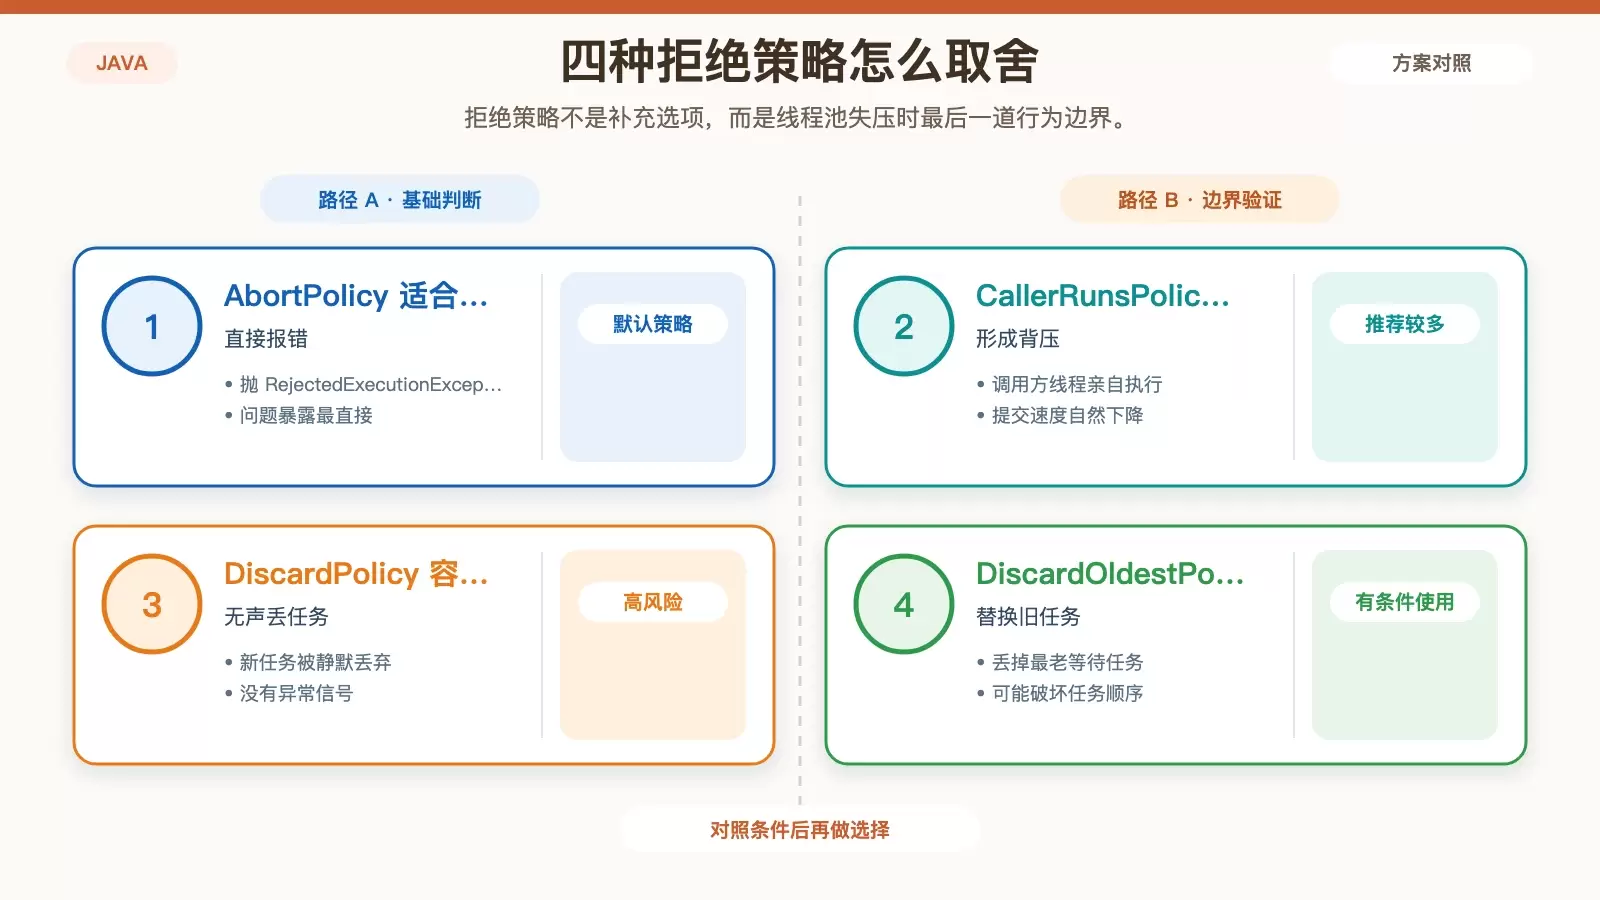
当线程池和队列都到上限时,JDK 内置提供了四种处理方式:
// 1. AbortPolicy(默认):直接抛 RejectedExecutionException
new ThreadPoolExecutor.AbortPolicy();
// 2. CallerRunsPolicy:让提交任务的线程自己执行,相当于天然限流
new ThreadPoolExecutor.CallerRunsPolicy();
// 3. DiscardPolicy:默默丢弃新任务,不抛异常(危险,任务无声消失)
new ThreadPoolExecutor.DiscardPolicy();
// 4. DiscardOldestPolicy:丢掉队列里最老的任务,再尝试提交
new ThreadPoolExecutor.DiscardOldestPolicy();
AbortPolicy:适合快速暴露问题
这是默认策略。好处是出错直接抛 RejectedExecutionException,问题暴露得很明确;坏处是如果业务层没有处理好异常,用户请求可能直接失败。
CallerRunsPolicy:生产环境里更常用
这通常是更务实的选择。新任务不再交给线程池,而是由提交任务的那个线程自己执行。比如 Web 场景里,Tomcat 的请求线程被迫亲自处理任务,请求自然会变慢,提交速度也就跟着降下来。
这个过程本质上是一种背压反馈:系统处理不过来时,不是继续积压任务,也不是悄悄丢任务,而是把压力直接传回调用方,靠吞吐下降换稳定性。
DiscardPolicy:风险最高
它会直接丢弃新任务,而且不抛异常。除非业务天然允许丢失任务,否则这种策略非常危险,因为问题发生时往往没有明显报错,定位成本很高。
DiscardOldestPolicy:适合性有限
它会先丢掉队列里等待最久的任务,再尝试接收当前任务。只有在“旧任务过期价值更低”这一前提明确成立时,才可能有意义,否则容易把业务顺序打乱。
如果业务任务确实不能丢,除了选 CallerRunsPolicy,也可以自定义 handler,把拒绝掉的任务落库或者写入 MQ,后续再补偿重试。
参数怎么估:按任务类型设上限,再用监控修正
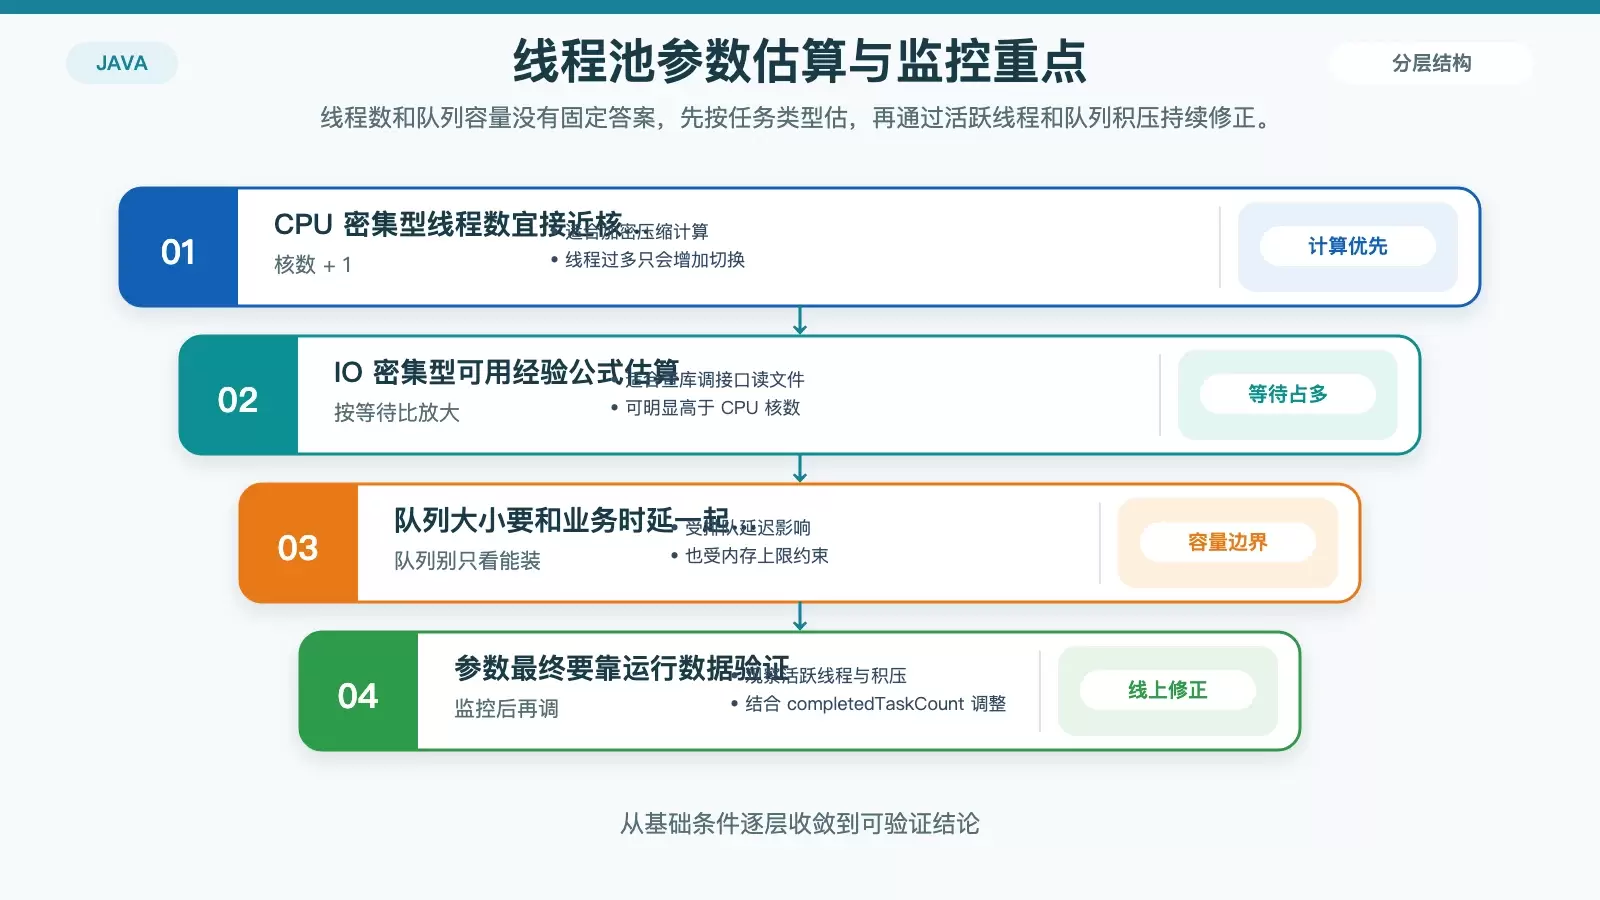
线程池参数没有一套对所有业务都通用的万能值,核心还是看任务是 CPU 密集型还是 IO 密集型。
CPU 密集型任务
像加密、压缩、复杂计算这类任务,线程大部分时间都在真正占用 CPU。线程数通常建议接近 CPU 核数,经验上可取CPU 核数 + 1。再往上加,收益通常不大,反而会增加上下文切换开销。
IO 密集型任务
像调用外部接口、查询数据库、读写文件这类任务,线程大量时间都在等待 IO 返回,因此可以配置更多线程。常见经验公式是:
核数 * (1 + 平均等待时间/平均计算时间)
比如一台 8 核机器,如果任务 90% 的时间都在等 IO,线程数就可以比 CPU 核数大很多,实际可能会落到几十这个量级。
队列大小怎么定
队列容量不要只看“能装多少”,还要结合两个约束一起看:业务能接受多长排队时间,以及机器能承受多大内存占用。队列过小,系统容易频繁触发拒绝;队列过大,又可能把延迟和内存风险一起放大。
因此更实用的办法通常不是一次算到位,而是先给出保守初值,再根据线上数据持续修正。
// 暴露线程池运行指标,接入 Prometheus / 日志定期打印
ScheduledExecutorService monitor = Executors.newSingleThreadScheduledExecutor();
monitor.scheduleAtFixedRate(() -> {
    System.out.printf("活跃=%d 池大小=%d 队列积压=%d 已完成=%d%n",
        executor.getActiveCount(),
        executor.getPoolSize(),
        executor.getQueue().size(),
        executor.getCompletedTaskCount());
}, 0, 5, TimeUnit.SECONDS);
这类监控至少能帮助你观察几个关键现象:
- 队列长期积压,说明消费能力不足,可能需要优化任务耗时、增加消费者能力,或者重新评估线程数。
- 活跃线程数长期贴着
maximumPoolSize,说明池子偏小,或者外部依赖过慢,线程长期被阻塞。 - 线程数不高但延迟已经明显上升,问题可能不在线程池,而在下游资源瓶颈。
参数配置最怕的是“定完就不看了”。线程池是否合适,最终还是要靠运行中的数据来验证。
别忽略关闭动作:线程池也需要优雅退出
线程池不是创建完就不用管了。任务处理结束后,如果没有正常关闭,非守护线程可能会一直存在,阻止 JVM 退出。
executor.shutdown(); // 不再接收新任务,等已提交任务跑完
if (!executor.awaitTermination(30, TimeUnit.SECONDS)) {
    executor.shutdownNow(); // 超时后强制中断
}
shutdown() 会停止接收新任务,但会让已经提交的任务继续执行完成;shutdownNow() 则更激进,会向正在执行的线程发送中断信号,并返回尚未开始执行的任务列表。
因此,正常业务收尾时优先使用 shutdown(),只有在超时未结束时,再通过 shutdownNow() 做兜底。
实战里最容易踩坑的结论
- 不要图省事直接用
Executors快捷方法,尤其要警惕无界队列和无限线程上限。 - 真正要记住的执行顺序是:核心线程优先创建,随后任务进队列,队列满后才扩到最大线程数,最后才是拒绝策略。
- 只要用了无界队列,
maximumPoolSize大概率就失去了实际意义。 - 生产环境里,
CallerRunsPolicy往往比简单丢弃更稳,因为它能形成自然背压。 - CPU 密集和 IO 密集的线程数思路完全不同,队列大小也要结合延迟目标和内存边界一起评估。
- 参数不是一次性配置项,必须配合监控持续调整。
如果只记一句话,那就是:线程池的大多数问题,最终都能追到两个根源上,第一是队列没有边界,第二是不理解“先排队,再扩线程”的执行顺序。把这两件事想明白,线程池参数就不会再只靠猜。