Java 应用在 Ubuntu 上跑得慢,很多时候不是单点故障,而是 JVM、代码、系统和数据库多层因素叠加的结果。与其一上来就加机器,不如按“先定位、再调整、再验证”的顺序逐层排查:先稳住内存与 GC,再减少无效开销,随后检查内核和连接能力,最后回到数据库与监控结果做针对性修正。这样做的好处是,每一步都有明确的观察指标,也更容易判断优化到底有没有带来真实收益。
JVM 调优:先把内存模型和 GC 策略调顺
Java 应用的性能,首先受 JVM 参数影响。尤其在 Ubuntu 服务器环境里,如果堆设置频繁波动、垃圾回收器选型不合适,应用会在吞吐量和停顿时间之间反复失衡。
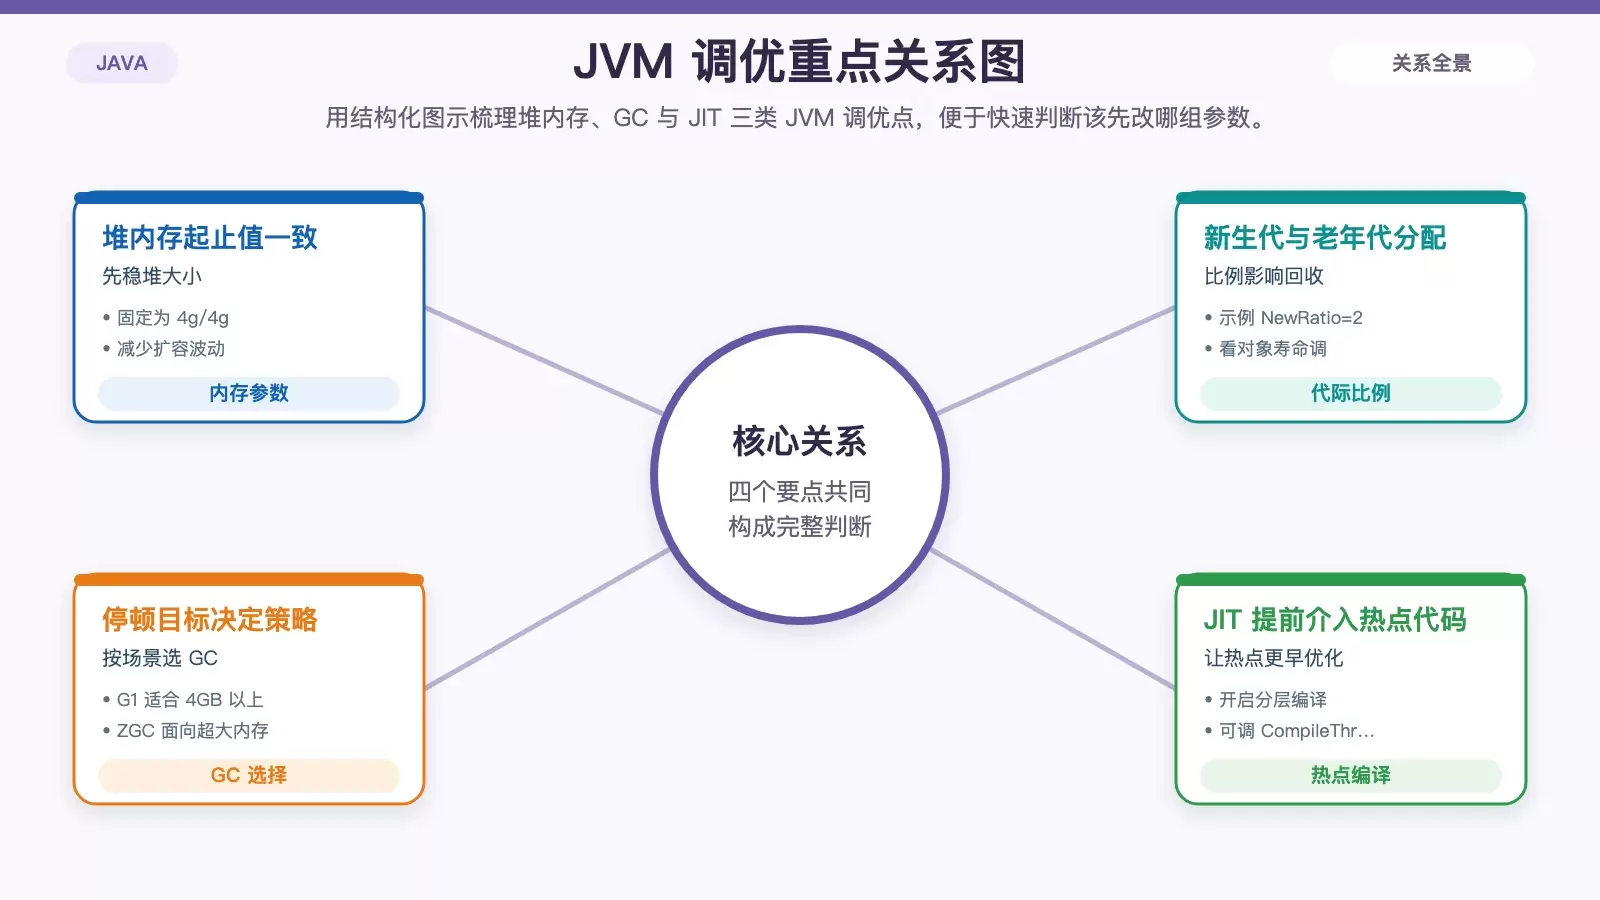
固定堆大小,减少运行时扩容成本
-Xms 和 -Xmx 直接决定堆内存的初始值与最大值。对长期运行的服务来说,常见做法是把两者设为一致,例如:
-Xms4g -Xmx4g这样可以避免应用运行过程中反复扩容、收缩堆空间,减少额外开销。与此同时,新生代和老年代的比例也要结合对象生命周期来定,例如:
-XX:NewRatio=2这个配置表示新生代约占整个堆的三分之一。如果应用中短生命周期对象很多,可以重点观察新生代是否足够,否则 Minor GC 过于频繁,同样会拖慢响应。
根据内存规模选择合适的垃圾回收器
GC 没有通用最优解,核心是看应用的内存规模和延迟目标。

- G1GC:适合 4GB 以上堆内存、多处理器环境,也是当前常见默认方案之一。可以用下面的参数控制停顿目标:
-XX:+UseG1GC -XX:MaxGCPauseMillis=200其中 -XX:MaxGCPauseMillis=200 的含义,是尽量把最大停顿时间控制在 200ms 左右,在吞吐量和响应延迟之间做平衡。
- ZGC:更适合超大内存场景,目标是把停顿时间压到极低水平。启用时需要解锁实验性参数:
-XX:+UnlockExperimentalVMOptions -XX:+UseZGC如果应用还没有达到大内存、低停顿敏感的条件,贸然切到 ZGC 不一定划算,还是要结合监控结果来定。
让 JIT 更早介入热点代码
除了内存和 GC,JIT 编译器也会直接影响热点代码的执行效率。分层编译通常值得开启:
-XX:+TieredCompilation它可以在解释执行与高等级编译之间逐步过渡,让热点方法更快进入优化阶段。必要时还可以通过 -XX:CompileThreshold 调整触发编译的调用次数,让编译器更早关注高频代码路径。
代码优化:减少对象、选对结构、堵住泄漏
JVM 调得再细,如果代码本身持续制造无效对象或使用了不合适的数据结构,性能收益也很容易被吃掉。代码层优化的重点,是减少资源消耗和提升执行效率。
避免高频创建临时对象
在循环或高频方法中频繁 new 临时对象,会带来额外分配和 GC 压力。一个常见例子是字符串拼接:如果在多次追加场景下仍使用普通字符串,很容易造成不必要的中间对象,改用 StringBuilder 更合适。
对于数据库连接、线程等成本更高的资源,优先采用连接池和线程池复用。如果业务确实存在大量重复创建、销毁对象的情况,也可以考虑对象池技术,例如 Apache Commons Pool。
数据结构和算法选错,性能会直接掉档
很多性能问题并不复杂,单纯是结构没有选对。比如查找频繁的场景,通常优先考虑 HashMap,而不是 TreeMap;在更关注内存连续性和遍历效率时,ArrayList 往往比 LinkedList 更合适。
算法层面也是同样的道理。面对大规模数据排序,如果还在使用低效的基础排序方式,优化空间会非常明显。很多时候,先把算法复杂度降下来,比继续微调 JVM 参数更有效。
内存泄漏往往比“慢”更难发现
资源没有及时释放,会让性能问题变成稳定性问题。像 InputStream、Connection 这类资源,用完必须在 finally 块中关闭,避免长时间占用系统资源。
另外,静态集合也很容易埋坑。例如 static Map 长期持有对象引用,哪怕对象已经不再使用,GC 也无法回收。GUI 或事件驱动场景下,注册过的监听器如果不移除,同样可能造成对象残留。
系统配置优化:让 Ubuntu 的句柄、内核和硬件跟上应用负载
当应用并发连接增多、I/O 压力上升时,Ubuntu 默认配置常常会成为瓶颈。这个阶段的重点,不是盲目改参数,而是先确认应用受限于文件描述符、网络队列还是内存换页。
先处理文件描述符上限
高并发服务最常见的问题之一,就是文件句柄不够用。临时调整可以直接执行:
ulimit -n 65535如果要永久生效,则需要修改 /etc/security/limits.conf,加入:
* soft nofile 65535
* hard nofile 65535
这样可以明显提升服务在高连接数下的承载能力,避免因为句柄耗尽导致连接失败。
几个关键内核参数值得优先检查
编辑 /etc/sysctl.conf 时,可以重点关注以下几项:
vm.swappiness=10:降低系统使用交换分区的倾向,让 Java 进程更依赖物理内存;fs.file-max=100000:提高系统级文件描述符总上限;net.core.somaxconn=65535:增大 TCP 监听队列长度,改善连接堆积场景下的处理能力。
这些参数通常对服务端 Java 应用比较关键,但修改后仍应结合业务峰值负载验证,避免只看配置数字,不看实际效果。
硬件配置也要和 JVM 目标匹配
如果磁盘仍是 HDD,很多 I/O 型应用会直接受限于磁盘读写性能,换成 SSD 往往能带来立竿见影的改善。内存方面,通常建议系统总内存至少达到 Java 堆的 1.5 到 2 倍,给操作系统、缓存和其他进程留出空间。
多核 CPU 对并行垃圾回收也更友好。如果应用已经进入多线程、高吞吐阶段,CPU 核心数不足同样会拖慢整体表现。
数据库优化:减少无效 IO,把查询和连接成本压下来
很多“Java 应用慢”的表象,根源其实在数据库层。尤其是高频查询、复杂联表和连接池配置不当,会让应用线程长期阻塞在 I/O 上,看起来像是 JVM 或代码有问题。
先看 SQL,再决定要不要加资源
联表查询过多时,JOIN 的成本会上升得很快,复杂 SQL 在数据量扩大后尤其明显。高频查询字段应该建立索引,例如:
CREATE INDEX idx_name ON table_name(column_name)在正式调整前,建议先用 EXPLAIN 查看执行计划。很多慢查询问题并不需要大改架构,仅通过执行计划就能发现是否走索引、是否出现全表扫描。
连接池参数决定了数据库访问是否稳定
数据库连接池能减少连接创建和销毁带来的成本,HikariCP、Druid 都是常见选择。这里的关键不只是“用了连接池”,而是参数是否贴合并发模型。
maximumPoolSize 需要根据业务并发量设置,过小会造成排队,过大又可能把数据库压满。connectionTimeout 也要设定合理值,避免线程长时间等待连接却迟迟得不到反馈。
监控与分析:用工具定位瓶颈,再做持续调优
性能优化最怕靠经验拍脑袋。真正有效的方式,是用 JVM 工具和可视化工具先确认瓶颈在哪里,再决定该改 GC、改代码还是改数据库。

命令行工具适合快速判断 JVM 状态
几条常用命令就能帮助快速排查:
jstat -gcutil 1000 这条命令会每秒输出一次 GC 统计信息,适合观察 GC 频率和回收占比。
jmap -heap 可以查看堆内存分布,判断当前内存布局是否合理。
jstack 适合分析线程状态,线程阻塞、死锁等问题通常都能在这里看到线索。
图形化工具更适合做关联分析
如果需要把 CPU、内存、线程变化放在一起看,图形化工具更高效。VisualVM 集成了 jstat、jmap 等常用能力,适合快速观察内存、CPU 和线程变化趋势;JProfiler 属于商业工具,但在问题定位深度上更强。
与其根据症状猜测问题,不如直接用工具把热点路径、GC 行为和线程阻塞点找出来,这样后续优化动作才有依据。
把优化做成闭环,而不是一次性动作
性能调优通常不是一次完成。更可行的方式,是围绕“监控 → 分析 → 调整”持续迭代:监控发现异常指标,分析确认瓶颈位置,再针对性调整 JVM 参数、代码逻辑或数据库配置。
例如,若监控显示 GC 频繁,可以考虑增大堆内存或重新评估 GC 策略;如果高频方法耗时过高,就回到代码层优化算法与对象分配。只有形成闭环,Ubuntu 上的 Java 应用性能才会稳定提升,而不是某次压测好看、上线后又回落。









