把手机随手拍下来的纸质文档,直接转成较规整的“扫描件”并提取文字,是很多自动化录入场景里的基础需求。这套项目用 Python + OpenCV 负责文档检测、透视校正和二值化,再交给 Tesseract 完成 OCR 识别。下面按“项目能做什么、代码怎么跑、关键参数怎么调、问题出在哪”几个层次梳理,便于你快速判断这套实现是否适合票据、页面文档或后续批处理场景。
项目能解决什么问题
这个项目的目标很直接:输入一张带有倾斜角度的文档照片,输出一张经过校正的正面文档图像,以及识别出来的文字内容。
从处理链路看,它把任务分成了两段:
- 文档扫描阶段:检测文档边缘,找到四边形轮廓,做透视变换,把拍歪的页面拉正。
- OCR 识别阶段:对扫描后的图像做预处理,再调用 Tesseract 提取文字。
如果你的输入图像边界相对清晰、纸张和背景有明显对比,这种方案通常就能跑通基础流程。它更适合单页文档、收据、打印页这类轮廓明确的对象,不是面向复杂版式解析或高精度表格还原的完整解决方案。
技术栈与项目结构
技术栈分别负责什么
| 技术 | 用途 |
|---|---|
| Python | 编程语言 |
| OpenCV | 图像处理核心库 |
| NumPy | 数值计算 |
| Tesseract OCR | 文字识别引擎 |
| pytesseract | Tesseract Python封装 |
| Pillow | 图像读取 |
这里的分工比较清晰。OpenCV 负责“看懂图像边界和几何关系”,Tesseract 负责“把图像里的字符转成文本”。NumPy 和 Pillow 则是这条链路里的基础支撑。

项目目录说明
Scan/
OCR 识别配置与预处理突出 OCR 阶段的预处理选项、Tesseract 调用方式和中文识别配置。 ├── scan.py # 文档扫描核心模块
├── test.py # OCR文字识别模块
├── scan.jpg # 默认输入/输出图像
├── images/ # 示例图像目录
│ ├── page.jpg # 示例文档图像
│ └── receipt.jpg # 示例收据图像
└── Tesseract-OCR/ # Tesseract OCR引擎(内置)

scan.py 和 test.py 是这个项目的主干:前者生成扫描结果,后者对扫描结果执行 OCR。对于初学者来说,这种拆分方式也比较利于单独排查问题,例如先确认透视校正是否稳定,再去看 OCR 准确率。
文档扫描与 OCR 的核心实现
扫描部分的关键思路
扫描模块的关键,不在于“把图片读进来”,而在于如何稳定地找到文档的四个角,然后把它映射到一个规则矩形里。
1. 角点排序函数
def order_points(pts):
    # 初始化4个坐标点
    rect = np.zeros((4, 2), dtype = "float32")

    # 按顺序找到对应坐标:左上、右上、右下、左下
    s = pts.sum(axis = 1)
    rect[0] = pts[np.argmin(s)]  # 左上:x+y最小
    rect[2] = pts[np.argmax(s)]  # 右下:x+y最大

    diff = np.diff(pts, axis = 1)
    rect[1] = pts[np.argmin(diff)]  # 右上:x-y最小
    rect[3] = pts[np.argmax(diff)]  # 左下:x-y最大

    return rect
这段代码的作用是把四个无序角点重新整理成固定顺序:左上、右上、右下、左下。原因很简单,后续透视变换需要知道每个点在目标矩形中对应哪个位置。如果角点顺序错了,拉正结果就会发生错位甚至翻转。
这里使用的是一个很常见的技巧:
- 通过坐标和
x + y找到左上和右下; - 通过坐标差
x - y找到右上和左下。
它实现简单,适合标准四边形文档轮廓。
2. 透视变换函数
def four_point_transform(image, pts):
    rect = order_points(pts)
    (tl, tr, br, bl) = rect

    # 计算目标宽度和高度
    widthA = np.sqrt(((br[0] - bl[0]) ** 2) + ((br[1] - bl[1]) ** 2))
    widthB = np.sqrt(((tr[0] - tl[0]) ** 2) + ((tr[1] - tl[1]) ** 2))
    maxWidth = max(int(widthA), int(widthB))

    heightA = np.sqrt(((tr[0] - br[0]) ** 2) + ((tr[1] - br[1]) ** 2))
    heightB = np.sqrt(((tl[0] - bl[0]) ** 2) + ((tl[1] - bl[1]) ** 2))
    maxHeight = max(int(heightA), int(heightB))

    # 变换后对应坐标位置
    dst = np.array([
        [0, 0],
        [maxWidth - 1, 0],
        [maxWidth - 1, maxHeight - 1],
        [0, maxHeight - 1]], dtype = "float32")

    # 计算变换矩阵
    M = cv2.getPerspectiveTransform(rect, dst)
    warped = cv2.warpPerspective(image, M, (maxWidth, maxHeight))

    return warped
这个函数完成的是几何校正。它先根据原图中的四个角点,计算文档在真实空间里的宽和高,再定义一个规则矩形作为目标平面,最后通过 cv2.getPerspectiveTransform 和 cv2.warpPerspective 把图像拉成正面视图。
如果把整个扫描过程理解成“模拟扫描仪”,透视变换就是最核心的一步。前面的边缘检测是为了找到文档,后面的 OCR 则依赖这一阶段提供更规整的输入。
3. 扫描主流程
# 1. 读取图像并缩放
image = cv2.imread(args["image"])
ratio = image.shape[0] / 500.0
orig = image.copy()
image = resize(orig, height = 500)

# 2. 边缘检测
gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
gray = cv2.GaussianBlur(gray, (5, 5), 0)
edged = cv2.Canny(gray, 75, 200)

# 3. 轮廓检测
cnts = cv2.findContours(edged.copy(), cv2.RETR_LIST, cv2.CHAIN_APPROX_SIMPLE)[0]
cnts = sorted(cnts, key=cv2.contourArea, reverse=True)[:5]

# 4. 找到四边形轮廓
for c in cnts:
    peri = cv2.arcLength(c, True)
    approx = cv2.approxPolyDP(c, 0.02 * peri, True)
    if len(approx) == 4:
        screenCnt = approx
        break

# 5. 透视变换和二值化
warped = four_point_transform(orig, screenCnt.reshape(4, 2) * ratio)
warped = cv2.cvtColor(warped, cv2.COLOR_BGR2GRAY)
ref = cv2.threshold(warped, 100, 255, cv2.THRESH_BINARY)[1]
cv2.imwrite('scan.jpg', ref)
这段流程可以拆成几个关键节点:
- 先缩放再计算:把图像高度压到 500,有利于提升处理速度;
ratio用来把轮廓坐标映射回原图尺寸。 - 灰度化 + 高斯模糊 + Canny:这是经典的边缘提取组合,目标是突出文档边缘、压制部分噪声。
- 按面积保留前 5 个轮廓:假设文档通常是画面中较大的目标,先缩小搜索范围。
- 多边形逼近找四边形:通过
cv2.approxPolyDP(c, 0.02 * peri, True)判断轮廓是否接近矩形文档。 - 二值化输出:使用
cv2.threshold(warped, 100, 255, cv2.THRESH_BINARY)[1]生成更像扫描件的结果图。
需要注意的是,这套逻辑默认文档轮廓是完整可见的。如果页面被遮挡、背景过于杂乱,或者图像里的矩形对象不止一个,文档轮廓不一定能被稳定选中。
OCR 模块做了什么
from PIL import Image
import pytesseract
import cv2
import os

preprocess = 'blur'  # thresh

image = cv2.imread('scan.jpg')
gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)

# 预处理
if preprocess == "thresh":
    gray = cv2.threshold(gray, 0, 255, cv2.THRESH_BINARY | cv2.THRESH_OTSU)[1]
elif preprocess == "blur":
    gray = cv2.medianBlur(gray, 3)

# 调用Tesseract OCR
filename = "{}.png".format(os.getpid())
cv2.imwrite(filename, gray)
pytesseract.pytesseract.tesseract_cmd = r'./Tesseract-OCR/tesseract.exe'
text = pytesseract.image_to_string(Image.open(filename))
print(text)
os.remove(filename)
OCR 部分的逻辑相对直接:读取 scan.jpg,做一次灰度预处理,然后将图像交给 Tesseract。
这里保留了两种预处理方式:
thresh:二值化,适合文字和背景对比度较高的扫描图。blur:中值模糊,适合去除少量噪点。
实际效果取决于输入图像质量。对字符边缘已经很清楚的图像,阈值化往往更利于识别;如果页面噪点较多、边缘粗糙,中值模糊可能更稳一些。
代码里还显式指定了 Tesseract 可执行文件路径:
pytesseract.pytesseract.tesseract_cmd = r'./Tesseract-OCR/tesseract.exe'这说明项目默认按“内置引擎目录”的方式组织。如果你把 Tesseract 安装在系统其他路径,就需要同步修改这里的配置。
安装、运行与中文识别配置
安装依赖
pip install numpy opencv-python pytesseract pillow这一步安装的是 Python 侧依赖。OCR 真正执行时,还要确保 Tesseract 可执行程序存在,并且 tesseract_cmd 指向正确路径。
运行文档扫描
# 使用默认图像
python scan.py

# 指定输入图像
python scan.py -i images/page.jpg
执行后,扫描结果会写入 scan.jpg。如果你想先验证扫描模块是否有效,可以先不跑 OCR,直接查看这个输出文件是否已经完成拉正和二值化。
运行 OCR 识别
python test.py如果前一步生成的 scan.jpg 质量不错,这里通常就能直接输出文字结果。相反,如果 OCR 结果很差,大概率问题不在识别本身,而在前面的扫描图像质量。
如何启用中文识别
项目已经给出了中文识别的扩展方式:下载中文训练数据 chi_sim.traineddata,放到 Tesseract-OCR/tessdata/ 目录,然后把识别调用改成下面这样:
text = pytesseract.image_to_string(Image.open(filename), lang='chi_sim')这一步很关键,因为默认调用通常偏向英文模型。只要训练数据路径正确、语言参数正确,中文文档的识别结果一般会明显改善。
参数调整与常见问题
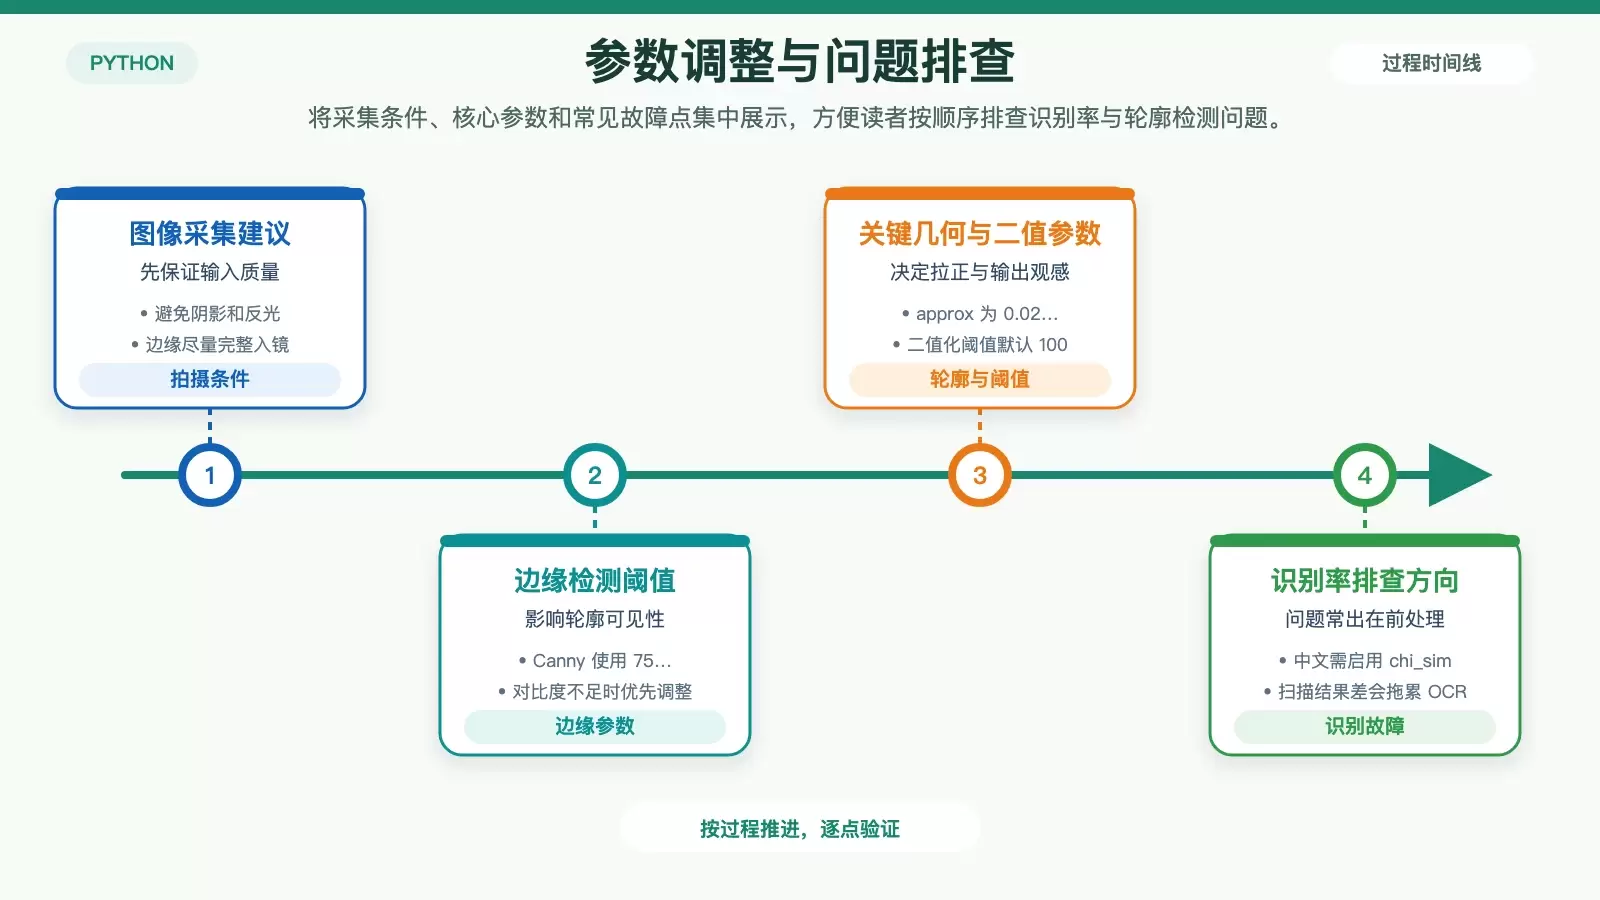
拍摄和采集时先保证这些条件
- 光线充足:尽量避免阴影和强反光。
- 对比度明显:文档与背景颜色差异越大,轮廓越容易被找出来。
- 边缘清晰:页面四周尽量完整入镜。
- 距离适中:过近容易透视夸张,过远则文档区域过小。
这些建议看起来基础,但对这类轮廓驱动的扫描方案影响很大。很多失败案例,根源都不是代码错误,而是输入图像没有给出足够稳定的边界信息。
几个最值得先调的参数
- Canny 边缘阈值:
cv2.Canny(gray, 75, 200)。边缘过少或过多时,都可以从这里下手。 - 轮廓逼近精度:
0.02 * peri。值越小,轮廓越贴近原始边界。 - 二值化阈值:
cv2.threshold(warped, 100, 255, ...)。页面过暗或过亮时,这个值会直接影响扫描件观感和 OCR 识别率。
如果你是在固定场景下使用,比如办公室票据录入或表单归档,建议针对具体拍摄环境做一轮参数固化,而不是依赖一套通用默认值。
Q1:OCR 识别率低怎么办?
- 先确认图像本身是否清晰,文字边缘是否可辨认。
- 切换预处理方式,比较
thresh和blur的实际效果。 - 检查扫描结果是否仍有倾斜、模糊或局部阴影。
- 如果要识别中文,补齐中文训练数据并使用
lang='chi_sim'。
这类问题通常不要一上来就怀疑 Tesseract,本项目里更常见的瓶颈是输入质量和预处理策略不匹配。
Q2:检测不到文档边缘怎么办?
- 检查文档与背景是否缺少对比度。
- 确认原始图片是否模糊或噪声过重。
- 尝试调整
cv2.Canny(gray, 75, 200)的阈值。 - 尝试调整
0.02 * peri的轮廓逼近参数。
如果画面中存在桌面边线、书本边框、显示器外框等大面积矩形对象,轮廓排序后的候选目标也可能被误判,这时需要结合实际场景进一步筛选轮廓。
Q3:这套项目还能往哪里扩展?
在现有基础上,可以继续做这些方向:
- 批量处理:支持一次扫描多个文档。
- 图形界面:加入 PyQt 或 Tkinter,降低使用门槛。
- 实时扫描:接入摄像头实现边拍边识别。
- 多语言支持:补充更多 OCR 训练数据。
- 文档分类:根据识别内容做归档或分类。
如果只是学习 OpenCV 与 OCR 的基础衔接,这个项目已经足够完整;如果要进入生产环境,通常还需要补充异常处理、批量任务管理、版式适配和结果校验机制。
这套实现适合拿来做什么
从实现复杂度看,这是一套典型的入门到实用之间的文档扫描方案:前端处理聚焦在边缘检测、轮廓提取和透视变换,后端识别依赖 Tesseract OCR,链路清楚,便于理解和二次修改。
它的优势是结构简单、依赖明确、上手成本低,适合用来学习 OpenCV 图像校正和 OCR 串联流程;它的边界也很明确,面对复杂背景、低质量拍摄、中文长文档或复杂版式时,往往需要继续强化预处理、语言模型和业务规则。对于希望快速做出一个“拍照转扫描件并提字”原型的人来说,这个项目是一个不错的起点。