NVIDIA要用上X3D堆叠设计!下代Feynman GPU将引入LPU
时间:2025-12-29 | 作者:穿越地图的猫 | 阅读:012月29日消息,虽然NVIDIA目前在AI训练领域无可匹敌,但面对日益增长的即时推理需求,其正筹划一项足以改变行业格局的“秘密武器”。
据AGF透露,NVIDIA计划在2028年推出的Feynman(费曼)架构GPU中,整合来自Groq公司的LPU(语言处理单元),以大幅提升AI推理性能。
Feynman架构将接替Rubin架构,采用台积电最先进的A16(1.6nm)制程,为了突破半导体物理限制,NVIDIA计划利用台积电的SoIC混合键合技术,将专为推理加速设计的LPU单元直接堆叠在GPU之上。

这种设计类似于AMD的3D V-Cache技术,但NVIDIA堆叠的不是普通缓存,而是专为推理加速设计的LPU单元。
设计的核心逻辑在于解决SRAM的微缩困境,在1.6nm这种极致工艺下,直接在主芯片集成大量SRAM成本极高且占用空间。
通过堆叠技术,NVIDIA可以将运算核心留在主芯片,而将需要大量面积的SRAM独立成另一层芯片堆叠上去。
台积电的A16制程一大特色是支持背面供电技术,这项技术可以腾出芯片正面的空间,专供垂直信号连接,确保堆叠的LPU能以极低功耗进行高速数据交换。
结合LPU的“确定性”执行逻辑,未来的NVIDIA GPU在处理即时AI响应(如语音对话、实时翻译)时,速度将实现质的飞跃。
不过这也存在两大潜在挑战,分别是散热问题和CUDA兼容性难题,在运算密度极高的GPU 再加盖一层芯片,如何避免“热当机”是工程团队的头号难题。
同时LPU强调“确定性”执行顺序,需要精确的内存配置,而CUDA生态则是基于硬件抽象化设计的,要让这两者完美协同,需要顶级的软件优化。


免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
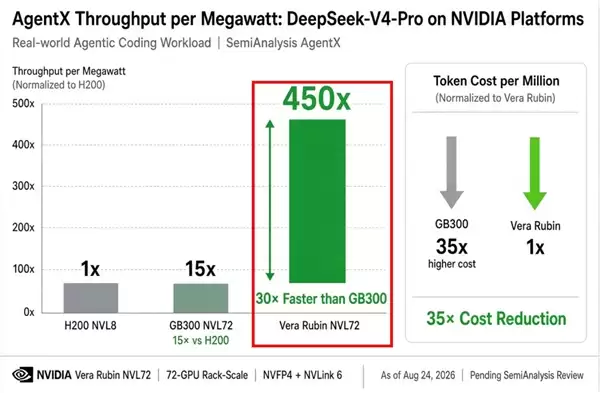
- NVIDIA最强AI显卡Rubin实测:DS V4 Pro性能比2年前提升了450倍
- 时间:2026-08-25
-

- 2026年显卡涨价不同于矿卡:显存成本短期降不下来
- 时间:2026-08-17
-

- 《影之刃零》现已开放预购 支持 DLSS 4.5和光线追踪 《诡秘之主》即将开启公测
- 时间:2026-08-15
-

- 芯片2年过时论破产!6年前的NVIDIA A100还在赚钱
- 时间:2026-08-13
-

- NVIDIA在华份额已降至0 腾讯称GPU芯片储备充足:明年也够用
- 时间:2026-08-13
-
- NVIDIA GPU 加速的全新开放模型
- 时间:2026-08-12
-
- LTX 推出 LTX-2.5
- 时间:2026-08-12
-

- ChatGLM新手安装教程:NVIDIA CUDA环境配置与代理镜像源设置
- 时间:2026-08-12

精选合集
更多大家都在玩
大家都在看
更多-
- 闪烁之光法师及坦克符文推荐
- 时间:2026-10-21
-
- 闪烁之光三灵系玩法解析
- 时间:2026-10-21
-
- 闪烁之光高速爆发流攻略
- 时间:2026-10-21
-
- 闪烁之光食魇天马和金羽鸾适配场景
- 时间:2026-10-21
-
- 闪烁之光永恒纪元钟效果解析
- 时间:2026-10-21
-
- 闪烁之光神装选择思路
- 时间:2026-10-21
-
- PS怎么用魔棒抠图
- 时间:2026-10-21
-
- OBS Studio怎么设置音频输入源
- 时间:2026-10-21