得物高可控智能客服Agent工程实践:从机械应答到服务伙伴
时间:2026-07-18 | 作者:游戏探长 | 阅读:0智能客服系统正经历一场深刻的变革。它从仅能处理简单问答的“机械应答”,逐步升级为能够理解复杂意图、进行多轮协商并展现情感温度的“服务伙伴”。得物技术团队在此次升级中,分享了其高可控性Agent工程的核心实践。该实践重点解决了智能客服在落地过程中面临的场景复杂、成本高昂与拟人化不足等关键挑战。
一、智能客服当下的痛点
在深入Agent工程实践之前,需要明确当前智能客服系统普遍存在的三大核心痛点:
- 听不懂人话、自作聪明:无法准确理解用户意图,频繁答非所问,导致用户体验差。
- 成本高、排队严重:高并发场景下,人力客服无法覆盖所有用户,导致用户长时间排队等待。
- 问题解决能力弱:只能处理简单FAQ,面对复杂、涉及多轮交互的问题时,常常无能为力。

二、智能客服 Agent 落地的必然性与挑战
Agent 智能客服的必然性
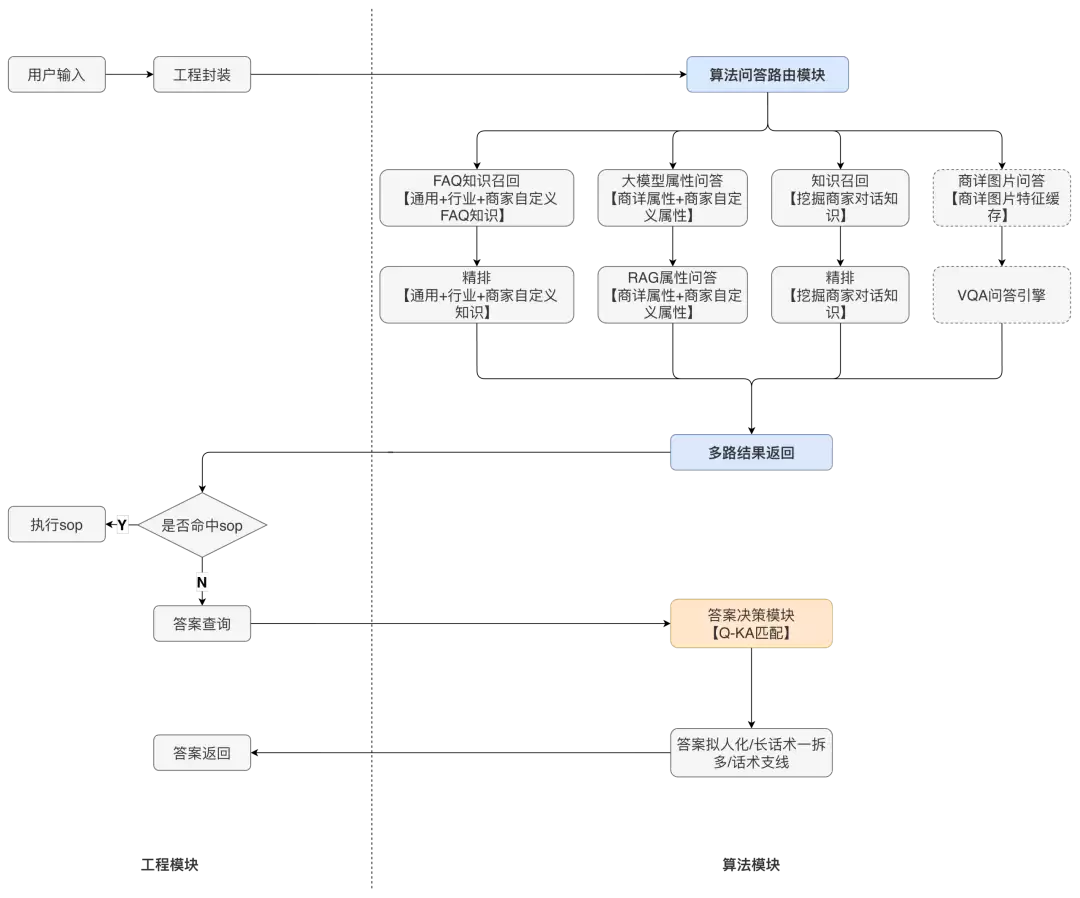
传统的“意图分类 + NER + 对话管理 + FAQ 召回 + 重排”的流水线架构,存在明显局限:
- 传统结构存在上限:无法处理多步骤任务,上下文衔接不畅,无法进行复杂的多轮对话。
- SOP 人工维护成本高:场景中的问法无法穷举,导致标准操作流程(SOP)的维护成本极高。
- 多模型运维成本高:多套小模型分头部署,牵一发而动全身,运维成本极高。
- 会话拟人度 / 流畅度不佳:出话单一,无法复刻优秀人工客服的决策和话术能力。


Agent 智能客服的挑战
在向Agent架构演进的过程中,也面临新的挑战:
- 场景复杂指令优化成本高:场景复杂、知识流程繁琐,针对长尾案例的提示工程(PE)优化成本高昂。
- 长 Context 多轮能力不足:结合用户多样性需求和长历史上下文的多轮决策/协商,对模型能力要求极高,挑战较大。
- 对齐人工拟人化能力不足:人工回复多样性高,昵称、话术、表情、模态运用灵活,需要“人工辅助Agent”进行对齐。
- 多轮半双工下消息控制:模型推理时长较长,在半双工环境下,消息打断、上下文话题切换的控制难度较大。

三、客服 Agent 多轮协商优化(高可控性 PE 自动化)
单场景架构演进
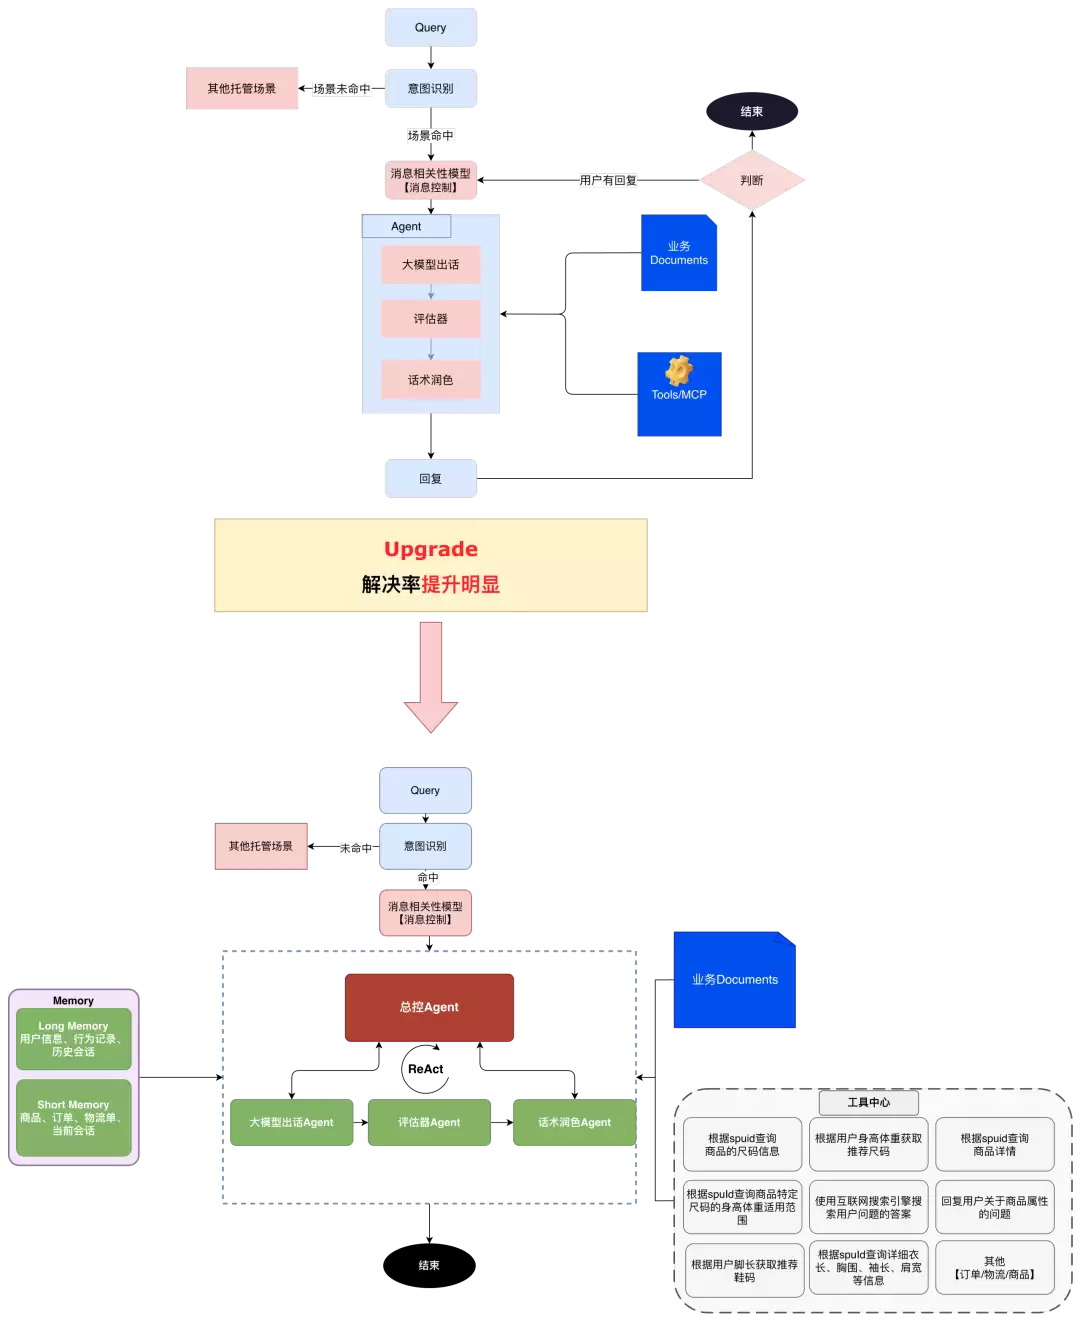
第一阶段:Single-Agent(单 Prompt)
最初基于Qwen的Single-Agent架构,存在两个主要问题:
- Prompt过长,模型指令遵循能力有限。
- 串行Pipeline无法实现Agent的多轮ReAct(思考-行动)模式。
第二阶段:Multi-Agent(渐进式披露)
为解决上述问题,团队采用了AutoGen的Multi-Agent架构,引入多个专用Agent:
- 总控 Agent:负责任务调度与流程管控。
- 出话 Agent:负责生成最终回复话术。
- 评估器 Agent:对输出质量进行实时评估。
- 润色 Agent:提升回复的自然度和拟人感。
通过`SelectorGroupChat`模式实现动态调度,解决率提升明显。
跨场景 Harness 架构
为解决跨场景复用问题,进一步演进至Harness 架构。其核心能力包括:
- 跨会话 Memory:支持用户历史上下文记忆。
- 上下文压缩与轨迹压缩:有效管理长对话,节省Token成本。
- 总控 Agent 管理:提高回复的可控性。
- 数据飞轮驱动模型持续优化。
- Skill 自动化生成(正在推进中)。

数据飞轮:PE 自动化与模型训练
PE 自动化优化
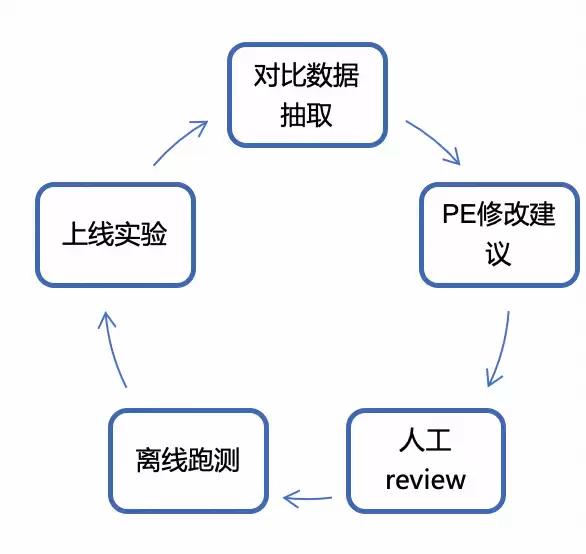
人工Prompt Engineering存在明显痛点:时间成本高、多个case引发Prompt冲突与歧义、Token成本和指令遵循能力有限。为此,团队构建了PE自动化流水线:
- 对比数据抽取:LLM抽取转人工case中Agent回复(Bad)和人工回复(Good)作为对比样本。
- PE 修改建议:LLM分析Prompt存在的问题,并提出修改建议。
- 人工 Review:人工标注并检查修改建议是否可行。
- 离线跑测:合并修改建议,跑测同批数据,验证效果。
- 上线实验:积累数据,持续优化Prompt。
效果验证:


数据飞轮-模型训练
通过DPO 模型训练飞轮,利用“LLM-as-a-Judge”搜集回流数据并重新训练:
- 训练能否回复判别模型、回复正确性模型、是否拟人判别模型。
- 构造chosen(优选)和reject(拒绝)样本。
- 训练专门的润色模型。

四、RL 决策训练:让 Agent 学会"正确决策"
训练框架
RL训练框架主要分为三大模块:
数据基建
- 采集线上反馈数据,通过策略埋点构造Multi-turn RL训练数据。
- 利用专家模型生成决策理由,进行CoT-RL(思维链)训练。
- 部署MCP Server,实现实时Tools调用。
模型训练
- Cold-start SFT 预热:通过监督微调为强化学习提供良好的初始策略。
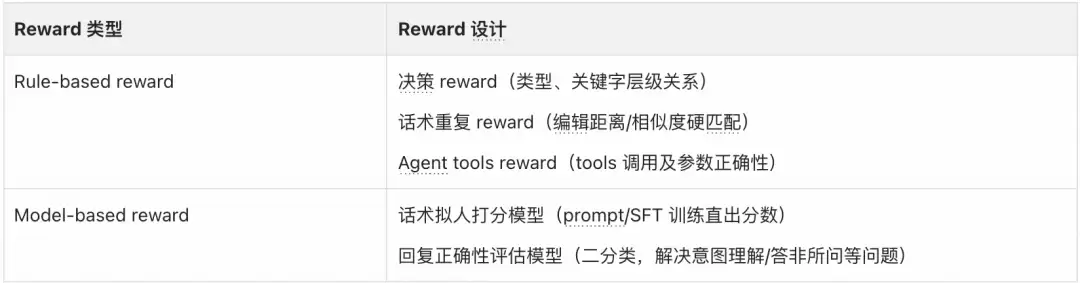
- 可验证奖励:使用Rule-Based-Reward(基于规则的奖励)对模型行为进行约束。
- 生成式奖励:使用Model-Based-Reward(基于模型的奖励)评估模型输出的质量。
- GRPO 训练:采用GRPO(Group Relative Policy Optimization)算法进行训练。
评测体系
- LLM-as-a-Judge(大模型作为裁判)。
- 人工评测。
- 用户模拟器一致性评测。
对抗 Reward Hacking
- 优化Reward函数,避免模型钻空子。
- 解决数据有偏问题,确保训练数据代表性。
- 增加思考过程,即CoT训练,让模型学会推理。
训练效果对比
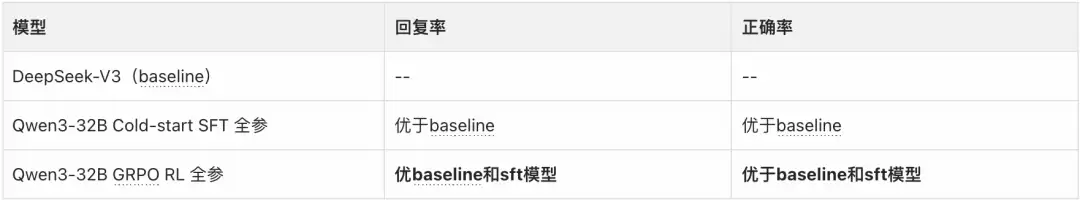
实验
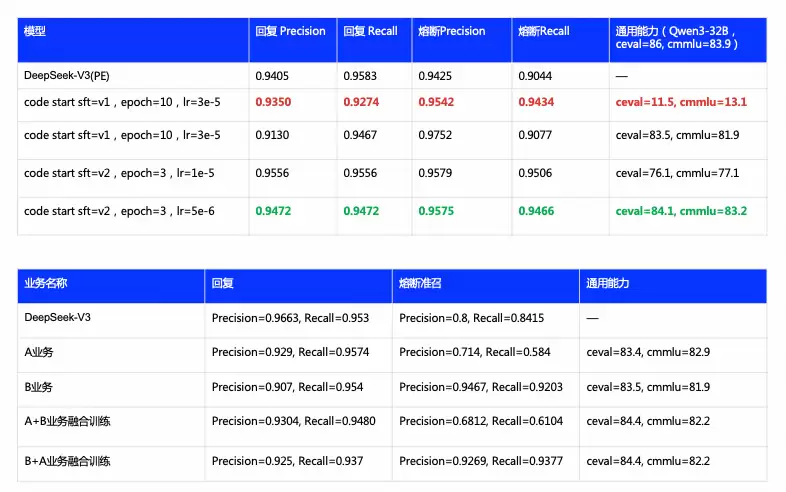
消融实验
- 不同epoch(训练轮次)对比。
- 不同cold-start sft底座对比。
- 不同lr(学习率)对比。
业务干扰度消融实验
- A业务。
- B业务。
- A业务 + B业务(混合训练效果)。
RL 训练减少灾难性遗忘
测试标准:C-Eval、CMMLU。
规避方法:
- 降低学习率(全量训练 ≤ 5e-5)。
- 通过eval-step实时监控通用基准指标。
- 限制训练2~4 epoch。
- 控制数据比例:模型自推理 VS 模型依赖Tool调用 = 1:1。
五、情感温度:人类经验对齐模型蒸馏
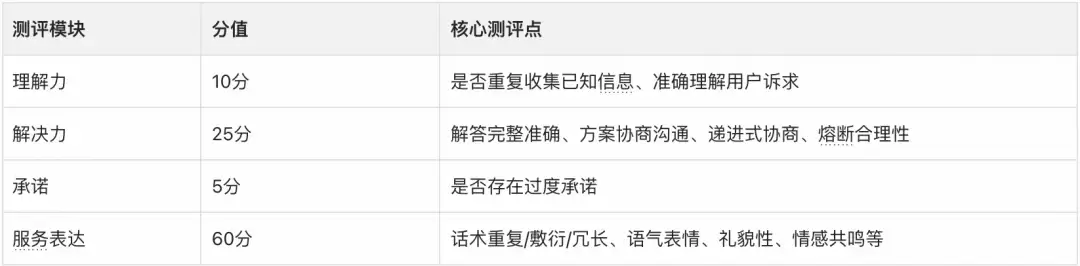
服务测评标准
为了量化模型的服务质量,团队建立了完整的百分制测评体系:
模型蒸馏训练
三种训练模式协同工作:
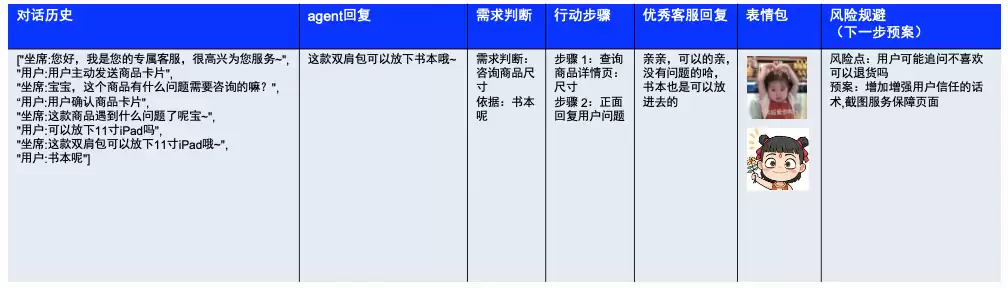
- CoT-RL 策略蒸馏:蒸馏优秀客服的决策逻辑,让模型学会“像优秀客服一样思考”。
- DPO 话术蒸馏:对齐对话语气、减少重复、规范表情包和称谓的使用。
- 表情模块:通过表情分类 + 语境分析,精细化控制表情使用时机,提升回复的生动性。
表情分类体系:开场欢迎 / 积极开心 / 思考疑惑 / 抱歉安抚 / 提醒强调 / 期待等待 / 完成确认 / 正在努力 / 物流配送 / 价格优惠 / 对接售后 / 结束感谢。
人工对齐效果
经过对齐训练,模型评分接近Top5%优秀人工水平,在情感表达和沟通技巧上取得了显著进步。
六、多轮消息流控制:半双工对话逻辑设计
消息收发模式
智能客服场景具有特殊性:用户可随时发送消息(全双工),但Agent在回复期间不应被打断(半双工)。因此,系统设计为:
- 用户→Agent:全双工,用户可随时打断。
- Agent→用户:半双工,Agent回复不可打断。
多消息处理策略

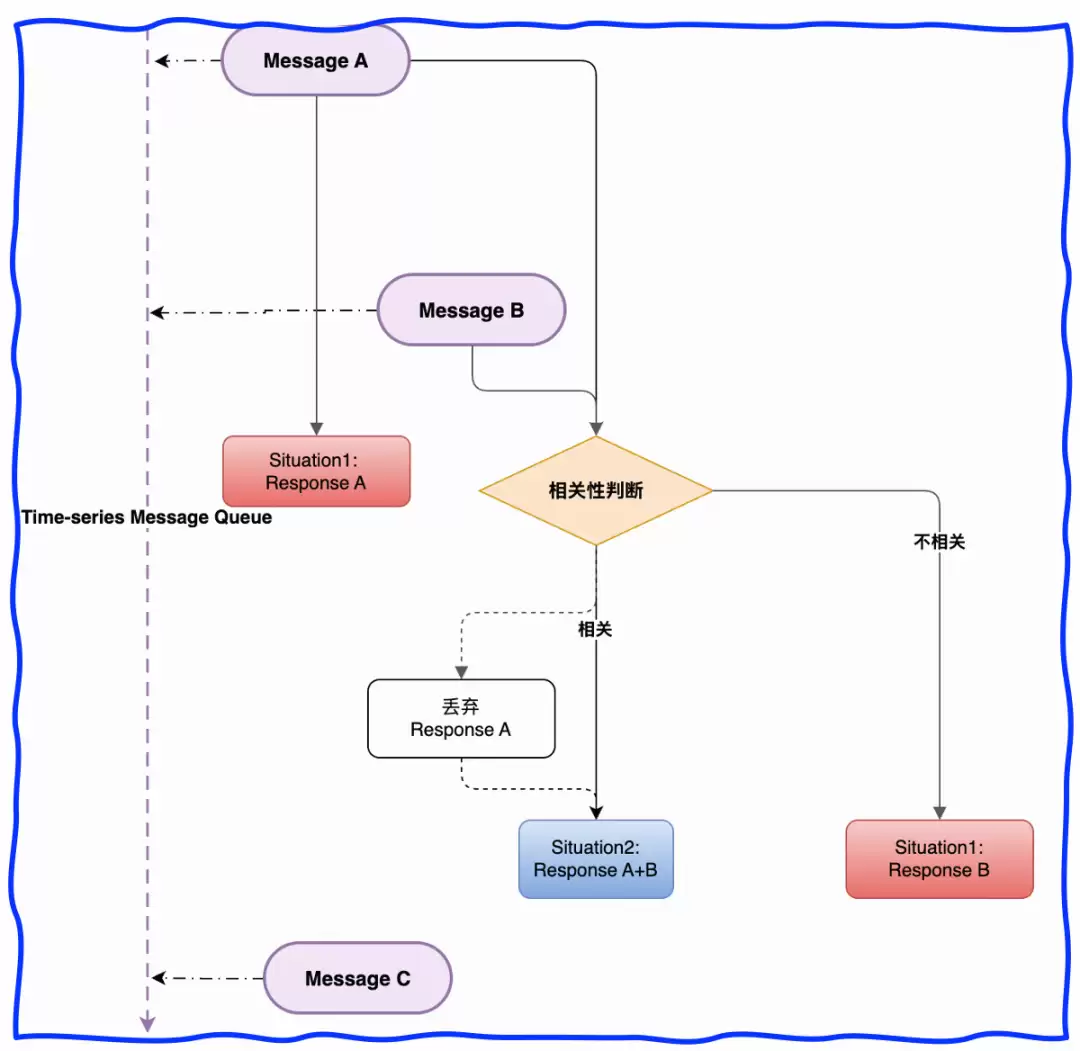
为了实现精准的消息合并/切分判断,团队训练了专门的分类模型:
- 数据采集:拉取线上用户连续消息进行人工标注。
- 数据增强:利用LLM对负样本进行扩写,增加数据多样性。
- 模型训练:使用Qwen3-4B模型进行分类训练,判断用户连续发送的多条消息是应该合并处理还是切分处理。
七、总结与展望
本次实践总结
本次分享围绕以下核心技术展开:
- 应对客服Agent挑战的架构设计(从Single-Agent演进到Multi-Agent,再到Harness架构)。
- 构建高可控性数据飞轮(PE自动化与DPO训练)。
- 通过RL策略训练和人工经验对齐,提升模型决策能力与情感温度。
- 设计多轮半双工消息流控制机制,保障对话的流畅与稳定。
未来展望


免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 字节跳动发布豆包工作 与飞书深度打通构建企业级Agent
- 时间:2026-08-25
-

- AI通话录音手机续航实测能用多长时间
- 时间:2026-08-23
-

- Adobe Photoshop 27.7桌面版发布 移除工具支持端侧AI运行 苹果Mac需24GB内存
- 时间:2026-08-23
-

- 育碧远哭7测试AI生成画面效果 知情者评价其表现不佳
- 时间:2026-08-23
-
- AMD锐龙9 PRO 9965X3D及锐龙AI PRO 400商用台式机2026Q3上市
- 时间:2026-08-22
-
- 思必驰冲刺上市,AI语音行业护城河为何消失
- 时间:2026-08-21
-
- 道题看懂AI商业趋势与未来发展方向
- 时间:2026-08-21
-
- AI清理500GB空间实测:Agent暂时还替代不了电脑管家
- 时间:2026-08-21
精选合集
更多大家都在玩
热门话题
大家都在看
更多-

- 广式月饼中的经典口味是什么
- 时间:2026-09-24
-

- 月光闪耀,食神驾到!《闪烁之光》中秋【宴月】专服重磅开启,万份美食免费送!
- 时间:2026-09-24
-
- 蚂蚁新村小课堂今日答案9月24日 煤提质工这一职业诞生于哪种时代背景
- 时间:2026-09-24
-
- 蚂蚁新村2026年9月24日答案最新
- 时间:2026-09-24
-
- 蚂蚁庄园答案2026年9月25日
- 时间:2026-09-24
-
- 蚂蚁庄园今天答题答案2026年9月25日
- 时间:2026-09-24
-
- 今日小鸡庄园答案2026.9.25
- 时间:2026-09-24
-
- 蚂蚁庄园今日答案2026年9月25日
- 时间:2026-09-24