AI知识库从零搭建指南:个人wiki与企业RAG方案
时间:2026-07-18 | 作者:电竞小硕 | 阅读:0你的业务问题,通用AI真的懂吗?
你的电脑里存着几百份文档,但每次要用的时候,翻遍文件夹也找不到。通用AI给的答案看起来头头是道,但对你的业务毫无用处。问题出在哪?又该怎么解决?这其实是很多团队都会遇到的尴尬场景。
更具体一点说:老板安排一件事,你给新人讲了一遍,下一个人来了又要从头讲。销冠的经验传不下去,客户的问题翻来覆去就那几类,每次都要重新查资料。通用AI工具用完之后感觉一致——它说的没错,但对你的业务没用。你让它回一个客户问题,答案头头是道,但一看就知道这根本不是你们公司的产品、不是你们的服务方式。
说白了,它根本不了解你。
通用大模型是用公开资料训练的,可以说是“见多识广但刚入职”,它不知道你公司的产品参数、服务流程、客户案例和写作风格。这个问题的解决方案,就叫AI知识库。
一、AI知识库的五种实现方式
AI知识库不是在整理文档,而是在给AI补上下文。决定AI回答质量的无非三样东西:模型有多强、信息有多具体、指令有多清楚。
五种实现方式,像一个梯子——先踩第一级,需要了再往上走。

方式一:直接投喂
把文件上传给AI,让它基于文件回答。适合一次性小任务。问题是每次都要重新传,无法沉淀。
方式二:目录化知识库 最适合起步
先把手头资料整理成几个分类目录。建议分五类:
- 我是谁:公司介绍、品牌定位、团队背景
- 我卖什么:产品线、服务内容、和竞品的区别
- 客户常问什么:高频问题记录、真实反馈
- 做过什么:成功案例、翻车复盘
- 怎么写才对:对外内容的语气、禁用表达
然后告诉AI:遇到哪种场景,去哪个目录翻哪些文件。不需要技术基础,不用买系统。
方式三:索引型地图
文件不只归到一个类别时,让AI扫一遍所有资料,按主题画一张索引地图,然后顺着地图去找。
方式四:RAG和向量检索
资料量大到目录不够精准时,把资料按片段向量化存起来。检索时匹配语义而非关键词——你的问题是什么意思,就找意思最接近的片段。
方式五:集成到已有系统
企业级方案。把知识库能力嵌入现有的内部系统、客服平台里。
选方案的原则:够用就好。 大部分人和小团队从方式二起步完全够了。
二、三种最值得投入的应用模式
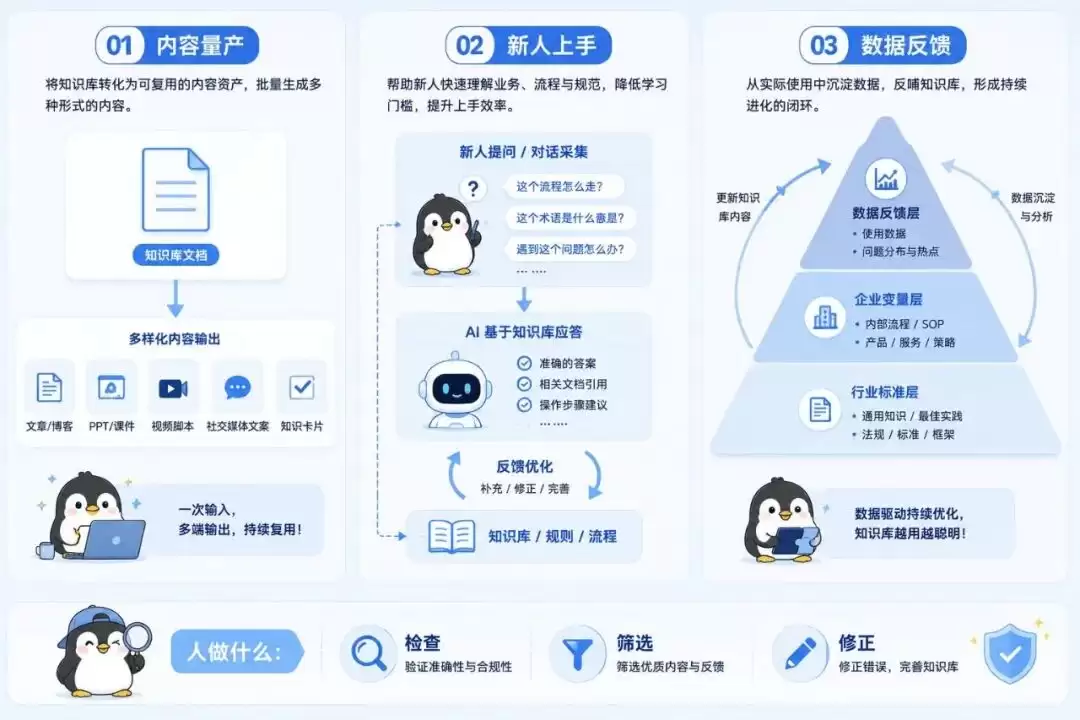
AI知识库最终要落地的出口就几个:帮新人更快上手、帮一线回答客户问题、帮内容团队批量产出。
模式一:多账号内容量产
团队资料本来就很丰富——流程文档、话术模板、项目复盘、行业知识点,但散落在不同人的电脑里。先按类型归拢到在线文档和表格里,让AI批量生成第一版——客户回复模板、选题初稿、营销文案框架。人做检查:能用的留下,生硬的挑出来改,改完放回资料库。下一次AI生成就更接近你想要的。
模式二:缩短新人应答上手周期
产品线多、客户问题没有标准答案的团队。新人要花很长时间熟悉所有场景。更有价值的做法是:先把客户真实的提问方式采集回来——从评论区、客服记录里看客户到底怎么问的。挑出高频高价值问题,结合产品信息让AI生成应答草稿。关键:人纠正AI之后把反馈写回去。这次AI把适用人群说宽了,就把限制写进规则——「不适合XX人群,XX场景必须转人工」。下次就更精准。
模式三:用数据反馈撑大内容产量
专业知识体系完整但过去依赖外包团队——花钱多、产出少、风格不稳定。搭一个三层底座:底层行业通识不能错,中间层你自己的理念和案例跟别人不一样,上层内容发出后的效果数据回流更新下面两层。AI批量出第一版,人做选择题而非填空题。
三种场景领域完全不同,但共同点一样:知识库不是为了摆整齐,是回到业务里——答得更快、写得更顺、教得更省力。
三、个人知识库:LLM Wiki的实现路径
核心思路
个人知识库的价值不是收藏,是输出的时候能找到、能引用、能举一反三。核心思想:知识只编译一次,持续更新——不是每次现场去搜,而是读过的好东西、产生的想法、踩过的坑,都被编译成结构化的知识页面,下次直接调取。 其中,Obsidian是一个非常流行的选择,它的核心连接功能非常好用,一打开关系图谱就能看到各种资料之间的关系。

三层架构
这个知识库架构可以分成三层:

知识库/
├── raw/ ← 原始素材
│ ├── articles/ ← 网页文章、博客
│ ├── papers/ ← 论文
│ └── transcripts/ ← 对话记录
├── wiki/ ← 知识页面
│ ├── 01_技术/ ← AI相关
│ ├── 02_科研/ ← 论文
│ ├── 03_创意方法论/ ← 灵感
│ ├── 04_工作方法/ ← 内容创作、效率、知识管理
│ ├── 05_产品与商业/ ← 产品想法
│ └── 06_技术参考/ ← 架构规格、参考实现
├── SCHEMA.md ← 协议(告诉AI怎么干活)
├── index.md ← 全局索引
├── log.md ← 操作日志
└── 写作规范.md ← 风格约束
raw/ 是知识来源——每次读到有价值的内容创建源捕获文件,只追加不修改。wiki/ 是编译后的知识页面,按知识域组织,一眼能找到资料在哪。SCHEMA.md 是操作协议,定义触发词、摄取工作流、分类规则、质量要求。
摄入工作流
说一句「把这个总结到知识库」,AI自动走四步:分析归类 → 生成wiki页面 → 更新索引日志 → 自动Lint查断链和遗漏。
持续反馈比一次性搭建更重要
搭起来只是第一步。核心循环:资料进去 → AI试用 → 人发现不对 → 改规则 → 下次少错一点。 AI写错了不只改当前页面,要判断是单页问题还是系统问题;写得太生硬就把句式加入禁用清单;少了知识点就补raw条目。不是一次性整理,是持续校准的系统。
四、RAG知识库的实现路径
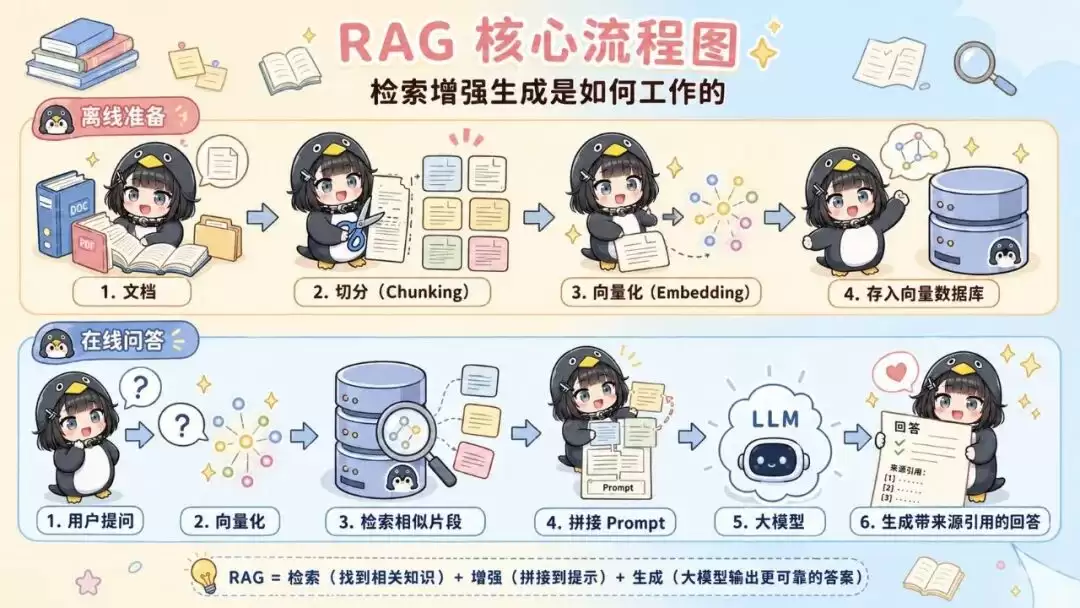
个人用目录+wiki就够了。企业资料量大之后,需要AI按语义找资料——这就是RAG(检索增强生成)。
RAG是什么
用户提问 → 去知识库找到最相关的片段 → 连同问题一起塞给大模型 → 基于参考资料回答。让AI先翻书再答题,而不是凭记忆瞎猜。
RAG的六层演化
第一层:基础检索(Naive RAG) — 文档切片 → 向量化 → 相似度搜索 → 拼进prompt。简单但检索质量不稳定。
第二层:检索质量提升 — 关键词+语义两条管线并行(Hybrid Search),结果合并排序,两路都命中加分。
第三层:自我纠错 — 加入Re-ranking重排序和Self-Reflection自检,回答生成后自查准确性。
第四层:结构化知识 — 引入知识图谱(GraphRAG),不只搜文本,还提取实体和关系。
第五层:智能体驱动(Agentic RAG) — 多步推理:先搜A,不够再搜B,综合多轮结果后回答。
第六层:能力扩展 — 多模态检索、跨语言、实时联网。
实践:一个Hybrid Search RAG系统的真实实现

实际搭建时,上面图片所示的方案是一个不错的选择。核心选择是Hybrid Search而非纯向量检索——因为小规模知识库上纯向量效果不稳定,用户问法和文档写法总有差距,关键词检索能兜底。图片导入做了VLM视觉理解(主路径)+ tesseract.js OCR(备用)的双路架构。最关键的是System Prompt约束——明确告诉模型「只能使用参考资料,不确定就说不知道,不要编造」。同时把 temperature 设到0.1。 temperature是什么?简单说就是控制AI回答时「有多敢自由发挥」的一个参数,范围0~2。值越高,回答越有创意但也越容易跑偏、编造事实;值越低,回答越保守、越死扣你给的材料。知识库问答不是写诗——要的是准确,不是创意。所以设到0.1,相当于告诉模型:老老实实按参考资料来,别自己添油加醋。
五、从今天开始:两条可以直接复制给AI的命令
5.1 建一个你自己的wiki知识库
把下面这条消息完整复制给你的AI工具(Claude Code、Codex、WorkBuddy等均可),它会帮你建好一切:
请帮我搭建一个个人的LLM Wiki知识库。按以下步骤执行:
>
1. 创建目录结构
在我的工作目录下创建以下结构:
知识库/
├── raw/(原始素材,只读)
│ ├── articles/
│ ├── papers/
│ └── transcripts/
├── wiki/(编译后的知识页面)
│ ├── 01_技术/
│ ├── 02_科研/
│ ├── 03_创意方法论/
│ ├── 04_工作方法/
│ ├── 05_产品与商业/
│ └── 06_技术参考/
├── index.md(全局索引)
├── log.md(操作日志)
└── 写作规范.md(禁用「在当今时代」「总而言之」等AI句式)
>
2. 设定操作协议
以后每次我跟你说「总结到知识库」,你自动完成:
- 分析内容 → 按决策树归类 → 判断跟已有页面的关系
- 生成wiki页面,遵守写作规范,标注来源和日期
- 更新index.md和log.md
- 自动检查断链、孤立页面、index遗漏
>
3. 反馈规则
- 我纠正你 → 判断是单页问题还是系统问题
- 写得太生硬 → 把句式加入禁用清单
- 少了东西 → 检查raw条目是否也遗漏了
>
现在请创建这个目录结构,然后告诉我准备好了。
5.2 搭一个最基础的Hybrid Search RAG库
把下面这条消息完整复制给你的AI编程工具,它会带你从零搭好:
请帮我搭建一个基于Hybrid Search的RAG知识库系统。技术栈:Python + Supabase pgvector + Jina Embeddings。
>
任务1:环境准备
- pip install langchain langchain-text-splitters supabase openai
- 注册Supabase(免费层),创建项目
- 在Supabase SQL Editor执行以下SQL(先启用pgvector扩展,再建两张表):
>
create extension if not exists vector with schema extensions;
create table documents (id bigint primary key generated always as identity, title text not null, category text, source_url text, created_at timestamptz default now());
create table document_chunks (id bigint primary key generated always as identity, document_id bigint references documents(id) on delete cascade, chunk_index int not null, content text not null, embedding vector(1024), metadata jsonb default '{}'::jsonb);
>
任务2:文档导入管线
- 解析文档:Markdown直接读、PDF用PyMuPDF、网页用requests+BeautifulSoup
- 用LangChain RecursiveCharacterTextSplitter切分,chunk_size=500,chunk_overlap=80
- 调Jina Embeddings API把每个chunk转成1024维向量,写入document_chunks表
>
任务3:Hybrid Search检索
- 关键词检索:Supabase全文搜索,中文做2-4字n-gram分词
- 语义检索:Jina向量化 + pgvector余弦相似度,召回top 8×2条
- 合并排序:关键词分×0.5 + 向量相似度×0.5,两路命中额外+0.15,去重取top 6
>
任务4:问答生成
- System Prompt:「只能使用以下参考资料,不确定就说不知道,不要编造」
- temperature=0.1,回答格式:直接回答→可确认事项→未覆盖事项→建议
- 每条回答标注引用了哪些chunk
>
任务5:测试
用10份真实资料导入,准备5个已知答案的问题验证:引用是否正确、回答是否比通用ChatGPT更贴近你的资料、没覆盖时是否诚实说不知道。
>
请按任务顺序逐一完成,每完成一个告诉我进度。
写在最后
AI知识库不是一个高大上的企业系统。它就是让你手里的资料、脑子里的经验、踩过的坑、做对的判断,变成AI能理解、能调用的东西。
第一版不必从复杂的RAG开始。找一个最痛的小场景,建一个目录,放一批资料进去,拿一个真实问题测试。跑通一个,你就知道这条路走得通。
以后重要的不是你会写一句prompt,而是每次做完一件事都能把经验留下来。下一次AI不是从网上重新猜,而是从你的积累里接着往下做。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 字节跳动发布豆包工作 与飞书深度打通构建企业级Agent
- 时间:2026-08-25
-

- AI通话录音手机续航实测能用多长时间
- 时间:2026-08-23
-

- Adobe Photoshop 27.7桌面版发布 移除工具支持端侧AI运行 苹果Mac需24GB内存
- 时间:2026-08-23
-

- 育碧远哭7测试AI生成画面效果 知情者评价其表现不佳
- 时间:2026-08-23
-
- AMD锐龙9 PRO 9965X3D及锐龙AI PRO 400商用台式机2026Q3上市
- 时间:2026-08-22
-
- 思必驰冲刺上市,AI语音行业护城河为何消失
- 时间:2026-08-21
-
- 道题看懂AI商业趋势与未来发展方向
- 时间:2026-08-21
-
- AI清理500GB空间实测:Agent暂时还替代不了电脑管家
- 时间:2026-08-21
精选合集
更多大家都在玩
热门话题
大家都在看
更多-

- 广式月饼中的经典口味是什么
- 时间:2026-09-24
-

- 月光闪耀,食神驾到!《闪烁之光》中秋【宴月】专服重磅开启,万份美食免费送!
- 时间:2026-09-24
-
- 蚂蚁新村小课堂今日答案9月24日 煤提质工这一职业诞生于哪种时代背景
- 时间:2026-09-24
-
- 蚂蚁新村2026年9月24日答案最新
- 时间:2026-09-24
-
- 蚂蚁庄园答案2026年9月25日
- 时间:2026-09-24
-
- 蚂蚁庄园今天答题答案2026年9月25日
- 时间:2026-09-24
-
- 今日小鸡庄园答案2026.9.25
- 时间:2026-09-24
-
- 蚂蚁庄园今日答案2026年9月25日
- 时间:2026-09-24