阿里内部9.7k Stars向量数据库开源,免服务import即用
时间:2026-07-18 | 作者:白桃企划师 | 阅读:0做 RAG 应用时,向量数据库这一步,很多人第一反应就是部署 Milvus 或起一个 Qdrant 容器。
但说实话,很多场景真的不需要这么重。
比如:
- 本地跑个 Agent 的记忆库
- 笔记软件的语义搜索
- 移动端 App 的离线检索
这些场景里,专门起一个数据库服务、维护一套部署、处理网络延迟,有点杀鸡用牛刀的感觉。
Zvec:进程内向量数据库
Zvec 是阿里巴巴开源的一个进程内向量数据库。
它的定位很明确:不需要起服务。pip install 之后,直接在代码里 import 就能用。
这跟 SQLite 之于关系型数据库,是同一个路数。
它在阿里内部生产环境里跑了一段时间后才开源,不是实验室里打个转就放出来的东西。
先看性能数据
这是官方用 VectorDBBench(向量数据库社区广泛采用的开源基准测试框架)跑出的 Cohere 1000 万条 768 维向量的测试结果:
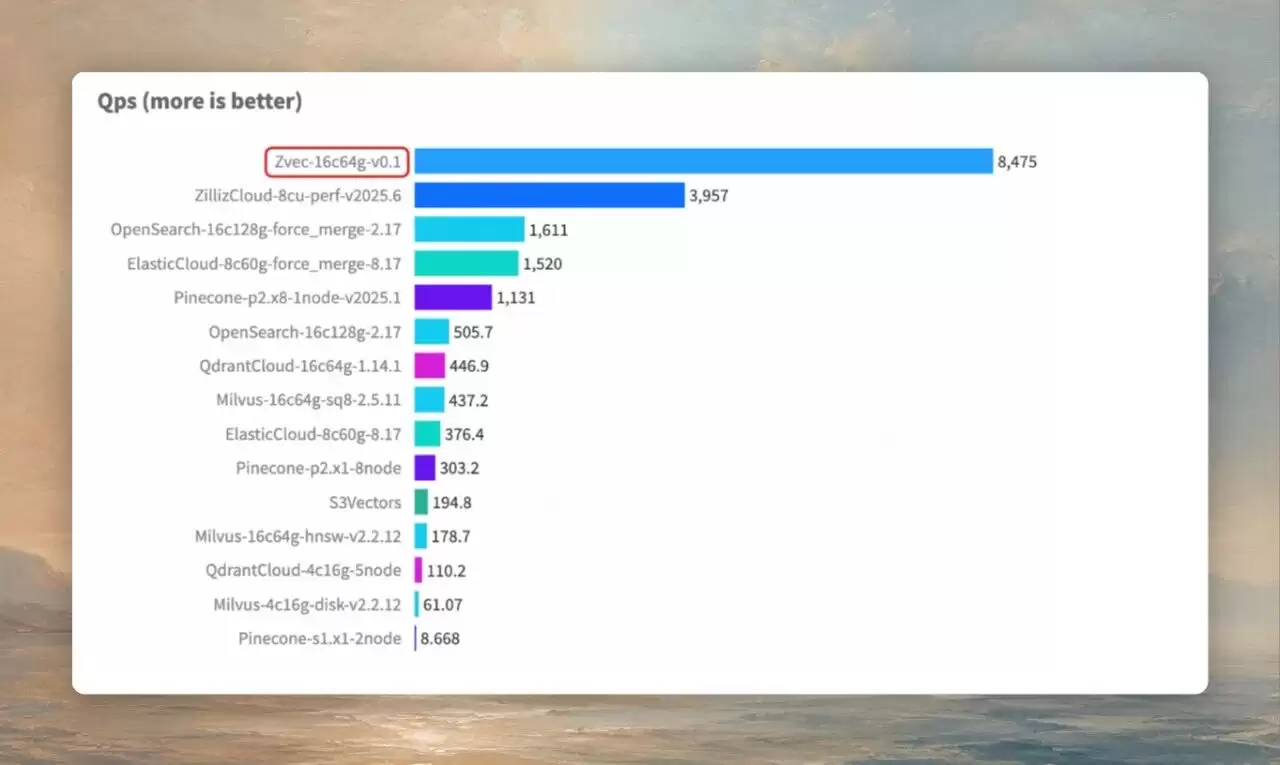
横轴是并发数,纵轴是 每秒查询数(QPS)。
这是在单台 16 核 64GB 内存的机器上跑出来的结果,没有依赖额外的存储或网络服务。
召回率(搜索结果的准确度)同步测量:
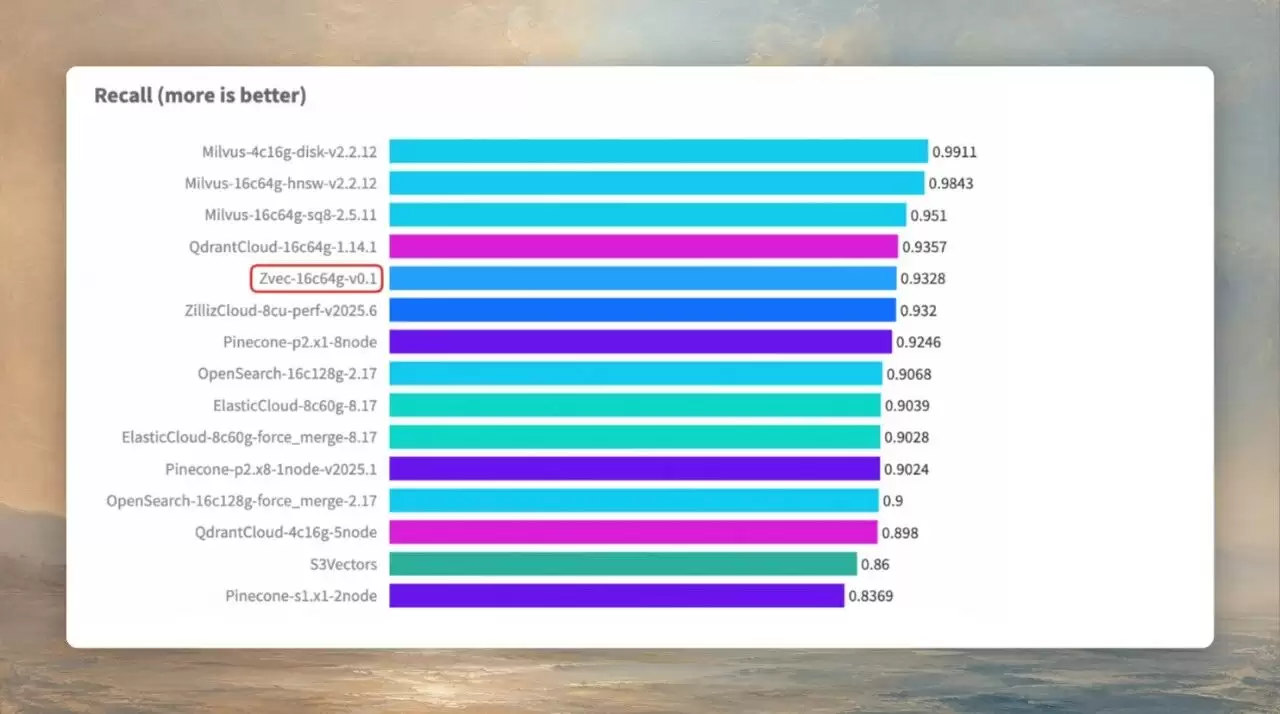
千万级向量,毫秒级检索。
这两张图说明:进程内架构不代表性能妥协。
五行代码,从零开始一个向量库
import zvec
# 定义 collection schema
schema = zvec.CollectionSchema(
    name="example",
    vectors=zvec.VectorSchema("embedding", zvec.DataType.VECTOR_FP32, 4),
)
# 创建 collection,本地文件存储
collection = zvec.create_and_open(path="./zvec_example", schema=schema)
# 插入文档
collection.insert([
    zvec.Doc(id="doc_1", vectors={"embedding": [0.1, 0.2, 0.3, 0.4]}),
    zvec.Doc(id="doc_2", vectors={"embedding": [0.2, 0.3, 0.4, 0.1]}),
])
# 按向量相似度搜索
results = collection.query(
    zvec.VectorQuery("embedding", vector=[0.4, 0.3, 0.3, 0.1]),
    topk=10
)
没有连接字符串,没有起服务,没有等待网络往返。
./zvec_example 是本地一个目录。关掉进程,数据还在,下次打开继续用。
这才是进程内架构的真正魅力所在。
让 Agent 帮你接进项目
直接告诉你的 Claude Code 或 Cursor:
帮我在这个 Python 项目里集成 Zvec 作为本地向量库,
用来存储文档的 embedding,支持语义搜索和过滤检索。
Schema 设计:每个文档需要 id、embedding 向量、和一个 source 字段用于过滤。
参考文档:https://zvec.org/en/docs/db/quickstart/
Node.js 项目:
帮我用 @zvec/zvec 给这个 Node.js 项目加一个本地向量存储,
不需要起 Docker,直接 npm install 用,
用来做 RAG 应用的文档检索
Agent 会处理好 schema 设计、安装依赖、写好增删改查的封装代码。
稀疏向量和稠密向量,一次查询里混着用
这一点上,Zvec 做得比不少同类工具更完整——原生支持混合检索(Hybrid Search)。
不需要外接关键词搜索引擎,再手动做结果合并。
稠密向量(Dense Vector)抓的是语义相似度——"猫"和"小猫"在向量空间里离得近。
稀疏向量(Sparse Vector)类似传统的关键词检索——专有名词、产品型号这类精确匹配场景,稠密向量反而不如关键词准。
Zvec 支持在一次查询里同时用结构化过滤条件(比如按时间、来源筛选)加向量相似度排序。
不需要先用 SQL 过滤,再单独调向量搜索拼接结果,整个流程干净利落。
WAL 保证数据不丢,多进程能同时读
进程内数据库最让人担心的事情是:进程崩了,数据是不是就没了?
Zvec 用 Write-Ahead Logging(预写日志) 保证持久性。
写操作先落日志,再生效。进程崩溃或断电后重启,数据可以从日志恢复,不会丢。
并发模型是 "多读单写":
- 多个进程可以同时打开同一个 collection 做查询
- 但写入操作是单进程独占的
这个设计和大多数嵌入式数据库(SQLite 也是类似模式)一致。
适合"一个进程写、多个进程读"的场景,比如一个后台任务在更新索引,多个 API 进程在提供查询服务。
哪里都能跑
作为进程内库,Zvec 的运行环境就是你代码运行的环境——不需要额外部署:
- Jupyter Notebook:数据科学场景,装完直接在 notebook 里跑实验
- CLI 工具:命令行小工具里嵌入语义搜索,不依赖外部服务
- 服务端:和应用进程一起部署,减少一个网络跳数
- 边缘设备:v0.4.0 刚加上了 iOS 和 Android 的官方 SDK 支持
Dart/Flutter 的官方 SDK 也在 v0.4.0 里发布了。
FFI 绑定打包好了 Android(arm64-v8a)和 iOS(arm64)的预编译版本,不需要手动编译 native 代码。
这意味着可以直接在手机 App 里做本地语义搜索,完全离线。
安装
# Python(3.10–3.14)
pip install zvec
# Node.js
npm install @zvec/zvec
支持平台:Linux(x86_64、ARM64)、macOS(ARM64)、Windows(x86_64)。
源码编译支持更多平台,包括 iOS 和 Android。
几个真实的不足
单机单进程写入是设计限制,不是 bug
如果你的场景需要多个进程同时写入同一份数据(比如分布式爬虫往同一个向量库灌数据),Zvec 的"单写"模型会成为瓶颈。
这种场景适合 Milvus 或 Qdrant 这类客户端-服务端架构的数据库,不是 Zvec 的目标场景。
没有内置的分布式能力
Zvec 的定位就是单机进程内库。
没有分片、没有副本、没有跨机器的数据分布。
数据量大到单机内存放不下,或者需要高可用容灾,需要换方案。
生态和工具链还在早期
v0.4.0,7 个正式发布版本。
相比 Milvus、Qdrant、Chroma 这些更早进入市场的项目,集成生态(LangChain、LlamaIndex 这类框架的官方适配器)还不够丰富。
遇到问题,能搜到的资料相对少。
topK 上限调整是最近才放开的
v0.4.0 才放宽了 topK 的上限限制,用来支持更大规模的召回场景。
如果你用的是更早的版本,大批量召回可能会遇到限制,建议直接升级到最新版。
总结
Zvec 解决的问题很具体:不是所有需要向量搜索的场景,都需要一个独立部署的数据库服务。
比如:
- 本地 Agent 的记忆系统
- 笔记软件的语义搜索
- 移动端离线检索
- Jupyter 里的实验原型
这些场景起一个 Milvus 集群是过度设计,用进程内库 import 一下就够。
阿里内部生产验证过,C++ 核心保证性能。
Python/Node.js/Dart 三端 SDK 覆盖了大多数应用场景。
混合检索和 WAL 持久化也都到位。
如果你的项目不需要分布式架构,只是想要一个嵌进代码里就能用的向量库,值得试一下。
GitHub:https://github.com/alibaba/zvec

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 字节跳动发布豆包工作 与飞书深度打通构建企业级Agent
- 时间:2026-08-25
-

- AI通话录音手机续航实测能用多长时间
- 时间:2026-08-23
-

- Adobe Photoshop 27.7桌面版发布 移除工具支持端侧AI运行 苹果Mac需24GB内存
- 时间:2026-08-23
-

- 育碧远哭7测试AI生成画面效果 知情者评价其表现不佳
- 时间:2026-08-23
-
- AMD锐龙9 PRO 9965X3D及锐龙AI PRO 400商用台式机2026Q3上市
- 时间:2026-08-22
-
- 思必驰冲刺上市,AI语音行业护城河为何消失
- 时间:2026-08-21
-
- 道题看懂AI商业趋势与未来发展方向
- 时间:2026-08-21
-
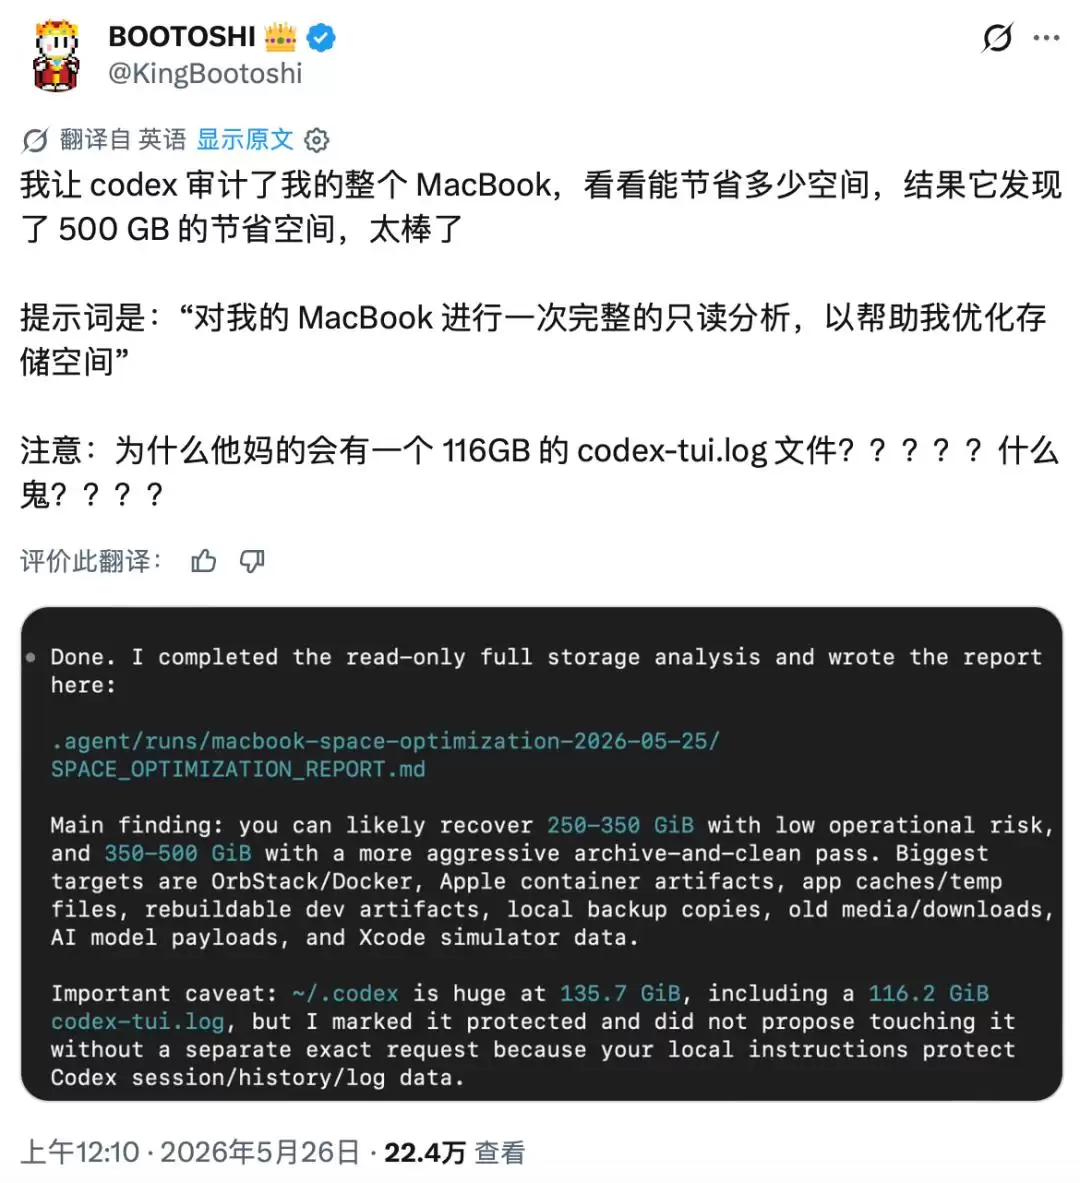
- AI清理500GB空间实测:Agent暂时还替代不了电脑管家
- 时间:2026-08-21
精选合集
更多大家都在玩
热门话题
大家都在看
更多-

- 广式月饼中的经典口味是什么
- 时间:2026-09-24
-

- 月光闪耀,食神驾到!《闪烁之光》中秋【宴月】专服重磅开启,万份美食免费送!
- 时间:2026-09-24
-
- 蚂蚁新村小课堂今日答案9月24日 煤提质工这一职业诞生于哪种时代背景
- 时间:2026-09-24
-
- 蚂蚁新村2026年9月24日答案最新
- 时间:2026-09-24
-
- 蚂蚁庄园答案2026年9月25日
- 时间:2026-09-24
-
- 蚂蚁庄园今天答题答案2026年9月25日
- 时间:2026-09-24
-
- 今日小鸡庄园答案2026.9.25
- 时间:2026-09-24
-
- 蚂蚁庄园今日答案2026年9月25日
- 时间:2026-09-24