清华团队单rollout异步优化突破强化学习千步稳定训练
时间:2026-07-19 | 作者:云端旅人 | 阅读:0如何提升强化学习(RL)的效率,在长程Agent和coding任务中,依然是绕不开的核心难题。
目前,主流的大模型强化学习(LLM RL)流水线大多采用同步、批量式的处理流程。简单来说,就是得等一整批数据都生成好了,才能进行模型更新。这种模式效率提升自然受限。
虽然异步RL能缓解同步等待的问题,但现有方法更多是盯着系统吞吐量,对训练稳定性和最终任务效果关注不够。另外,像GRPO这类方法依赖组式采样,也很难直接套用到异步Agent训练上。
针对这个痛点,清华大学KEG实验室的研究团队提出了一种新方法——单rollout异步优化(Single-rollout Asynchronous Optimization,SAO)。核心思路很直接:用单个rollout采样替代GRPO的组式采样。也就是说,每个输入任务只生成一条rollout,生成完立刻就能用于训练,从而降低离策略影响,提升模型的泛化能力。

研究结果显示,SAO能稳定训练到1000步。在Agent编码和数学推理基准上,表现持续优于GRPO及其各种变体。同时,这种单rollout的RL方法在模拟在线学习任务中,也展现出了对动态环境的适应能力。
这项工作为高效RL训练提供了一条可行路径,并已部署到GLM-5.2(750B-A40B)的Agent RL训练流水线中。
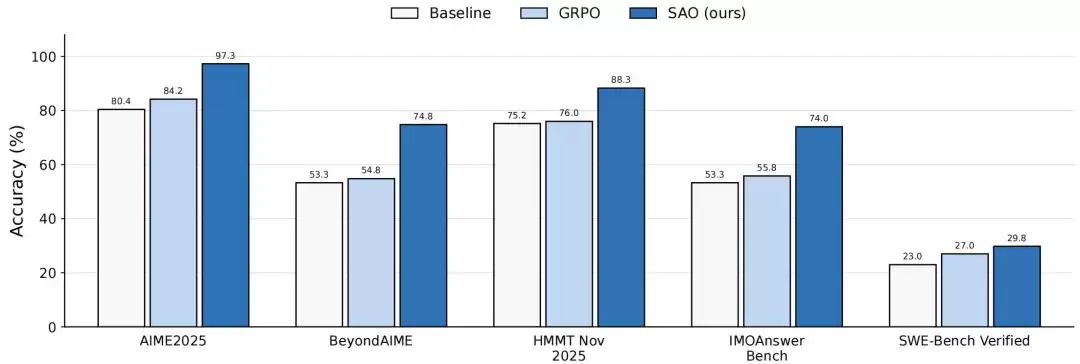
图|SAO 在推理和代码基准上的表现。
SAO是如何稳定异步训练的?
整体框架上,SAO采用单 rollout 异步优化:每个输入任务只生成一条训练 rollout,完成后立即进入训练。为了让这个流程平稳运行,SAO设计了几个关键机制:直接双边重要性采样、价值模型强化,以及多轮Agent轨迹的专门处理,同时扩大了价值模型预训练数据规模。
具体来看:
- 1.直接双边重要性采样(DIS):主要用来减少异步训练中的离策略偏差。由于rollout生成和模型训练不同步,SAO不需要保存大量历史模型,而是直接利用rollout阶段记录的token对数概率来计算重要性采样比。如果某个token的比率超出设定区间,就不参与梯度更新,相当于过滤掉那些“跑偏”的信号。
- 2.提高价值模型更新频率:目的是降低单 rollout 优化中的梯度估计方差。单rollout训练的梯度方差天然更高,因此需要更可靠的价值模型来估计优势信号。SAO把策略模型和价值模型的更新频率解耦了,策略模型每更新一次,价值模型就更新两次,以此来压低训练方差。
- 3.固定注意力模块参数:负责稳定价值模型训练。研究团队发现,价值模型的波动主要来自全注意力层,而混合专家层(MoE)相对稳定。所以,SAO在训练价值模型时,固定了注意力模块的参数,只优化MoE投影层,从而减少价值模型训练中的波动。
- 4.跳过观察信息的 token 级 GAE:用于减少多轮 Agent 轨迹中的环境反馈噪声。在多轮轨迹中,模型动作和环境反馈会交替出现。如果环境观察信息直接参与优势计算,就会引入噪声。因此,SAO会跳过环境反馈的观察信息token,只在模型生成的动作之间传播优势信号。

图|带有单 rollout 设计的 SAO 概览。
SAO的实验结果如何?
实验结果显示,SAO在数学推理、代码任务和模拟在线学习中都有更好表现。在多个基准上,它超过了对应基线模型和GRPO系列方法,并且能在较长训练过程中保持稳定。具体结果如下:
数学推理和代码任务
SAO的评估覆盖了带Python工具的奥赛数学推理、复杂数学问答和真实代码修复等场景。结果显示,SAO在这些任务中都超过了对应基线模型和GRPO方法。在AIME2025上,SAO达到了97.3%的准确率,而GRPO只有84.2%。

图|数学推理基准上的实验结果(准确率%)。
在代码任务SWE-Bench Verified上,SAO的准确率达到29.8%,也高于基线模型的23.0%和GRPO(w/ DIS)的27.0%。

图|SWE-Bench Verified 上的实验结果。
训练稳定性
从训练曲线看,SAO在不同基准上基本保持领先,训练过程也更稳定。普通GRPO较早出现性能崩溃;加入DIS后,GRPO可以稳定训练,这说明直接双边重要性采样能有效过滤偏离过大的token更新。相比之下,SAO在保持稳定的同时,训练中后期评估表现还在继续提升。

图|SAO 与 GRPO(w/ DIS)在训练过程中的性能比较。
训练动态
实验结果揭示,SAO的稳定性与其框架设计密切相关。更频繁的价值模型更新,让价值估计与真实回报更一致;固定注意力模块参数后,价值模型训练更平稳;而DIS则通过过滤偏离过大的token更新,控制了离策略影响。相比之下,基于价值模型的VAPO对照方法,如果不使用DIS,大约在90 step时就会出现训练崩溃。
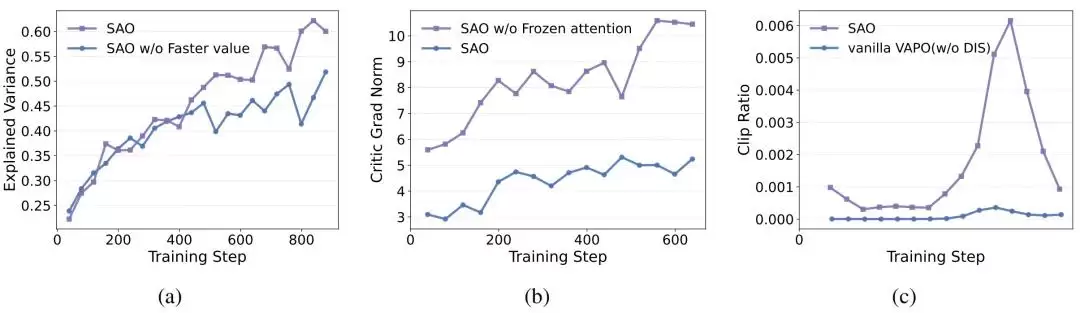
图|异步单 rollout 强化学习的训练动态。
消融实验
研究团队进一步检验了各项框架设计的作用。他们分别调整了SAO的关键组件:减少价值模型更新次数、改用全参数价值模型训练,并加入了未使用DIS的VAPO对照和滑动平均基线。结果显示,这些设置的表现都低于完整SAO。在BeyondAIME上,完整SAO的准确率为74.8%,而去掉更快价值更新后,准确率降至69.8%。

图|价值模型训练策略和 critic 更新频率的消融结果。
在线学习模拟
研究团队通过模拟在线写作任务,测试了SAO在非平稳环境中的适应能力。任务中,奖励偏好会在可爱风、中二风和古典风之间切换。结果显示,SAO能在奖励偏好切换后快速对齐新的目标风格,并在训练奖励上保持更高水平。相比之下,滑动平均基线存在明显的适应滞后,收敛水平也更低。

图|变化写作风格偏好下的在线学习模拟。
不足和未来方向
研究团队指出,尽管SAO在多类Agent任务中表现稳定,它仍存在适用范围、部署基础设施和真实在线应用方面的限制。若要扩展到更广泛的场景,还需要解决以下几个问题:
- 1.验证更广泛的适用性:当前实验主要集中在基于Qwen3-30B-A3B的大规模Agent推理、代码任务和模拟在线写作任务上。未来,仍需验证SAO是否能迁移到更小模型、非Agent类型的RLHF场景,以及奖励更密集、rollout更短的任务环境中。
- 2.完善部署基础设施:SAO依赖训练好的价值模型和rollout对数概率。未来若要实际部署,需要训练基础设施在异步生成过程中,能可靠地保存这些概率信息。
- 3.完善真实在线适应的安全保障:在线学习实验仍停留在受控的模拟环境。研究团队指出,未来若要用于真实用户场景,还需要更强的安全防护、监控机制和隐私审查。
- 4.加强发布与监控机制:研究团队指出,如果系统缺少适当的数据过滤、访问控制和评估机制,SAO相关能力可能被用于优化有害目标。未来,基于SAO的系统仍需要负责任的发布和持续监控。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- 强化学习训练上云方案:分布式GPU集群容器化实践
- 时间:2026-08-18
-
- RL-100框架融合模仿学习与强化学习提升机器人操作性能
- 时间:2026-08-12
-
- 马斯克预告下周发布Grok 4.6 改进AI监督微调与强化学习
- 时间:2026-08-05
-

- 美团搜推ASX团队顶会论文聚焦大模型Agent与强化学习前沿
- 时间:2026-07-27
-

- HIL-SERL算法:DQN与SAC混合架构实现解析
- 时间:2026-07-26
-

- 强化学习之父萨顿69岁创业打造20瓦人脑级智能体
- 时间:2026-07-19
-
- 手把手教你复现GRPO强化学习算法(含完整代码)
- 时间:2026-07-19
-
- 月之暗面放王炸!开源Kimi新模型:超新版DeepSeek R1全球第一
- 时间:2025-06-17

精选合集
更多大家都在玩
热门话题
大家都在看
更多-

- 精浓度越高消毒效果越好吗
- 时间:2026-09-22
-
- 蚂蚁庄园每日答题答案2026年9月23日
- 时间:2026-09-22
-
- “秋高气爽”主要是由于秋季空气中哪种成分减少 蚂蚁庄园今日答案9月23日
- 时间:2026-09-22
-
- 农谚“一场秋雨一场寒”描述的是秋季哪种天气现象 蚂蚁庄园今日答案9.23
- 时间:2026-09-22
-
- 蚂蚁庄园今天答题答案2026年9月23日
- 时间:2026-09-22
-
- 蚂蚁庄园答题今日答案2026年9月23日
- 时间:2026-09-22
-
- 蚂蚁庄园小课堂2026年9月23日最新题目答案
- 时间:2026-09-22
-
- 小鸡答题今天的答案是什么2026年9月23日
- 时间:2026-09-22