我们构建126个MCP工具的经验:并非Agent最佳方案
时间:2026-07-20 | 作者:怪兽小助手 | 阅读:0当整个行业都在追捧 MCP 时,我们实实在在地建了一个包含 126 个自动生成工具的 MCP Server。踩过的坑、掉过的坎,都在下面了。一个关键结论是:工具数量,不等于 Agent 的真实能力。
MCP 热潮
2025 年初,MCP(Model Context Protocol)一夜之间成了行业标配。
Anthropic 把协议推出来之后,Cursor、Claude Code、Antigra vity,各家 Agent IDE,还有一堆 SaaS 产品,几乎全都第一时间跟上。
这个协议的野心很明确——给 AI Agent 一个标准化的方式,去连接外部工具和数据源。
那段时间,但凡手上有 API 的产品,都会被同一个问题追着问:
“你们支持 MCP 吗?”
对于 Apifox 来说,这几乎是个顺理成章的选择。
为什么 MCP 看起来是标准答案
Apifox 本身积累了相当全面的 API 开发能力,列出来是一长串:
- API 文档
- Schema 定义
- Mock 服务器
- 测试用例(Test cases)
- 测试场景(Test scenarios)
- 测试套件(Test suites)
- 测试报告
- 导入/导出工作流
- 分支协作
- 等等等等
如果 Agent 真的会成为下一代的软件交互入口,那通过 MCP 把这些能力暴露出去,就是一张必须拿到的入场券。
逻辑非常直接:暴露的能力越多,对 Agent 的赋能就越强。Agent 能做的事情也就更多。
我们实际构建了什么
我们不是闹着玩的。
Apifox MCP 不是那种只有几个手写端点的简单 Demo。它是一个完整的 MCP Server,里面有相当扎实的设计。
会话系统(Session System)
MCP 客户端首先要初始化一个会话,服务器生成一个 sessionId,通过 Redis 把会话状态存下来。后续的请求继续带着 sessionId 来访问。
这不是一次性的 HTTP 调用,是协议级别的会话系统。
工具分类
工具层也不是手写几个固定端点那么简单。我们把 Apifox 的工具分成了几类:
| 类别 | 描述 | 示例 |
|---|---|---|
| 原生项目工具 | 为项目级操作构建 | 项目摘要、目录结构、资源详情 |
| 内置领域工具 | Apifox 核心功能 | 导入/导出、接口详情、测试用例、测试场景 |
| 生成的 OpenAPI 工具 | 从 OpenAPI 定义自动转换 | 126 个具有唯一标识符、路径、HTTP 方法和输入 Schema 的工具 |
最后一类,注意了:126 个生成的工具。
每一个都拥有:
- 唯一的标识符
- 特定的 API 路径
- HTTP 方法(GET, POST, PUT, DELETE……)
- 完整的输入 Schema,包含字段描述、类型和枚举值
- 定义的返回结构
渐进式披露(Progressive Disclosure)
为了减轻工具暴露的压力,我们还做了一个动态发现层:
Agent 的行为路径是:
- 首先搜索可用的接口工具(
listOpenApiEndpoints) - 然后获取特定工具的 OpenAPI 详情(
getOpenApiDetails) - 最后通过工具 ID 执行实际的 HTTP 调用(
executeOpenApi)
这是一种尝试:让 Agent 先搜索、再详情、最后执行,而不是一上来就暴露所有底层端点。
随机工具之墙(The Wall of Random Tools)
但一到实际任务,问题立刻浮出水面。
假设用户提了一个看上去很简单的请求:
“帮我为这个接口添加一个测试并运行验证。”
从实现的角度来看,这完全合理。Apifox 当然能做:
- 查找接口
- 创建测试用例
- 运行测试场景
- 生成报告
但从 Agent 的角度看,一个简单的请求,会触发一连串连续的判断:
| 决策点 | 选项 | 不确定性 |
|---|---|---|
| 从哪里开始? | 先找项目?还是先找接口? | 缺乏明确引导 |
| 该读取什么? | 读取接口详情?还是列出已有用例? | 两者看起来都合理 |
| 如何创建? | 直接用 createTestCase?还是先找用例分组? | 需求未知 |
| 如何更新? | 直接调用 update 工具?还是导入步骤后再读回? | 隐藏的工作流 |
Agent 不只是要找对工具,它得先解决“我该用哪个工具”这个问题,然后才能去解决用户的问题。
从实现层面看,这些问题都可以用工具解决。但从用户体验的角度看,它们堆成了一堵“随机工具之墙”。
四个结构性问题
通过实际测试和内部反馈,我们发现了四个结构性问题。
问题 1:工具发现成本飙升
Apifox 不是一个用十几个端点就能描述清楚的产品。
| 模块 | 细分 |
|---|---|
| 接口(Endpoints) | 列表、获取、创建、更新、删除 |
| 数据模型(Schemas) | 列表、获取、创建、更新、删除 |
| 环境(Environments) | 列表、获取、创建、更新、删除、变量 |
| Mock | 配置、启用、禁用 |
| 测试用例(Test cases) | 列表、获取、创建、更新、删除、复制 |
| 测试场景(Test scenarios) | 列表、获取、创建、更新、删除、导入步骤、运行 |
| 测试套件(Test suites) | 列表、获取、创建、更新、删除 |
| 报告(Reports) | 列表、获取、生成、下载 |
| 导入/导出 | 多种格式、选项 |
| 分支(Branches) | 列表、创建、合并、删除 |
当工具从十几个涨到几十个、上百个,Agent 在开始解决用户问题之前,必须得先解决“该用哪个”。
我们试过把工作流写进工具的 description。比如,描述里会写:
“查询接口数据之前,你需要先通过另一个工具确认项目,再用第三个工具获取项目元数据,最后才能调用当前工具。”
在小规模工具集里,这种办法确实有效。但面对一面工具墙,description 本身就成了模型的注意力负担。
写得越多,消耗的 Token 越多——而 Agent 实际按照描述去执行的可能性,反而越来越低。
问题 2:业务 Schema 侵占上下文
每个 MCP 工具,背后都带着一大堆东西。
description(工具的作用)input schema(参数、类型、必填/选填)- 字段解释(嵌套结构、约束)
- 枚举值(允许的选项)
- 返回结构(响应格式、错误处理)
做个保守的估算:
| 因素 | 数值 |
|---|---|
| 工具数量 | 100+ |
| 每个工具平均 Token 数 | ~500 |
| 总工具描述 Token 数 | ~50,000 |
用户的问题可能只有 50 个字符。但模型被迫先吞下 50,000 个 Token 的工具描述——这还只是单个 MCP Server。
这绝对不是纸上谈兵。行业数据就在那里。
Cursor 的官方博客“Dynamic Context Discovery”提供了一个关键的参考:把 MCP 工具描述、终端会话和长对话变成按需加载的上下文之后,运行时的 Token 消耗减少了 46.9%。
Trae 的做法更加直接:限制 MCP 工具数量和单个工具描述长度——工具数量上限 40,单个工具描述限制 8000 字符。
实际上,早期内部测试时,不少团队反馈 Apifox MCP 在 Trae 里存在部分工具无法被调用的问题。模型上下文有限,Agent 只能做取舍,外部工具通常是被第一个丢掉的。
所有这些解决方案都指向同一个事实:工具描述不能无限地塞进模型上下文。
问题 3:协议会话让执行链变重
Apifox MCP server 需要处理:
| 协议状态 | 描述 |
|---|---|
| MCP initialize | 客户端与服务器之间的握手 |
| sessionId generation | 会话的唯一标识符 |
| Redis session storage | 状态持久化 |
| Transport connect/close | 连接管理 |
| Session touch | 保活机制 |
| DELETE session | 完成后的清理 |
| JSON response 或 SSE 配置 | 输出格式选项 |
简单工具调用,这些成本还可以接受。但对于大量调用和频繁探索的 Agent 任务,状态管理的要求,无论是服务端还是客户端,都会被显著放大。
实现 Apifox MCP 的过程中,团队花了很多时间排查和适配不同 Agent 客户端(Cursor, Claude Code, Antigra vity, Trae……)。但协议兼容性问题依然存在,而且官方 MCP 协议还在不断发布新版本补丁。
上下游都深受其苦。
问题 4:原子化工具无法自然表达产品语义
在 Apifox 里,一个测试场景远不是简单的 steps 数组表达式能概括的。
| 组件 | 复杂性 |
|---|---|
| 导入(Import) | 来自接口或已有用例的步骤 |
| 回读(Read-back) | 导入后获取完整结构 |
| 内部用例(Internal cases) | 嵌入在步骤中的 HTTP 请求 |
| 前/后置处理器 | 请求前后的脚本 |
| 断言(Assertions) | 响应验证规则 |
| 变量提取 | 从响应中捕获值 |
| 运行时环境 | 环境选择、变量 |
| 报告验证 | 检查测试结果 |
把这些拆成多个 MCP 工具之后,Agent 得自己完成测试编排这个工作。
工具越原子化,模型就越需要理解产品内部的语义:
- 为什么导入之后要回读?
- 为什么内部用例有不同的更新标记?
- 为什么断言需要特定的比较器?
- 为什么变量提取有类型约束?
这明显超出了模型的能力边界。
结果就是,Apifox 团队不得不主动针对内部产品语义做技术调整。原子化的端点被动地增加了一层转换,只是为了适配单个 MCP 工具层的调度。
工程挑战和后期维护成本,远比想象中要高。
根本原因
这四个问题的根本原因完全一致:
MCP 擅长连接工具,但复杂的研发任务需要的不仅仅是工具连接——它们需要可执行的工程流程。
| MCP 优势 | MCP 局限 |
|---|---|
| 标准化连接 | 无法表达工作流 |
| 统一协议 | 无法引导顺序 |
| 工具暴露 | 无法强制校验 |
| 动态发现 | 无法提供判断 |
对于只有十几个明确定义的操作的简单产品,MCP 表现很好。Agent 可以合理猜测正确的工具,调用它,拿到结果。
但对于像 Apifox 这样有几十个模块、几百个操作、嵌套结构、隐藏工作流和特定产品语义的产品,单靠 MCP 只会造出一堵“随机工具之墙”,让 Agent 寸步难行。
我们的教训
| 教训 | 启示 |
|---|---|
| 更多工具 ≠ 更好的 Agent 赋能 | 工具数量是成本,而非收益 |
| 工具描述竞争上下文 | 每个工具 500 Token × 100 个工具 = 50,000 Token 的负担 |
| 会话协议增加执行开销 | 每次调用都带有协议状态管理 |
| 原子化工具需要产品知识 | Agent 必须理解内部原理才能进行编排 |
| 连接 ≠ 执行 | MCP 负责连接;CLI + SKILL 负责执行 |
转型
这个认识让我们提出了一个不同的问题:
如果 MCP 不是 Agent 赋能的最终答案,那什么才是?
我们不是否定 MCP 的价值——它提供的标准化连接,对生态很重要。但我们更需要的是:
- 表达工作流,而不仅仅是工具
- 引导 Agent 完成序列操作
- 在写入前进行校验
- 强制执行工程质量门禁
- 把复杂性吸收进系统内部
我们得出的答案是什么?CLI + SKILL。
在下一篇文章里,我们会详细聊聊这种架构转型——复杂性如何从模型上下文转移到工程系统,以及为什么这会彻底改变 Agent 赋能的底层逻辑。
核心要点
- MCP 成了“Agent 如何连接工具”的行业标准答案。
- 我们构建了 126 个 MCP 工具,原以为工具越多 = 赋能越强。
- 实际任务揭示了四个结构性问题:发现成本、上下文侵占、会话开销、产品语义。
- 根本原因:MCP 连接工具,但复杂任务需要可执行的流程。
- 当工具描述消耗上下文时,更多的工具是一种成本,而非收益。
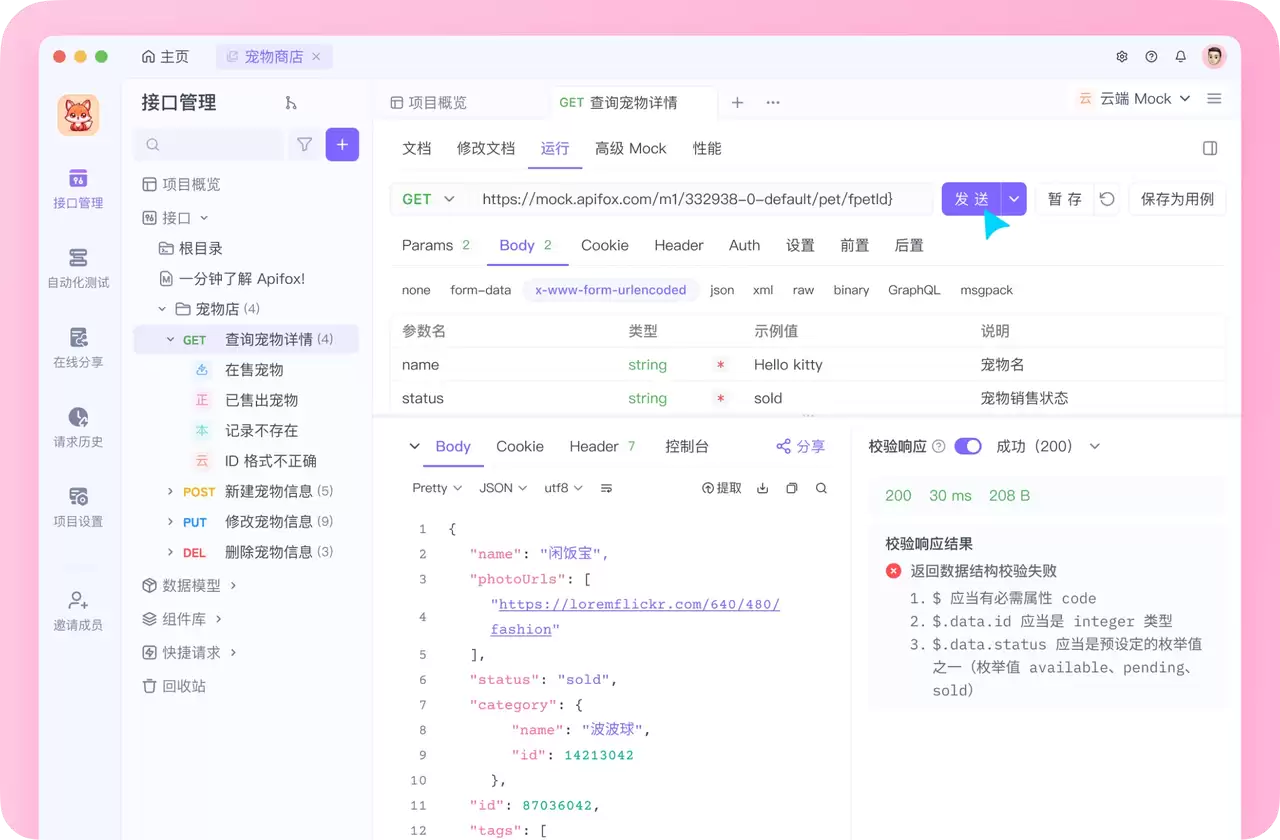

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-
- Context7 MCP中文提示词模板零基础配置教程及后台管理入口
- 时间:2026-08-08
-

- MCP Server新手快速安装与生产环境部署及账号注册登录指南
- 时间:2026-08-08
-

- Playwright MCP安装配置全攻略与AI浏览器自动化插件推荐清单
- 时间:2026-08-08
-

- Context7 MCP新手安装与多模型切换配置性能优化教程
- 时间:2026-08-08
-

- MCP Server安装配置全攻略 附显卡驱动检查方法
- 时间:2026-08-08
-

- macOS Homebrew 安装 MCP Server 环境配置 完整教程 小白也能看懂 检查清单
- 时间:2026-08-08
-
- Context7 MCP安装环境配置与工作流模板导入疑难排查清单
- 时间:2026-08-07
-

- Windows MCP Server 无代码安装教程与低内存优化
- 时间:2026-08-07
精选合集
更多大家都在玩
大家都在看
更多-

- 蚂蚁新村小课堂今日答案9月25日 福建土楼营造技艺中主要用什么作为墙体材料
- 时间:2026-09-25
-
- 蚂蚁新村2026年9月25日答案最新
- 时间:2026-09-25
-
- 蚂蚁庄园答案2026年9月26日
- 时间:2026-09-25
-
- 蚂蚁庄园今天答题答案2026年9月26日
- 时间:2026-09-25
-
- 今日小鸡庄园答案2026.9.26
- 时间:2026-09-25
-
- 蚂蚁庄园今日答案2026年9月26日
- 时间:2026-09-25
-
- 橡皮擦能擦掉铅笔字迹的原理是什么 蚂蚁庄园今日答案9.26
- 时间:2026-09-25
-
- 小鸡答题今天的答案是什么2026年9月26日
- 时间:2026-09-25