阿里Qwen音频模型登顶全球 语音AI迈入表演时代
时间:2026-07-21 | 作者:深海捕梦者 | 阅读:0阿里云发布语音合成大模型 Qwen-Audio-3.0-TTS:从“能说话”到“会表达”
2025年7月20日,阿里云正式发布语音合成大模型 Qwen-Audio-3.0-TTS。
它标志着语音合成技术从“能说话”向“会表达”的跨越。该模型在细粒度标签控制、freestyle指令遵循、多语种与方言覆盖以及复杂声学鲁棒性等方面实现了系统性提升。
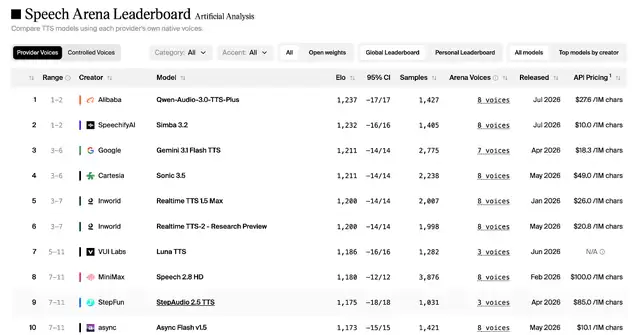
模型提供了两个版本:面向实时交互的 Flash版本(首包延时 300ms级别)和面向高质量生成的 Plus版本。目前,在全球第三方权威榜单 Artificial Analysis 上,Qwen-Audio-3.0-TTS-Plus 已斩获冠军。其预览版 Fun-Realtime-TTS 也曾在一个月前登顶该榜单。
细粒度标签控制:精确到“字”的情感表达
Qwen-Audio-3.0-TTS 的上一代版本已支持 freestyle(自由风格模式)。用户可以在提示词中加入“资深客服”、“足球解说员”等角色设定,以控制情绪、场景和语速等。新模型则在细粒度控制上实现了进一步跃迁。
通过 结构化标签,用户可以直接在文本中嵌入诸如 [gasp](抽一口气)、[giggles](轻笑)、[angry](愤怒)等标记。
控制精度从“整段情绪”细化到“哪个字后面该倒吸一口气”。这一能力特别适用于需要精确控制细节的叙事、游戏、配音等场景。
- 示例标签:[gasp](抽一口气)、[giggles](轻笑)、[angry](愤怒)
- 应用场景:叙事、游戏、配音等需要极致情感控制的领域
小提示:在实际应用中,可以结合 freestyle 模式与细粒度标签,实现更丰富的语音表达效果。例如,在对话中先设定“愤怒的客服”角色,再在特定词后加入 [angry] 标签,让语气更自然。
多语种与方言覆盖:16种语言 + 20种方言
面向全球多语种场景,Qwen-Audio-3.0-TTS 进行了专项优化,覆盖 中、英、日、韩、德等16种语言,并新增了阿拉伯语、越南语、马来语以及菲律宾语。
根据 CV3-Eval 的多语种基准测试,表现如下:
- 词/字错误率评测:在16种语言中,Qwen-Audio-3.0-TTS 家族在 10种语言 中获得了 SOTA(当前最优)。其中 韩语 和 马来语 的领先幅度最大。
- 说话人相似度评测:Qwen-Audio-3.0-TTS-Plus 在16种语言中全部获得最优。Flash版本 则包揽了 15项第二,其中 马来语、西班牙语 和 阿拉伯语 的领先幅度最为明显。
此外,针对方言发音容易滑向普通话腔的痛点,研究团队专门设计了 方言强化训练,让模型在韵律、声调与口语表达上接近母语者。目前,该模型覆盖了 广东、重庆、东北、陕西、上海、四川、云南等20种方言,确保方言发音的自然与地道。

语音克隆与鲁棒性:高噪声环境下的精准克隆
语音克隆产品通常要求原始参考音频在安静环境下录制。而 Qwen-Audio-3.0-TTS 通过 真实声学仿真训练,在克隆流程中嵌入了 语音增强能力。
这使得模型即使在 高噪声、高混响 的条件下,也能有效过滤干扰,仅保留目标音色,实现精准克隆。
- 技术亮点:真实声学仿真训练 + 语音增强能力
- 适用场景:嘈杂环境下的语音克隆、移动设备录音提取
精品音色库与音频质量:录音棚级别的输出
面向严肃创作场景,Qwen-Audio-3.0-TTS 拥有 开箱即用的精品音色库,并将音频输出采样率从 24kHz 提升至 48kHz。这相当于将视频配音和有声书的品质提升到了 录音棚、影视配音的规格。同时,单次语音合成可长达 3分钟,满足长文本生成需求。
版本与可用性:即刻调用
Qwen-Audio-3.0-TTS 提供两个版本:
- Flash版本:面向实时交互,首包延时 300ms级别
- Plus版本:面向高质量生成,具备顶级音质和表现力
即日起,两款模型已在 阿里云百炼 开放调用,用户可通过 API 或工具直接使用。
常见问题
-
问:Qwen-Audio-3.0-TTS-Plus 版本在哪些语言上表现最佳?
答:根据 CV3-Eval 说话人相似度评测,Plus 版本在16种语言中全部获得最优。在特定语言上,Flash版本也表现出色,例如马来语、西班牙语和阿拉伯语,领先幅度最为明显。
-
问:如何在实际项目中使用细粒度标签?
答:在文本中直接嵌入如 [gasp]、[giggles] 等标签即可。例如,输入“他惊讶地[gasp]倒吸一口气”,模型会在对应位置产生抽气效果。建议结合 freestyle 模式设定角色,以获得更自然的表达。
-
问:Flash 版本和 Plus 版本的主要区别是什么?
答:Flash 版本优化了低延迟,首包延时仅 300ms,适合实时交互场景(如语音助手、游戏对话)。Plus 版本则注重音质和表现力,输出采样率高达 48kHz,适用于影视配音、有声书等高质量内容创作。
总结
Qwen-Audio-3.0-TTS 的发布,标志着语音合成技术从“能说话”到“会表达”的跨越。
通过细粒度标签控制、多语种与方言覆盖、高噪声环境下的语音克隆以及录音棚级别的音频输出,它为用户提供了更自然、细腻和富有表现力的语音合成体验。
无论你是开发者、内容创作者还是普通用户,都能轻松上手。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- iQOO Neo5开启Super Audio音效教程
- 时间:2026-08-20
-

- AudioX-Turbo音频生成框架:Noiz AI联合清华推出
- 时间:2026-08-15
-

- Fish Audio 周年发布 S2.1Pro 实时对话语音模型支持耳语与情绪控制
- 时间:2026-08-13
-

- Qwen-Audio-Agent实时语音Agent框架解析与应用指南
- 时间:2026-08-13
-

- 阿里千问推出Qwen-Audio-3.0-ASR-Flash语音识别大模型
- 时间:2026-08-13
-

- Stable Audio部署实战:NVIDIA CUDA环境配置与测试
- 时间:2026-08-08
-

- Stable Audio GPU加速安装配置教程国内可用多用户版
- 时间:2026-08-08
-

- Stable Audio低配置电脑安装优化与API调用测试完整教程
- 时间:2026-08-08
精选合集
更多大家都在玩
大家都在看
更多-

- 蚂蚁新村小课堂今日答案10月23日 江苏溧阳的跳幡神是一种
- 时间:2026-10-23
-
- 蚂蚁新村2026年10月23日答案最新
- 时间:2026-10-23
-
- 蚂蚁庄园答案2026年10月24日
- 时间:2026-10-23
-
- 蚂蚁庄园今天答题答案2026年10月24日
- 时间:2026-10-23
-
- 蚂蚁庄园今日答案2026年10月24日
- 时间:2026-10-23
-
- 秦始皇陵地宫至今未发掘,主要原因是 蚂蚁庄园今日答案10.24
- 时间:2026-10-23
-
- 小鸡答题今天的答案是什么2026年10月24日
- 时间:2026-10-23
-
- 蚂蚁庄园每日答题答案2026年10月24日
- 时间:2026-10-23