摩尔线程万卡集群与端侧AI全栈创新亮相2026智源大会
时间:2026-07-22 | 作者:游戏探长 | 阅读:0第八届北京智源大会开幕,200余位顶尖学者齐聚
6月12日,第八届北京智源大会在中关村国际创新中心正式开幕。
这场大会的含金量极高。
现代数字安全体系奠基人Whitfield Diffie、强化学习奠基人Andrew Barto,以及200多位顶尖学者、40余位AI企业CEO及首席科学家、30余位青年科学家齐聚一堂。
最引人瞩目的是,中国AI产业在世界模型与Agent领域最具代表性的创新力量,首次集中同台亮相。他们围绕世界模型、通用智能体、具身智能、AI安全等前沿方向,展开了密集的精彩演讲和前瞻性对话。
摩尔线程深度参与,展示全栈创新成果
作为国内领先的国产全功能GPU企业,摩尔线程深度参与了这场年度盛会。
多位技术专家在多个论坛及Open Talk环节密集发声,系统展示了覆盖“云-边-端”全栈的软硬协同创新成果。
前沿技术亮相:万卡集群训练实践
在大模型产业论坛,摩尔线程发表了《面向大模型时代的智能计算:万卡集群大模型训练实践》的主题演讲。
当前,训练算力需求持续激增,集群规模越来越大,软硬件协同的复杂度也在不断攀升。
摩尔线程系统分享了基于国产万卡级智算集群夸娥(KUAE)的大规模分布式训练实践经验。
重点推出了一系列创新方案,包括:
- 基于静态分析的集群性能仿真工具
- 异步通信引擎通算并行优化方案
- 利用强化学习进行CUDA/MUSA算子自动生成的全新路径
这些成果为降低大模型训练调优成本、提升算子开发效率,提供了颇具参考价值的前沿范式。

编译架构创新:支撑多DSL的编译后端
在智算前沿-AI赋能系统论坛,摩尔线程带来了《TiLISA & MTX:打造支撑多DSL的编译后端》的技术分享。
团队围绕TiLISA与MTX指令集构建的统一编译后端,阐释了关键突破:
- TiLISA通过分块(Tile)计算抽象,突破传统SIMT编程模型以单线程为核心的局限,降低Tensor Core等新型硬件的编程复杂度。
- MTX作为面向国产全功能GPU的底层虚拟指令集,具有独特价值。
- 通过兼容Triton等前端语言,这套方案解决了核函数跨架构移植的老大难问题。
该方案为打破算子开发效率与性能可移植性之间的“双重壁垒”,拿出了切实可行的解决思路。

智能体算力本:AIBOOK全面升级
在Open Talk环节,摩尔线程重点分享了MTT AIBOOK的全面升级。
作为一款“为智能体而生”的AI算力本,AIBOOK在MTT AIOS原生Linux系统下预装了OpenClaw智能体。
单机就能支持多达12个智能体高效并行运行,实现了智能体应用开发、调试与部署的完整闭环。
得益于“工具直达”特性,AIBOOK提供了90+工具调用能力,大幅降低了配置成本。
更值得关注的是,它支持原生Linux、虚拟Windows以及容器化Android多系统,并预置了包括LLM在内的多种本地模型。一台设备就能覆盖多场景AI开发与应用需求,典型场景适应性极强。
全栈产品矩阵亮相,覆盖云边端核心场景
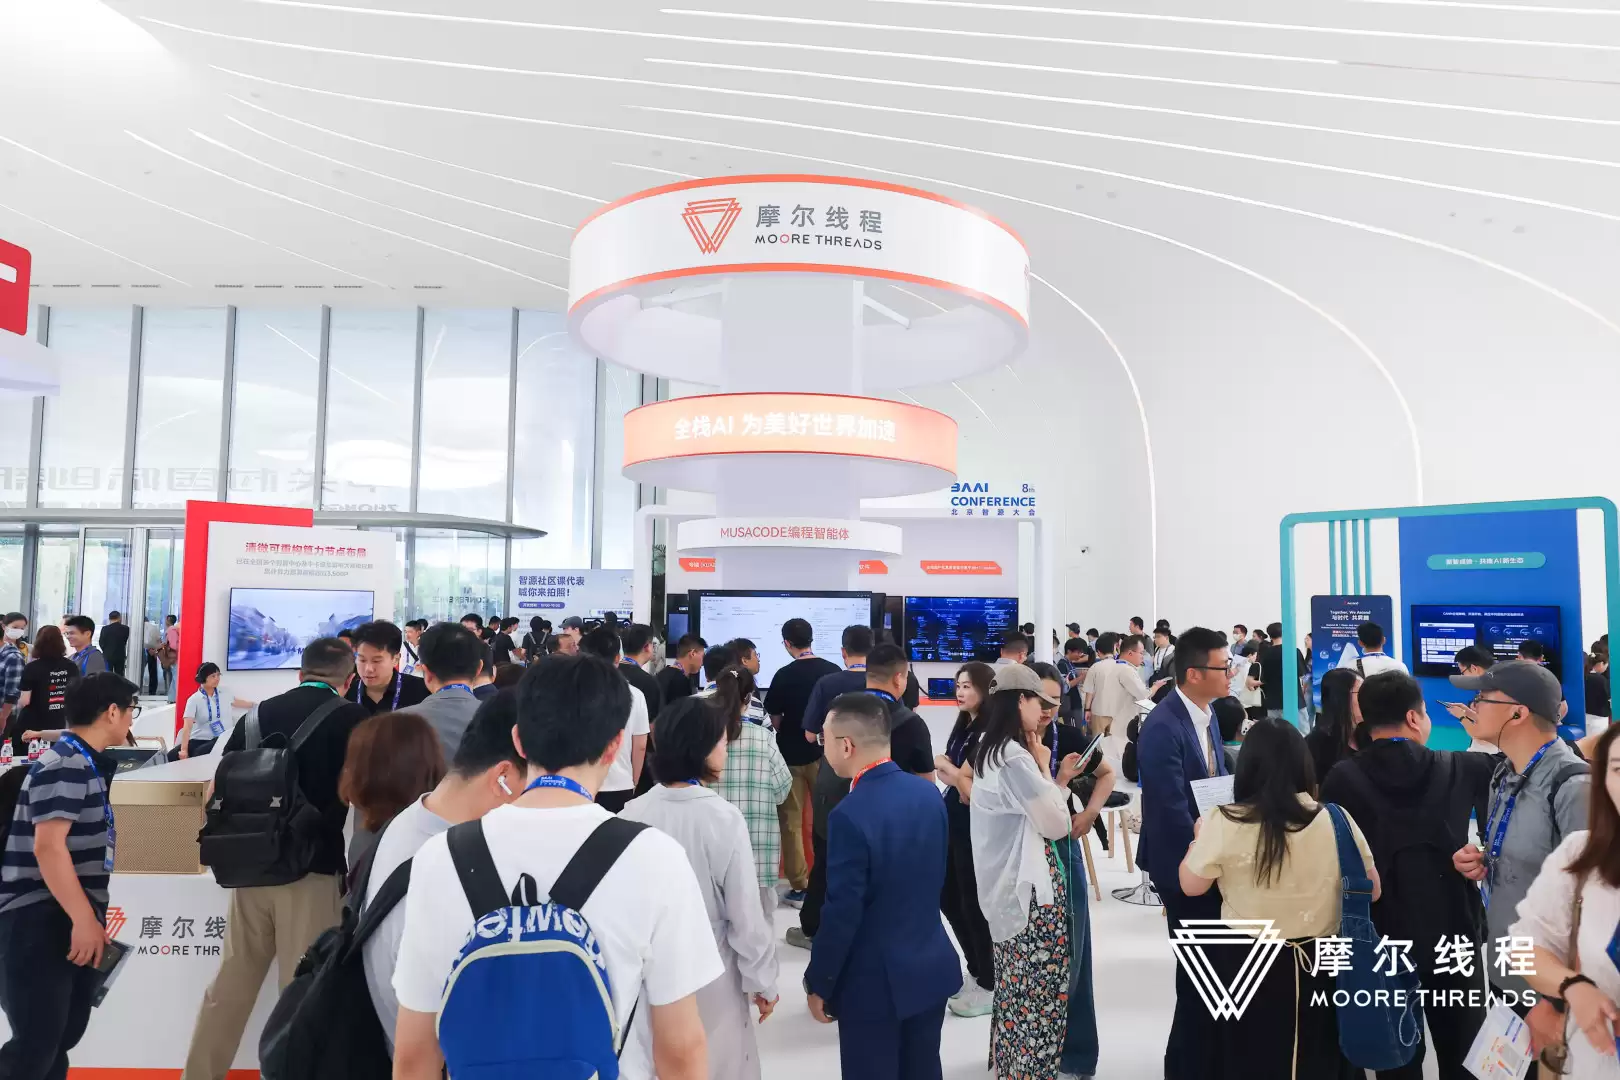
展台现场,摩尔线程携全栈产品矩阵亮相,全面覆盖云、边、端核心场景。
云端重点展示:
- 面向万亿参数大模型训练的夸娥万卡智算集群
- AI训推一体智算卡MTT S5000
- AI大模型训推一体机MTT SGX5000
端侧则呈现:
- AI算力本MTT AIBOOK
- 家庭AI中枢MTT AICUBE
- 边缘AI计算模组MTT E300
此外,还同步展出了首个全栈具身智能仿真平台MT Lambda与国产生命科学智能计算解决方案,形成了从底层算力到上层应用、从技术赋能到生态共建的完整布局。
与智源研究院深度合作,多项标志性成果落地
作为国产算力的中坚力量,摩尔线程与智源研究院保持着长期紧密的合作关系,并已取得多项标志性成果。
2025年1月:完成具身大脑模型端到端训练
双方基于MTT S5000千卡智算集群与FlagOS-Robo框架,成功完成了具身大脑模型RoboBrain 2.5的完整端到端训练与对齐验证。
训练Loss曲线与国际主流产品基线高度一致,相对误差仅为0.62%以内,线性扩展效率超过90%。这充分验证了全功能GPU作为国产算力底座的可靠性。
2025年3月:联合完成AI训练“全要素”验证
双方基于MTT S5000实现了Qwen3-0.6B的端到端无中断训练。
精度甚至超越国际主流基线1.65个百分点,这标志着国产全功能GPU在大模型训练中已经迈向了“更优”的水准。
2025年4月:实现DeepSeek-V4 Day-0适配
双方依托MTT S5000原生FP8引擎与FlagOS全栈软件体系,在DeepSeek-V4系列发布之际,便实现了Pro和Flash双模型的Day-0适配,并发布了开箱即用的国产化部署镜像,持续推动国产大模型生态建设的进程。
持续夯实国产算力底座,推动AI技术突破
从千卡集群训练具身大脑,到万卡智算工程实践;从底层编译架构创新,到软硬协同全栈落地——摩尔线程以全功能GPU为核心,依托从芯片、集群到软件栈的全面自主能力,与智源研究院及众多产业伙伴一道,正在持续夯实国产算力底座,为前沿科研与产业创新提供坚实支撑,共同推动人工智能技术实现突破与高质量发展。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 月端侧AI推理趋势:模型压缩、框架与硬件协同演进
- 时间:2026-08-21
-

- 端侧AI认知模型迎来黑马:4B性能打平GPT-5.4
- 时间:2026-08-21
-

- 华邦电子端侧AI存储架构突破瓶颈的方法
- 时间:2026-08-13
-

- 端侧AI的卡点并非内存,真正原因是什么
- 时间:2026-07-25
-

- 世界人工智能大会 瑞迅RK3588+RK1828方案助力下一代端侧AI
- 时间:2026-07-21
-

- 面壁智能CTO曾国洋:端侧AI从打字机到大模型的进化与突围
- 时间:2026-07-19
-

- 高通MWC 2026连发重磅产品,全维加码AI与下一代通信
- 时间:2026-03-03
精选合集
更多大家都在玩
大家都在看
更多-

- 糖尿病完全不能吃糖吗
- 时间:2026-09-15
-
- 蚂蚁庄园小课堂2026年9月16日最新题目答案
- 时间:2026-09-15
-
- 小鸡答题今天的答案是什么2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园每日答题答案2026年9月16日
- 时间:2026-09-15
-
- 以下哪种粮食是酿造绍兴黄酒的主要原料 蚂蚁庄园今日答案9月16日
- 时间:2026-09-15
-
- 劝学名句“及时当勉励,岁月不待人”出自哪位诗人 蚂蚁庄园今日答案9.16
- 时间:2026-09-15
-
- 蚂蚁庄园今天答题答案2026年9月16日
- 时间:2026-09-15
-
- 蚂蚁庄园答题今日答案2026年9月16日
- 时间:2026-09-15