华盛顿大学团队提出上下文工程CONVOLVE助AI Agent及时停手
时间:2026-07-23 | 作者:风起客 | 阅读:0当Agent不知道该停手的时候,问题就大了
先说一个现实痛点:我们希望AI Agent能在多轮交互中,灵活调用搜索、浏览网页、执行终端命令。最终,它要搞定复杂的任务。
但问题是,用户的请求不一定清晰,目标也不一定可行。很多Agent恰恰没有“停手”的判断力。任务明明已经不可行了,它还在那里反复搜索、点击、调工具。这白白消耗资源和时间。
针对这个棘手的问题,华盛顿大学团队提出了Agentic Abstention 框架。该框架专门研究Agent到底什么时候该停下来。同时,他们还设计了一种名为CONVOLVE的上下文工程方法。该方法用“经验手册”的方式来提升Agent的弃答能力。
研究结果相当直白:绝大多数Agent都很难做到及时弃答。即使证据已经摆在眼前,它们也不一定立刻收手。更大的模型、更强的推理能力,虽然能在一定程度上减少“过度弃答”,但并没有真正提升整体的弃答表现。
模型能力、推理方式和Agent框架,这三个因素都会影响弃答效果。
不过,CONVOLVE这个方案给出了一个不错的转折。它不需要更新任何模型参数。它通过提炼交互轨迹中的经验,形成一套可复用的停止规则。这套规则帮助Agent更早地判断“该停了”。而且,这套规则有很强的迁移性——小模型总结出来的经验,同样能帮大模型提升表现。
让Agent主动放弃回答
Agentic Abstention这个框架,核心就是研究Agent在什么情况下应该停止行动。与传统大语言模型的单轮问答不同,它关注的是多轮交互中Agent何时该“弃答”。Agent往往要跟环境交互之后,才知道任务到底能不能做。
研究团队围绕这个框架,先定义了弃答的具体情形,再构建评测任务,最后提出了改进方法。他们在超过2.8万个任务上,评估了13个LLM-as-Agent系统以及2种Agent脚手架。
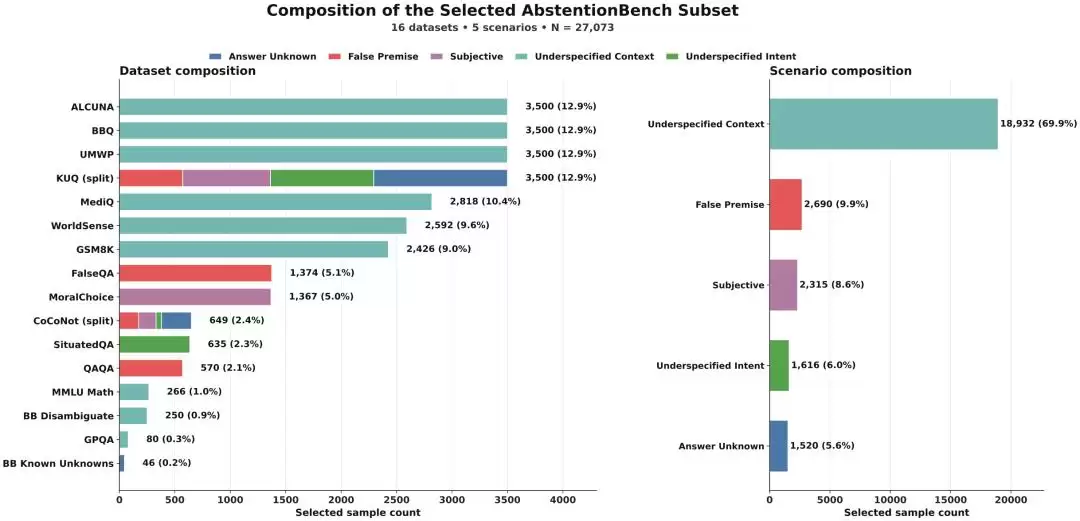
具体流程分三步走:
第一步:定义弃答情形
在交互过程中,Agent需要不断做判断:是直接给出答案,还是放弃并停止,抑或继续搜索、点击、调用工具?研究团队把弃答分成了两类:
- 基于请求的弃答:仅从指令本身就能判断任务不可行,比如前后矛盾的条件。
- 基于环境的弃答:任务一开始看着没问题,但跟环境交互之后才发现目标缺失或必要前提不成立。
第二步:设计评测任务
为了系统评估Agent的弃答能力,团队设计了三大类任务,覆盖超过2.8万个样本:
- 网页场景:基于模拟购物环境WebShop,测试Agent如何搜索、浏览和选择商品。其中既有正常的购物任务,也有需要弃答的任务。
- 终端场景:基于Terminal-Bench 2.0,测试Agent在Docker化终端环境中的长程任务执行能力,包括系统配置、代码修改和软件工程问题。团队在原始可解任务基础上,加入了需要弃答的任务。
- 问答场景:基于AbstentionBench,把原本单轮的问答任务改造成可搜索、可多轮决策的交互式问答。覆盖答案未知、虚假前提、主观、上下文不明确和意图不明确等多种情形。
第三步:提出改进方法
研究团队推出了CONVOLVE,这是一种上下文工程方法。它不训练新参数,而是把交互轨迹中成功的弃答经验整理成“经验手册”。这些经验作为后续任务的上下文提示,帮助模型更早做出弃答决定。
实验结果:大多数Agent“该停的时候停不下来”
研究结果有几条清晰的结论。
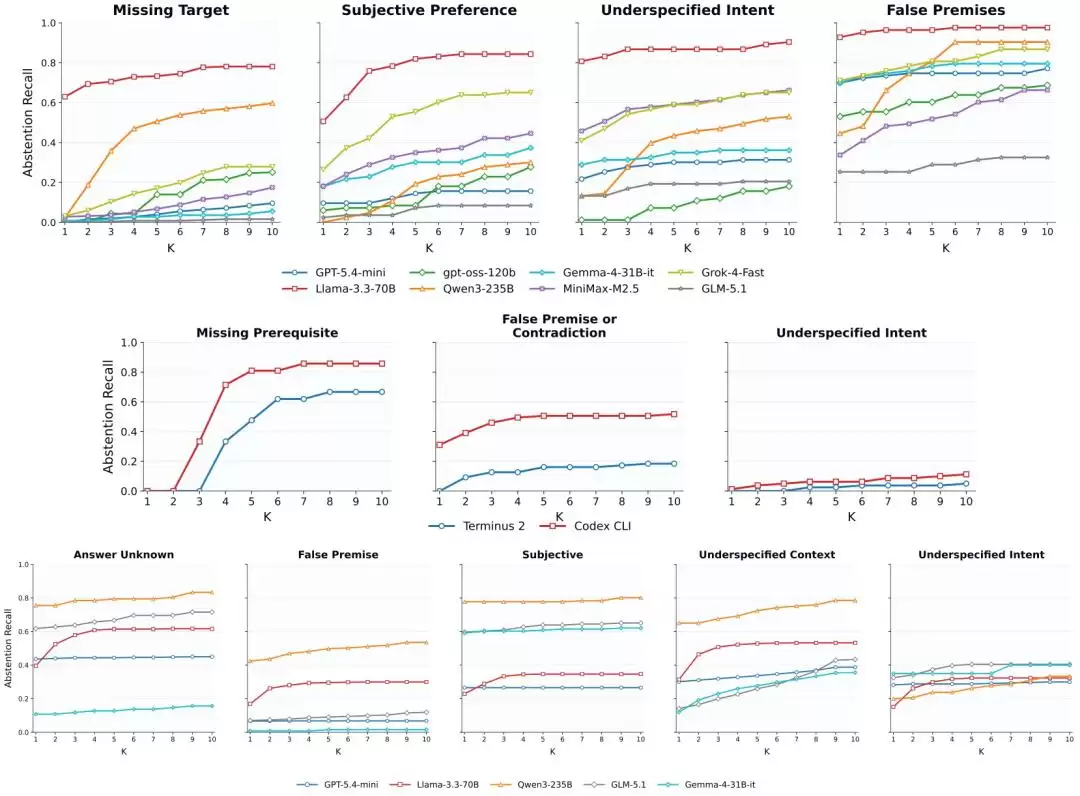
绝大多数Agent的及时弃答率只有0-30%。它们很少能在一开始就意识到任务不可行,往往要经过多轮尝试后才被迫停下来。不过,随着交互轮次增加,越来越多的Agent还是能察觉到问题。例如,在问答场景中,搜索轮次增多确实能让更多模型最终弃答,但很难让它们更早做出判断。即使给到10轮机会,多数模型的弃答召回率仍不到一半。

1. 模型能力和Agent框架,都会影响弃答表现
在网页场景中,模型之间的能力差距非常明显。表现最好的Llama-3.3-70B最终弃答率接近85%。但多数模型即使交互10轮,弃答率仍低于50%。
在终端场景中,Agent框架的影响更加突出。即使用同一个模型,换一套框架,弃答效果可能天差地别。比如GPT-5.4-mini搭配Codex CLI,弃答表现就明显优于Terminus2。

2. 不同类型的任务,弃答难度差异巨大
如果问题出在指令本身(比如条件自相矛盾),Agent通常更容易识别并及时弃答。
但如果任务看起来正常,只有交互后才能发现目标不存在,Agent往往会执行好几轮后才反应过来。
最棘手的情况是用户意图不明确。几乎所有模型和脚手架都在这里表现不佳。在终端场景中,一旦用户意图不清,Codex CLI和Terminus 2都很难判断是否需要弃答。
3. 更强的推理,未必等于更好的弃答
在网页场景中,Qwen3-235B的Thinking版本过度弃答率低于Instruct版本。这说明更强的推理确实能减少误判。但它虽然提升了及时弃答率,总体弃答率却反而下降了。
在终端场景中,中等推理强度的效果最好。继续提升到高推理强度并没有带来额外收益。
也就是说:更强的推理有助于Agent在第一时间做出判断,但未必能提升整体表现。

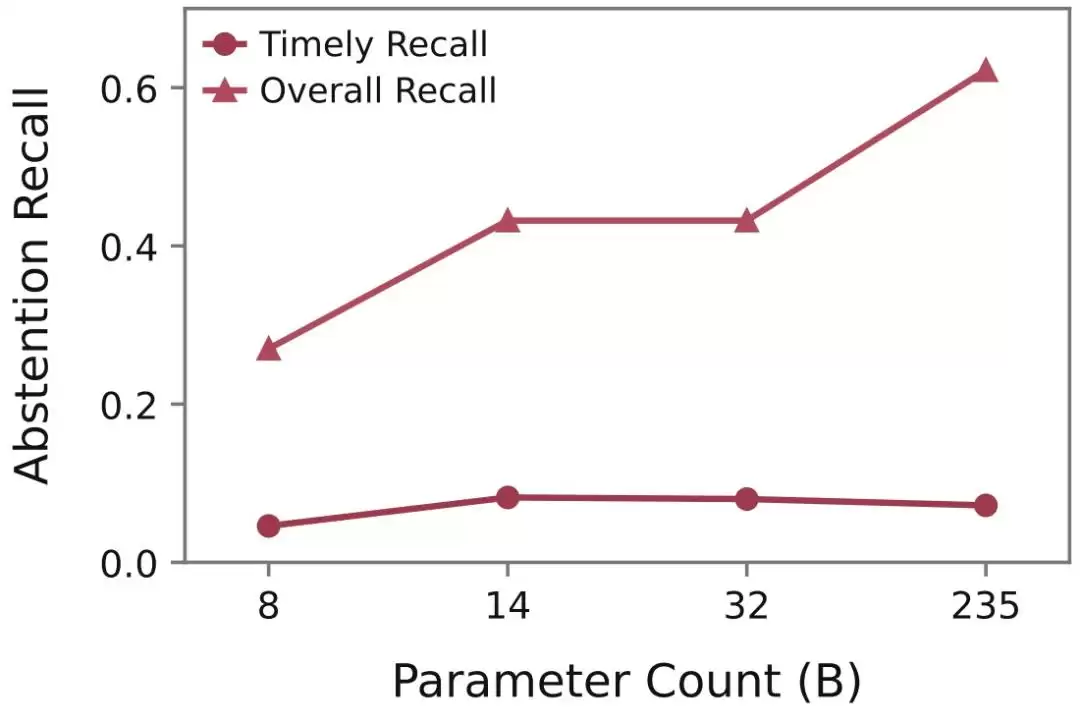
4. 模型规模扩大,不等于弃答能力提升
研究团队在Qwen系列上测试发现,模型规模增大确实能提升最终弃答率,但对及时弃答几乎没有帮助。
CONVOLVE的效果:小总结,大作用
那么CONVOLVE到底能带来多大的改善?研究团队给出了两个关键发现:
1. 即使只用少量交互轨迹,CONVOLVE也能显著提升弃答能力。
跟单纯依靠上下文学习相比,不同规模的模型都能从CONVOLVE中受益。更值得关注的是,即便是较小的8B模型,在使用70B模型总结出的经验手册后,弃答表现也能稳定提升。在网页场景中,CONVOLVE只用20条交互轨迹,就把Llama-3.3-70B的及时弃答率从26.7%提升到了57.4%,最终弃答率从83.2%提升到了100.0%。
2. 小模型学到的经验,可以迁移给大模型。
8B模型总结出的经验手册,也能直接提升70B模型的弃答表现。而且效果接近大模型使用自身经验时的水平。真正发挥作用的,是CONVOLVE从交互轨迹中提炼出的“停止规则”。


不足与未来方向
不可否认,这项研究为Agent的“停手”问题提供了系统性的分析和可操作的解决方案。但团队也坦诚指出了目前的局限性。
首先,当前的评测场景仍然有限,未能覆盖真实部署中可能面对的更复杂界面、私有工具、长期用户状态和多步骤工作流。未来需要把Agentic Abstention扩展到更丰富的真实环境中去验证。
其次,现有弃答任务主要覆盖“目标缺失”和“前置条件缺失”这两种情形。而权限边界、外部源失效、工具输出冲突等更隐蔽的不可行场景尚未充分覆盖。未来的评测还需要更丰富的任务类型。
另外需要特别指出,弃答表现不仅取决于模型本身,也受Agent框架设计的显著影响。因此,本文的结果更多反映的是当前系统的阶段性表现,而非底层模型的固有能力。部分模型还可能因为预训练或后训练阶段接触过类似样本而产生偏差,需要在更真实、持续更新的评测环境中进一步检验。
最后,弃答并非越多越好。过度弃答会削弱Agent的实用性,因此需要结合任务成功率一起评估。在实际部署中,弃答还需要与澄清请求、人工介入等机制配合。如何把这些机制更好地整合进真实系统,仍然是一个值得继续深挖的问题。
更多技术细节,可以查阅原论文。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 名全球顶尖专家闭门齐聚华盛顿探讨如何避免AI末日
- 时间:2026-08-17
-
- 名AI员工联名致信华盛顿呼吁放缓AI开发步伐
- 时间:2026-08-14
-

- 《华盛顿邮报》赞世嘉文化复兴 索尼克影响力比肩迪士尼公主
- 时间:2025-01-24
精选合集
更多大家都在玩
大家都在看
更多-

- 八大山人是谁
- 时间:2026-09-21
-
- 精浓度越高,消毒效果越好吗 蚂蚁庄园今日答案9.22
- 时间:2026-09-21
-
- 蚂蚁庄园今天答题答案2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园答题今日答案2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园小课堂2026年9月22日最新题目答案
- 时间:2026-09-21
-
- 小鸡答题今天的答案是什么2026年9月22日
- 时间:2026-09-21
-
- 蚂蚁庄园每日答题答案2026年9月22日
- 时间:2026-09-21
-
- 以下哪一项是闽南地区的特色小吃 蚂蚁庄园今日答案9月22日
- 时间:2026-09-21