WorkBuddy作为运维助手的5个实战场景
时间:2026-07-25 | 作者:半糖攻略君 | 阅读:0WorkBuddy运维实战:五大场景揭秘,IT运维效率如何翻倍
研究AIOps有一段时间了,手里积累了不少可落地的方案。腾讯的WorkBuddy早在今年3月就已发布,与Claude Code、Codex属于同一类产品。但因为是商业软件,此前一直没条件去测试它在运维场景中的真实表现。最近看到它的月活跃用户已达两千万,看来在国内用户中越来越受认可。于是,花了两天时间安装并深度使用,将五个核心运维场景的实战感受整理出来,供各位参考。 需要说明的是,以下场景均假设已为WorkBuddy配置好相关服务器权限。这一环节可通过Ansible MCP来完成。场景一:智能巡检
**过去的做法:** 每周一早上,登录每台机器,依次敲 `df -h`、`free -m`、`uptime`,盯着输出记到Excel里。20台机器,一上午就没了。 **现在让WorkBuddy来做:** 只需下达一条指令,它便会自动连接服务器,检查磁盘、证书、接口,最终将报告整理好发送到邮箱。你只需要打开邮箱,标红的地方重点看,绿色的直接跳过。 ``` 帮我巡检一下生产环境的所有服务器,检查以下内容: 基础设施: - 磁盘使用率,超过 80% 的列出来 - 内存和 CPU 使用率,持续超过 80% 的列出来 - 系统负载,超过 CPU 核数 2 倍的列出来 安全: - 所有 SSL 证书,30 天内过期的标黄,7 天内过期的标红 - 检查最近 7 天有没有新增的 cron 任务或系统服务 - 检查 /tmp 和 /var/tmp 下有没有可疑文件 应用: - 检查所有核心服务的 /health 接口 - 检查数据库连接池使用率 结果整理成报告,按严重程度分 CRITICAL / WARNING / INFO 三级,发到我邮箱。 ```场景二:故障排查
**过去的做法:** 线上告警来了,用户反馈接口响应变慢。打开监控大盘,翻日志,查调用链,再问开发有没有变更,折腾二三十分钟才能定位根因。 **现在让WorkBuddy来做:** 它会自动调用监控API、查询日志系统、拉取变更记录、比对指标。几分钟后把排查报告呈现在你面前。哪个指标最先跳变,哪个日志开始报错,谁改了什么东西,时间线清晰可见。 ``` 帮我查一下这个告警:订单服务接口响应时间飙到 5 秒了。 做以下几件事: 1. 查一下这个服务最近 15 分钟的 CPU、内存、GC 情况 2. 查一下最近 15 分钟的错误日志,按错误类型归类 3. 查一下这个服务最近 24 小时有没有发版或者改配置 4. 查一下它依赖的数据库和中间件最近有没有异常 把以上信息整理成一份排查报告,告诉我: - 什么时间开始出问题的 - 变化最大的指标是哪些 - 最可能的根因是什么 - 下一步怎么验证 ```场景三:复杂操作——SSL证书续期
**过去的做法:** SSL证书快过期了,得生成CSR、提交CA、下载证书、上传服务器、改Nginx配置、reload服务、检查OCSP。如果涉及多台服务器、多个域名,半天时间就搭进去了。 **现在让WorkBuddy来做:** 扫描所有证书,列出即将过期的,自动走续期流程,部署到服务器,reload服务,验证生效。你只需要看最后的执行报告。 ``` 帮我检查一下所有线上服务的 SSL 证书状态。 看看哪些证书在 30 天内过期,列个清单给我。清单里要包含: - 域名 - 颁发机构 - 过期时间 - 部署在哪台服务器的哪个 Nginx 配置里 对 7 天内过期的证书,自动走续期流程: 1. 调用 Let's Encrypt API 申请新证书 2. 自动做 DNS 验证 3. 下载证书并部署到对应服务器 4. 更新 Nginx 配置并 reload 5. 验证新证书是否生效 6. 每一步都要记录日志,失败了马上通知我 ```场景四:变更影响分析
**场景描述:** 上线前,开发说“我就改了一行配置”。但这一行改了会影响谁?会不会导致连锁故障?以前全靠经验猜。 **现在让WorkBuddy来做:** 它会自动查询配置中心的历史、调取服务拓扑图、拉取变更记录,生成一份风险评估报告。拿着这份报告,你可以明确告诉开发:“这个改动影响3个下游服务,建议先灰度10%的流量,观察15分钟,重点看这几个指标。” ``` 帮我分析一下这个变更的影响范围:order-service 的数据库连接池配置要改,从 100 改到 200。 查一下: 1. order-service 还被哪些服务调用了? 2. 下游服务有没有降级机制? 3. 这个配置以前改过没有?改完出过问题吗? 4. 如果改完后 order-service 挂了,会影响哪些链路? 给一份风险评估报告,包含: - 直接影响的服务 - 间接影响的服务 - 建议的灰度步骤 - 回滚操作是什么 - 上线后重点看哪些指标 ```场景五:日常琐事自动化
**场景描述:** 运维每天都有各种“小活”:查一下某个IP的流量、看某个端口通不通、查一下最近有没有报错、看看谁在线上做了操作。单独都不难,但架不住一天来几十次。 **现在让WorkBuddy来做:** 把这些做成一个快捷指令集,以后说人话就能查。群里有人问“帮我查一下某某”,直接让WorkBuddy跑一遍,结果甩过去,不用自己登机器、敲命令。 ``` 把这些做成一个快捷指令集,以后我说人话就能查: 网络类: - "查一下 10.0.0.1 的 8080 端口通不通" - "看看这个 IP 最近的流量趋势" - "解析一下这个域名" 日志类: - "帮我看看最近 1 小时的 500 错误" - "查一下这个 traceId 的完整调用链" - "这个错误码最近出现过多少次" 审计类: - "查一下张三今天在线上干了什么" - "看看这个配置谁改过" - "这台服务器最近谁登录过" 报告类: - "今天系统状态怎么样" - "这周出了哪些故障" - "这个月的 SLA 是多少" 每个指令执行完,直接把结果返回给我。 ```用好WorkBuddy做运维的核心要点
1. 需求讲明白
把它当成一个经验丰富的工程师。它很聪明,但不会猜你想要什么。派任务时务必说明白需求,约定好边界。
2. 把异常情况说清楚
“失败了通知我”太模糊。“失败了把错误详情发我,如果连续失败3次就停掉,等我人工处理”——这才是生产可用的指令。
3. 每次执行都要有记录
跑完就完了?不行。结果记在哪、日志格式是什么、失败了有没有痕迹——没有日志的操作等于没发生。

免责声明:文中图文均来自网络,如有侵权请联系删除,心愿游戏发布此文仅为传递信息,不代表心愿游戏认同其观点或证实其描述。
相关文章
更多-

- 字节跳动发布豆包工作 与飞书深度打通构建企业级Agent
- 时间:2026-08-25
-

- AI通话录音手机续航实测能用多长时间
- 时间:2026-08-23
-

- Adobe Photoshop 27.7桌面版发布 移除工具支持端侧AI运行 苹果Mac需24GB内存
- 时间:2026-08-23
-

- 育碧远哭7测试AI生成画面效果 知情者评价其表现不佳
- 时间:2026-08-23
-
- AMD锐龙9 PRO 9965X3D及锐龙AI PRO 400商用台式机2026Q3上市
- 时间:2026-08-22
-
- 思必驰冲刺上市,AI语音行业护城河为何消失
- 时间:2026-08-21
-
- 道题看懂AI商业趋势与未来发展方向
- 时间:2026-08-21
-
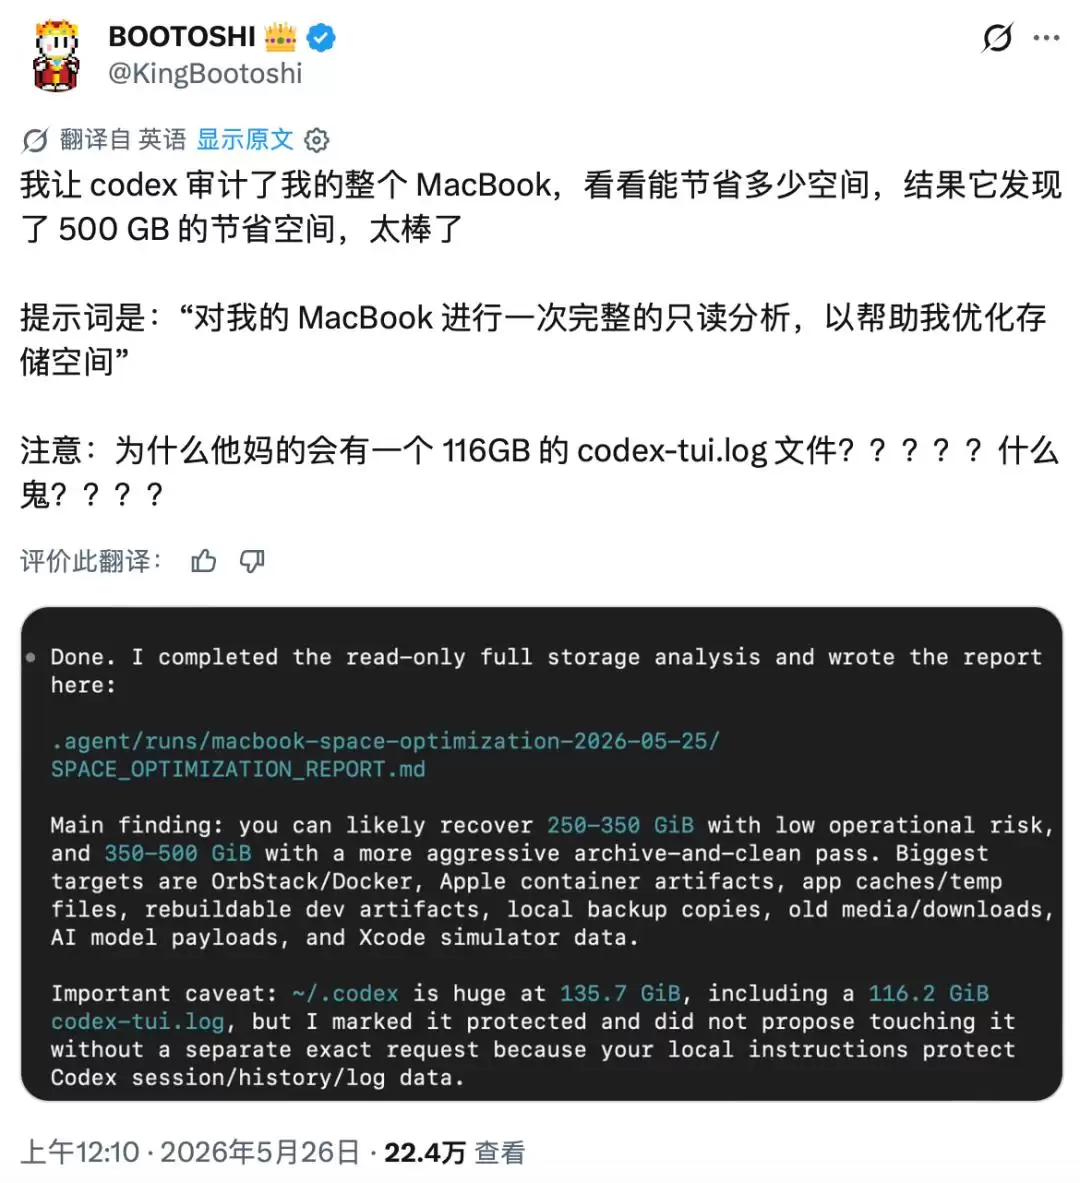
- AI清理500GB空间实测:Agent暂时还替代不了电脑管家
- 时间:2026-08-21
精选合集
更多大家都在玩
热门话题
大家都在看
更多-

- 精浓度越高消毒效果越好吗
- 时间:2026-09-22
-
- 蚂蚁庄园每日答题答案2026年9月23日
- 时间:2026-09-22
-
- “秋高气爽”主要是由于秋季空气中哪种成分减少 蚂蚁庄园今日答案9月23日
- 时间:2026-09-22
-
- 农谚“一场秋雨一场寒”描述的是秋季哪种天气现象 蚂蚁庄园今日答案9.23
- 时间:2026-09-22
-
- 蚂蚁庄园今天答题答案2026年9月23日
- 时间:2026-09-22
-
- 蚂蚁庄园答题今日答案2026年9月23日
- 时间:2026-09-22
-
- 蚂蚁庄园小课堂2026年9月23日最新题目答案
- 时间:2026-09-22
-
- 小鸡答题今天的答案是什么2026年9月23日
- 时间:2026-09-22